Como Treinar sua de IA: A Teoria por trás de LLMs, Fine-Tuning e Agentes | Workshop Impact Hub 5/6
A comprehensive workshop on LLMs covering their structure, pretraining at massive scale (terabytes of data, thousands of GPUs, millions in costs), and the Transformer architecture. The speaker explains fine-tuning as an empirical fix for model failures, real-world examples from Netflix and Google Photos, and the "Mono State" strategy combining large and specialized smaller models for specific tasks.
Chapters
Beleza, pessoal, eu vou pedir licença agora, uma desculpa antecipada, vou tentar ser menos técnico possível, mas eu gostaria de passar um conteúdo aqui um pouquinho mais aprofundadinho, tá? O que que é? Modelo de linguagem, eu vou explicar bem rapidamente como é que funciona para vocês entenderem porque que a ligação aqui da Prospecta, ela inventou as coisas ali sem saber. Sem mesmo saber que ela não tinha as ferramentas para fazer o que ela estava falando que ia fazer. Então, para a gente chegar nisso rapidinho, eu vou explicar para vocês como é que funciona. O que é um modelo de linguagem? Modelo de linguagem grande, ele basicamente são dois arquivos. Um arquivo de parâmetros e um arquivo de interpretação, que vai interpretar esses parâmetros. Dentro desses parâmetros é onde está todo o conhecimento. Esse conhecimento é destilado de algum lugar, normalmente da internet inteira. A gente destila, pega esses conhecimentos e a gente faz aquele cálculo para poder descobrir a próxima palavra milhões e milhões de vezes, bilhões e trilhões de vezes, até que a gente consiga ter um arquivo menor possível e que consiga seguir e gerar as coisas de uma maneira massa para a gente. E a gente precisa de um arquivo que vai conseguir interpretar isso. Como que esse modelo foi treinado? Como que a gente faz para essa multiplicação gerar um resultado no final, tá? Para desmistificar, isso é um modelo de linguagem, não é uma, sei lá, um ET de outro planeta, nada assim. Foram pessoas muito inteligentes que inventaram como fazer, descobriram, e vale dizer isso também, que é bem conhecido mais fora do Brasil do que aqui no Brasil, mas que toda descoberta em inteligência artificial, ela vem de forma empírica, e de origem empírica. O que é? A gente teve uma ideia, a gente foi lá, fez a ideia, testamos a ideia e funcionou. É assim que você descobre coisas com inteligência artificial. Hoje não tem ainda uma IA que ela consegue fazer as próprias descobertas, breakthroughs, ainda não tem. Não estamos ainda nesse nível onde uma própria IA consiga fazer as melhorias dela mesma. Então, ainda depende hoje da criatividade humana para fazer isso aqui. A gente chegou até aqui, chegamos até aqui. Então, esse modelo, tá, que é basicamente dois arquivos, eles não dependem de internet, eles não dependem de pesquisa na internet, eles não dependem de nada, eles têm tudo o que eles precisam em dois arquivos, beleza? Um arquivo de interpretação, um código, e um arquivo de conhecimento. Não precisamos de nada a mais para isso. Porque tudo o que a gente quer já está ali dentro. Você consegue rodar num computador, no seu notebook, seu MacBook, num servidor, em qualquer lugar. Beleza? Como que a galera faz esses modelos? Existem um processo, que é o que eu vou explicar agora, é um processo de pré-treinamento. Nesse processo, a gente pega o maior número de dados possível, o que a gente tem interesse, e a gente vai utilizar esse dado para que essa IA consiga aprender em cima dele. A gente pega esse montão de dados, no exemplo aqui, 10 terabytes de texto da internet, a internet inteira, a gente vai pegar uma cacetada de placas de vídeo, por isso que a NVIDIA hoje é, acho que é a maior empresa, né? Mais valorizada, eu acho. Então, por isso, tá? O que aconteceu com a NVIDIA? 5 anos atrás não tinha isso, agora tem isso. Então, a NVIDIA hoje é maior que todo mundo. Porque ela, na corrida do ouro, ela está vendendo as passes, né? Ela está vendendo essas coisinhas aqui que se chamam placas de vídeo, que é a peça, o hardware que consegue rodar esse cálculo que precisa fazer para a IA funcionar. Por que que no computador ela roda, mas a gente precisa disso que é um negócio específico? No computador, a gente tem a CPU, onde a gente roda os programas, as coisas assim, ela consegue fazer multiplicações, ela consegue fazer cálculos, mas ela não faz de uma maneira tão otimizada e tão rápida quanto uma placa de vídeo. Então são arquiteturas totalmente diferentes e são chips diferentes. Então hoje a NVIDIA faz isso, tem a AMD, tem outras empresas, mas a NVIDIA é a principal e ela tá despontando aí, provavelmente vai ser muito, muito grande, muito rica. Para você fazer um treinamento, por exemplo, de um modelo do zero, então não tenho nada, zero, modelo zero, quero treinar esse modelo que vai fazer ligação. Você precisa de muito texto, muito dados, você precisa de muita placa de vídeo e muita grana. Então aqui tem um exemplo, 2 milhões de dólares para você conseguir utilizar 6 mil placas de vídeo por 12 dias full time. Isso aqui dá mais ou menos, se eu não me engano, 3 dólares por hora por placa de vídeo, mais ou menos isso. Então a galera gasta muita grana. E isso aqui, gente, é um número de 2023. Então, modelos de 2023, gente, não tem nada parecido com o que a gente tem hoje. Então, na ordem de milhares disso aqui, tá? Para você conseguir desenvolver modelos do zero, modelos grandes, tá? Então, o modelo aqui de 70 bilhões de parâmetros tem 140 GB, porque cada um desses parâmetros eles têm 2 bytes, tá? Então, 140 GB. Então, um modelo, por exemplo, de 1 trilhão de parâmetros, 3 trilhões de parâmetros, isso é bem grande. É um modelo muito, muito grande mesmo, tem muito dado dentro dele. Então, só para você fazer um paralelo, se 10 terabytes de texto eu consigo reduzir em 10 vezes, praticamente, dando uma arredondada, 10 terabytes eu consigo fazer um modelo de 140 gigas aqui, quase uma redução aí de 10. Para a gente fazer um modelo que é trilhões de parâmetros, quanto de dados que eu preciso? Para vocês terem uma noção do que essas empresas fazem de coleta de dados. Beleza. Então a gente sabe que a gente precisa muito, muito dado e a gente sabe o que esses modelos fazem. A única função deles é descobrir qual é a próxima palavra. Então, no treinamento, a gente mostra um bloco de texto E a gente tendo a fazer esse modelo, prever como completar aquilo ali e a gente avalia, tá? Como ele vai aprendendo, como ele vai avaliando, a gente vai reduzindo a perda dele e assim vai abaixando uma nota que a gente dá do aprendizado e ele vai sabendo que ele está aprendendo, ele está conseguindo captar aquele conhecimento para dentro dele e está entrando naquele arquivo de parâmetros que a gente falou, tá? Como que funciona? Isso aqui é um negócio que eu tinha mostrado lá para a galera da Unifique. Vamos supor que vocês têm a empresa de vocês na Wikipédia e aí a gente quer, inclusive façam isso, todas as empresas de IA usam Wikipédia. A gente quer então que esse modelo ele aprenda sobre a Unifique, ele aprenda sobre uma empresa. E aí ele vai a primeira vez, ele vai ler tudo: a Unifique Telecomunicações S.A., apóstrofo, sei lá qual o nome desse negócio, Unifique, "É uma empresa brasileira de telecomunicações com sede em Timbó, blá blá blá, fundada em tal, tal, tal..." Ela vai ver isso algumas vezes. Daqui a pouco a gente vai tirar um pouquinho. A gente vai tirar um pouquinho. No final desse processo, ela vai conseguir reconstruir esse texto do zero, baseado só em algumas informações que ela reteve. Então eu marquei aqui em vermelho alguns exemplos. Para, por exemplo, reconstruir isso aqui, ela provavelmente ia decidir que ela precisa reter o nome, Ela precisa reter de onde é, ela precisa reter o ano, ela precisa reter o que elas fazem. Isso aqui é um exemplo, tá? Ela viu todos os artigos de Wikipédia da internet do mundo inteiro, são trilhões de artigos. Porque ela viu tanto, ela sabe como esses artigos são escritos, como eles são feitos. Então eu não preciso guardar todos os dados de todos os artigos, eu guardo só um pouquinho de cada um e eu consigo juntar eles e reconstruir esse artigo. O que aconteceu na ligação então? Ela viu transcrições de ligação e ela conseguiu reconstruir essa ligação. Certo? Conseguiram entender? E aí a gente consegue entender agora, já que ela não guarda o texto inteiro, o dado inteiro. Caraca, de novo, porra! Que mal! Se ela não guarda o texto inteiro, porque não tem como. Então, se a gente tem 10 terabytes ali, daquele número ali que eu coloquei, 10 terabytes da internet, se eu fosse fazer um modelo com tudo isso, ia ficar muito gigantesco, muito difícil de eu fazer. Então, a galera inventou esse algoritmo que consegue destilar isso para ficar menor, mais ou menos 10 vezes menor. Então, seria como se fosse uma compressão. A gente fala, a Monostage, que é uma compressão com perdas. Diferente de você zippar um arquivo, que você zippa o arquivo e o arquivo ainda está inteiro, isso aqui que a IA faz, ela está fazendo uma compressão com perdas. Ela perde partes das coisas porque ela conseguiu no treinamento aprender a reconstruir essas coisas com um grau de assertividade OK. Então, você pode falar alucinação, você pode substituir essa palavra por sonhos. Por que sonhos? Mandei um input para ela: por favor, faça uma descrição de um produto para o meu e-commerce. Vocês fizerem isso agora no ChatGPT, a resposta dela vai ser alguma coisa similar a isso. Então, por que que é um sonho? Ela foi lá no mundo imaginário do GPT, viu: caraca, eu já vi algumas descrições aqui de e-commerce, pô, eu acho que eu tenho que botar o título primeiro. E depois eu tenho que botar uns números juntos, mais ou menos nessa quantidade. Esse número existe? Provavelmente não. Número inventado dela. Mas a estrutura parece ok. Então é isso que a IA faz. Então você pode substituir, pra ficar mais fácil de entender, alucinação por sonho. Ela tá sonhando como que aquilo ali deveria ser. Na ligação, então, ela sonhou. Certo? É uma palavra engraçada. Aqui tem outro exemplo de um código sonhado e aqui tem um exemplo de um artigo da Wikipédia também sonhado. Um artigo aqui sobre um, sei lá, um peixe aí. E que enfim, pode ser que esteja certo, não sei, tá? Então, se o processo dela é conseguir reconstruir coisas, por que que a gente agora reclama que ela está inventando as coisas? Mas não é justamente essa a tarefa dela, não é? Conseguir reconstruir as coisas. A gente literalmente gasta bilhões para fazer isso. Então aqui vocês conseguem entender que o processo dela, ele é previsto para isso, ele é feito para isso. E tem uns pontos positivos, pontos negativos. Ponto positivo: a gente consegue construir coisas com uma coesão muito maior. A gente consegue fazer uma poesia ali. Vai ter algum significado a poesia? Vai ter sentimento? Não, Mas é uma poesia que faz sentido, que dá pra entender ali. Mas aí cabe o papel do— ela é uma ferramenta e cabe ao humano fazer as análises pra ver o que cabe e o que não cabe. Isso aí. Então, ela tem os pontos positivos, tem os pontos negativos, cabe a gente desenhar as ferramentas que a gente dá a ela ou no nosso código pra controlar ela pra que ela seja útil. Por exemplo, uma ferramenta que ela consiga agendar uma ligação, não só falar que ela está fazendo a ligação. Isso aqui é um diagrama para vocês entenderem, só visualizar, de como que seria esse negócio do transformer. Esses aqui seriam as entradas e tudo isso aqui são as multiplicações das coisas que acontecem dentro de uma passada para frente que ela precisa fazer para poder responder as coisas para você. Então você tem os mecanismos de atenção que ela vai passando ali e consegue ver as coisas e fazer as multiplicações para encontrar o que faz sentido, qual seria a próxima palavra. Bom, o negócio é que a gente não sabe muito bem como que isso funciona lá dentro, tá? Por que o pessoal fala black box, é uma parada que ninguém sabe? A gente sabe como foi feito, foi um ser humano que desenhou isso aqui, um Einstein lá. A galera fez como é que funciona, só que quando eles testaram, porque que é empírico? Quando eu testei, saiu um resultado que eu não sei. Eu joguei ali um monte de GPU ali, a máquina juntou os dados, agrupou os dados de uma maneira que eu não sei como eles estão agrupados. Existe um exemplo que vocês podem fazer Hoje em dia tem um modelo do Llama, por exemplo, não vai funcionar com o ChatGPT porque o ChatGPT já viu isso aqui e corrigiu, mas se você perguntar para esse modelo Llama, é recente, saiu esse ano também, no final do ano passado: "Quem é a mãe do Tom Cruise?" Esse modelo ele vai responder: "Mary-Lee Pfeiffer." Agora, se você perguntar para esse modelo na mesma conversa, não tô nem falando para fazer outra conversa não, "Quem é o filho de Mary Lippfeifer?" O modelo responde: "Não sei." O que está acontecendo aqui? É um exemplo clássico que o pessoal chamou de reverse curse, maldição reversa, que mostra que como a gente não entende a parada da organização, e essa organização ainda por cima é 3D, a gente não consegue nem entender como o modelo acessa esse conhecimento lá dentro. De tão louco. Por quê? Eu tô perguntando quem é a mãe do Tom Cruise e ela sabe. Aí eu quero perguntar pelo outro lado: "Quem é filho dessa pessoa?" E ela não sabe mais. Mas é o mesmo conhecimento, só que ela não tá conseguindo acessar de todos os lados possíveis. Então isso aqui é um exemplo de como esse conhecimento lá dentro, ele é meio louco, tá? Então, resumindo aqui, né? Tem como usar IA em produção, IA para produtos? Claro que tem, muita gente está fazendo e fazendo muita grana com isso. Só que você precisa fazer de uma forma inteligente, que você consiga medir, medir a incerteza, medir o que ela está fazendo, dar as ferramentas corretas. E aí vai a inteligência, a perspicácia humana. Como fazer para controlar esse ser que a gente não sabe como é que funciona? Beleza? Alguém quer perguntar alguma coisa aí? Maldição? Não? Confuso pra mim porque a gente não sabe mais de alguma forma a gente consegue trabalhar isso. Ah, você vai treinando, então, você tem um slide ali que eu vou mostrar, mas a gente vai pegando os problemas que a gente encontra e você vai fazendo um fine tuning, um ajuste fino para poder corrigir esses problemas. Então se você fizer isso muitas e muitas vezes, você eventualmente vai ficar com um modelo massa. Certo? Então sim, a gente não sabe exatamente o que está rolando, mas a gente mede e empiricamente a gente faz correções. Pô, não está massa essa resposta, vamos mudar. Não está massa, está respondendo assim, está respondendo assado, vamos mudar, vamos mudar, vamos mudar. Vai fazer um ajuste fino, né? Isso, os laboratórios fazem isso, né? Então eles descobrem quais são os problemas e eles corrigem esses problemas. Tá? Bem rapidamente, que o tempo aqui já está passando bem rápido, Machine learning. Dizendo, então, falamos como que o modelo funciona. É um modelo probabilístico, ele está fazendo um cálculo de probabilidade do que ele vai te falar. E isso, apesar de toda a descoberta do algoritmo da atenção que fizeram, do Transformers, ainda assim, no seu cerne, é machine learning, é aprendizado de máquina. Então, o que é aprendizado de máquina? Você tem, por exemplo, dentro de algumas máquinas de lavar, você tem alguns cálculos que hoje em dia, mais recentemente, que ela consegue calcular ali qual seria automaticamente o peso que precisa colocar, a vibração que ela tem que colocar na centrifugação, coisas assim. Você tem modelos, por exemplo, dentro do Netflix, que está na vida aí, quem usa Netflix usa modelos de machine learning sem saber, todos os dias. O Netflix usa tanto modelos de machine learning, assim como o Spotify e outras empresas de consumidor, iFood, inclusive o iFood hoje, para quem não sabe, o iFood é a maior empresa de machine learning da América Latina. Eles são o maior cliente da AWS da América Latina inteira, eles são a maior empresa disso para a gente. Mas voltando aqui no exemplo, o Netflix chega até o ponto, gente, de descobrir qual é a sua preferência por capas de filmes, para saber o que vai te atrair mais nessas capas. E aí não são features, não são só análises baseadas em usuários similares, que seria um sistema mais simples como esse diagrama aqui. Então, se a pessoa assistiu esse filme e gostou, marcou como gostou, a outra pessoa marcou como gostou do filme e ela gostou do outro cruzado, aí, pô, eu posso indicar o mesmo para as duas. Então, isso aí seria um sistema simples. Já existem hoje modelos de recomendação mais avançados. Que conseguem captar e calcular a sua preferência dentro dos seus próprios dados, sem necessariamente usar os dados dos terceiros juntos. Regressão linear, não vou entrar em detalhes aqui. Companhias aéreas usam regressão linear. Se você comprou uma— modelo de regressão linear, se você comprou uma passagem aérea recentemente, você usou um modelo de machine learning sem saber, porque a precificação é automática utilizando esse tipo de modelo. Não é um código ali que a galera foi lá e fez. Ah, se tiver assim, se 299 pessoas comprarem de manhã num dia tal do mês que é Páscoa, antes da primavera. Vocês entendem como que a quantidade de possibilidades é inumana para você codificar? É para isso que serve o modelo de aprendizado de máquina. A gente consegue mostrar esses dados para ela no treinamento e ela vai aprender como isso funciona. Então aqui é um exemplo de regressão linear, que é um cálculo. Aqui é um outro exemplo de uma pipeline. Cadê o Luiz? Luiz, me ajuda, eu preciso de um carregador aqui, você me ajuda? É uma pipeline aqui de modelos, então se você consegue juntar várias coisas assim como o ChatGPT faz, pô, eu tenho um modelo aqui que ele não sabe gerar áudio, Eu tenho um modelo aqui que ele não sabe gerar imagem, mas e se a gente juntar essa galera para eles trabalharem juntos? É isso que o Google Photos faz. Então aqui, por exemplo, tem uma foto do meu bebezinho, que se vocês derem sorte vocês vão ver ele por aí. E aí a galera do Google lá, eles fizeram treinamento para poder identificar as fotos de bebê. Por isso que você entrar no seu Google Photos, você pesquisar, você consegue encontrar, tá? E ele consegue fazer outras coisas massa com isso também. Ele consegue, você consegue então, se eu tenho todos os dados do meu usuário, todas as fotos da vida dele inteira, certo? Que a pessoa bota lá para fazer um backup e fica lá, eu consigo pegar esses dados que eu tenho, mais qualquer outro dado que eu tenha sobre esse usuário, outras fotos, locais, consigo pegar pelo metadado da foto os locais que ele tirou e eu consigo fazer experiências com isso. Então, o Google Photos é uma das primeiras empresas que começou a utilizar uma pipeline de modelos de machine learning, de modelos que não necessariamente são modelos de linguagem, para poder construir algo que adiciona valor para o cliente. Se vocês se lembrarem, alguns anos atrás quem fez isso foi o Spotify. Spotify utilizou isso como uma estratégia de marketing, que é o quê? Vamos fazer um negócio para poder colocar para a galera quais foram os artistas que ela mais ouviu "Qual é o seu ranking no Brasil? Qual é o seu ranking no sei o quê? Quem mais ouviu isso e aquilo?" Então, a galera pegou os dados que eles tinham e construiu uma experiência que viralizava para poder utilizar aquilo ali como um motor de crescimento para a empresa deles. Então, esse é o potencial de coisas de machine learning e de ideias com engenharia de dados. Você consegue utilizar, se você capta esses dados, você consegue trabalhar com eles, basicamente. Em poucas palavras, é isso. Aqui a gente fez uma animaçãozinha, vou botar para vocês, deixa eu ver se vai tocar.
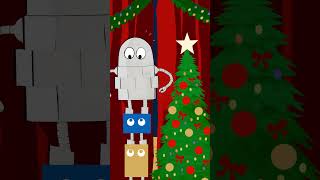
Conheça o Mono, ele é um modelo de linguagem de grande porte, ele sabe bem quase tudo, mas às vezes todo esse conhecimento fica embaralhado, ele fica sobrecarregado, travado e precisa de uma nova abordagem, então ele inicia o Mono State. E em vez de um modelo gigante, ele ganha pequenos modelos especializados projetados para uma única tarefa. Agora o mono pode cuidar do panorama geral e aproveitar as coisas importantes.
Deu para entender? Não foi feito com IA, gente, a gente tem um designer que faz isso aí, é meu cunhado inclusive. Então aqui explica, né, temos então o mono aqui nessa ideia, né, o robozão, ele é o modelo grande, um modelo que pode ser um GPT, pode ser um Gemini, pode ser qualquer coisa. E você consegue desenvolver modelos especializados, por exemplo, uma regressão linear, é um modelo para gerar um áudio assim, modelo para fazer aquilo assado, e a gente chamar esse modelo dinamicamente para quando eu preciso dele. Essa é a ideia. Beleza, então como é que a gente treina esses modelos? Basicamente, já foi feito todo aquele processo que a gente falou trilhões de terabytes lá, aquele monte de coisa, e agora ela consegue fazer os sonhos dela. Ela inventa lá várias coisas. Só que a gente precisa que essa invenção seja útil para a gente. Então a gente ensina ela agora o que é um usuário e o que é um assistente. Ela não sabe, até esse momento no pré-treinamento ela não sabe disso. Ela só sabe replicar coisas. Agora eu começo a mostrar para ela: "Se alguém me perguntar o negócio assado, você responde assado." E aí ela aprende também a completar essas frases. É a mesma ideia de completar e prever a próxima palavra, só que agora com uma estrutura de dados diferente, distinta, para ensinar esse modelo a seguir instruções e ser ajudante, helpful. É isso. E aí é muito, muito dado. Você faz muito disso aqui. Antigamente se escrevia muito por pessoas. Muita gente escrevendo as respostas. Então, você tem um negócio, por exemplo, a Mia tá inventando minhas paradas lá, tá inventando, enjambrando lá os negócios. O que está faltando? Está faltando isso. Você fazer um dataset com os dados do que você quer que ela responda, como que você quer que ela se comporte. Você vai pegar esses dados, se você tiver uma amostragem suficiente, ela vai aprender a replicar isso aqui. Então, você pode fazer uma pergunta, por exemplo, E ela te respondeu o negócio de uma maneira que ajuda. E a parte interessante é que ela não esquece as coisas que ela viu no pré-treinamento. Ela meio que dá uma organizada nos parâmetros dela, nas ideias lá sonhadas dela.
More from Andrew
Você paga caro pelo lead, mas ele esfria antes mesmo do seu time dar um ‘oi’?
Seu time de vendas se esforça, mas o resultado não vem? entre em contato com a gente!