AI Dev 25 | Amit Sangani: Unlock the Power of Open Source with Llama
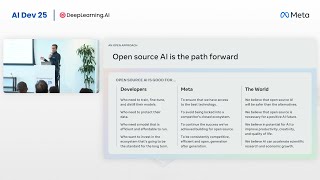
Amit Sangani from Meta explains why they open-sourced Llama and walks through the model family from Llama 1 to 3.3, multimodal variants, and production deployments at companies like Smartly. He covers fine-tuning, quantization, edge deployment, and building agentic workflows with the Llama Stack.
Chapters
Wie geht es euch allen? Gut, Mir ist klar, dass ich zwischen Ihnen und dem Mittagessen stehe und das ist immer eine schwierige Zeit für eine Präsentation, aber ich hoffe, es lohnt sich. OK, Hallo, ich bin Ahmed Sanani, Danke Jeff für die nette Vorstellung. Ich leite das Partner Engineering Team für Kibai Meta. Mein Team hat zwei die Unterstützung der ptarch Entwicklerplattform und LAMA. Wie Sie wissen, handelt es sich bei beiden um Open Source Plattformen, sehr beliebte Open Source Plattformen. Und das Hauptziel meines Teams ist es, die Akzeptanz dieser Plattformen zu erhöhen. Auf einigen Folien werden Sie vielleicht Wiederholungen aus Chias Vortrag vom frühen Morgen sehen, aber ich habe viel mehr Details eingefügt, da ihre Sitzung zehn Minuten dauerte. Meine dauert 30 Minuten. Ich werde jedoch über drei Dinge Erstens den offenen Ansatz Warum macht Meta das? Und dann werde ich über Lama Stack sprechen, eines unserer wichtigsten Projekte, an dem wir gerade arbeiten, neben der Modellentwicklung und dem Thema Vertrauen und Sicherheit. Ich werde dabei auch einige Anwendungsfälle aus der Praxis einfließen lassen dazu, damit Sie einen Eindruck davon bekommen, wie Lama in der Produktion eingesetzt wird. Als erstes möchte ich darauf eingehen, warum Open Source wichtig ist. Wir sind überzeugt und Mark Zuckerberg hat letztes Jahr in einem Brief betont, dass Open Source Key der Weg in die Zukunft ist. Sie kommt allen Entwicklern, Start ups, Unternehmern, dem gesamten Ökosystem und allen und auch der Meta Community. Ich werde erklären, warum. Entwickler können Modelle trainieren, optimieren und destillieren. Sie können sie weiterverkaufen und all das. Sie können sie in eine neue Anwendung packen, ohne jegliche Lizenzbeschränkungen. Das ist enorm wichtig und diese Entwickler können überall auf der Welt arbeiten. Sie müssen nicht hier sitzen oder Ein weiterer großer Vorteil ist, dass sie ihr Modell dorthin verschieben möchten, wo die Daten sind, und nicht dorthin, wo die Daten zu ihrem Modell verschoben werden. Deshalb ist Open Source so Sie können es herunterladen, vor Ort installieren, in der Cloud installieren, in ihrer eigenen Umgebung und sie haben die volle Kontrolle über ihre Daten. Das ist für die meisten Unternehmen enorm wichtig. Darüber hinaus gibt es ein ganzes Ökosystem, das an der Verbesserung des Modells, der Effizienz usw. Arbeitet. Nun stellt sich die Frage, warum Meta das tut. Wir tun es aus mehreren Gründen. Erstens haben wir durch Open Source Zugriff auf die beste Technologie und die besten Mitwirkenden tatsächlich etwas beitragen und können all das intern nutzen. Zweitens wollen wir nicht an das geschlossene System unserer Konkurrenten gebunden sein und das ist uns ebenfalls sehr wichtig. Wir entwickeln Verbraucher Apps. Verbraucher Apps benötigen KI Technologie und wir wollen sicherstellen, dass wir nicht an die KI Plattform eines anderen gebunden sind. Phones und es kommt der Welt zugute. Wir glauben, dass Open Source eine sicherere Alternative ist. Es wird umfassend geprüft und es herrscht große Transparenz über unsere Arbeit. Wir glauben, dass es das Potenzial hat, Produktivität, Kreativität und Lebensqualität weltweit zu verbessern. Schauen wir uns also die Entwicklung von LAMA an. Ich werde nicht zu viel Zeit darauf verwenden, da viele bereits darüber Bescheid Wissen. Wir haben 2023 mit Lama 1 begonnen. Dies war ausschließlich für Forschungszwecke und mit einer Forschungslizenz gedacht. Wir stießen auf überwältigendes Interesse an der Kommerzialisierung. Das bedeutet, dass Unternehmen dies für ihre GENI Anwendungen im kommerziellen Bereich nutzen wollten. Also brachten wir Lama 2 mit kommerzieller Lizenz auf den Markt. Wir führten eine Reihe von Sicherheitstools ein und anschließend Lama 3 und 3.1. 3.1 war ein einzigartiger Start, da wir 405 Milliarden Parameter hatten. Dies ist das mit Abstand größte Open Source Modell mit 4 bis 5 Milliarden Parametern. Anschließend brachten wir Lama 3.2 und den Lama Stack auf den Markt. 3.2 hat, wie Sie sehen, 1 Milliarden und 3 Milliarden Parameter. Dies sind kleine Modelle, die auf das Gerät passen. Wenn Sie also mobile Anwendungen entwickeln und nicht in die Cloud gehen möchten, können Sie diese Modelle nutzen, optimieren und direkt auf dem Gerät verwenden. Dann haben wir die Modelle B und B, die Vision Modelle. Sie können neben Text auch Vision verarbeiten. Mit Lama 3.3 haben wir das B Modell eingeführt, das fast so leistungsstark ist wie 40 oder B. Lassen Sie uns über einige Anwendungsfälle in der Praxis sprechen. Smartly ist ein KI gestütztes Werbetechnologieunternehmen, das jährlich rund 5 Milliarden US Dollar an Werbeausgaben verwaltet und über mehr als 700 Marken verfügt. Einer ihrer wichtigsten Anwendungsfälle war der Ausbau des Kundenservice und sie haben verschiedene Modelle ausprobiert. Sie stellten fest, dass LAMA mit einem kleinen Modell für ihren Anwendungsfall ausreichte. Also haben sie im Grunde ein komplettes Support, Ticketing und Messaging System mit dem Lama B Modell entwickelt keine Feinabstimmung, nicht nur reines Prompt Engineering mit Prompt Vorlagen. Sie konnten den Zeitaufwand für die Ticketerstellung um 80 Prozent senken. Das bedeutet 80 Prozent Effizienz und 50 Prozent weniger Zeitaufwand für die E Mail Lösung an Ihre Kunden. So haben Sie es geschafft. Deshalb entschieden Sie sich für die lokale Ausführung von Lama, um die Sicherheit zu gewährleisten, da keine Daten weitergegeben werden konnten. Sie nutzten die Kubernetes Plattform, die Sie sicher auch nutzen, und konnten sie nahtlos integrieren, mit minimalem Ressourcenverbrauch und kompaktem Platzbedarf. So haben Sie es geschafft. Sie hatten zwei Kernplattformen, von denen die Inhalte die Support Chat Plattform, auf der die Chat Inhalte erstellt wurden, und die Ticket Plattform, auf der die Techniker diese Tickets bearbeiteten. Die Inhalte von dort gelangen zum Internetdienst, der zentralen Anlaufstelle, die dann die Eingabeaufforderungsvorlagen erstellt und an Lama 3.1 sendet. Egal ob es um die Erstellung eines neuen Tickets oder die Lösung eines Tickets geht, Sie erhalten die vollständig formatierte und strukturierte Ausgabe, die dann entweder im Ticketsystem veröffentlicht oder per E Mail an den Endbenutzer gesendet wird. Super einfach, aber ein sehr wirkungsvoller Anwendungsfall. Ich bin mir sicher, dass Sie alle eine Art Ticketing System im Einsatz haben, das Sie vor dem Versand per E Mail an Ihre Kunden formatieren müssen. All das lässt sich automatisieren und die Effizienz wurde dadurch um über 80 Prozent gesteigert. Bisher wurde zwar nur Prompt Engineering betrieben, aber wir haben bei echten Kunden gesehen, dass die Feinabstimmung Ihres Modells auf ihre domänenspezifischen Daten die Leistung dieser Modelle deutlich steigert, anstatt eine Anfrage an ein großes Modell in der Cloud zu senden und eine Antwort zu erhalten. Für Ihren Nischenanwendungsfall, der in den meisten Fällen ein Nischenanwendungsfall ist, ist das äußerst ineffizient. Die meisten von uns bauen auf einem kleineren Modell auf und optimieren es. Sie führen Evaluierungen durch, stellen sicher, dass es die gewünschte Genauigkeit erreicht, und wiederholen dies, bis die gewünschte Genauigkeit erreicht ist. Und dann können Sie das Modell überall in der Cloud vor Ort auf dem Gerät. Sie können es weiter quantifizieren und auf dem Gerät verschieben. Ein unabhängiges Forschungsunternehmen hat gezeigt, dass Feinabstimmung der beste und effizienteste Weg ist, Anwendungen auf der Grundlage des Modells zu erstellen. Hier ist ein weiterer Anwendungsfall, bei dem das Modell für die Halbleiterindustrie fein abgestimmt wurde. Sie haben das erste domänenspezifische LLM entwickelt, in diesem Fall für die Halbleiterindustrie, und es heißt Semicong. Wenn Sie also nach Semicom googeln, werden Sie sehen, dass es Open Source ist und das gesamte Wissen der Halbleiterindustrie enthält. Und es wurde von Automatic entwickelt. Es handelt sich um ein KI Halbleiterunternehmen hier im Silicon Valley. Sie haben das Basismodell und das B-Modell genommen und hatten Unmengen an Daten zum Thema Halbleiter und Halbleiter sind ein sehr komplizierter Prozess, von der Herstellung in IC-Fabriken über das Testen bis hin zur Bereitstellung und so weiter. Sie haben diese Daten im Grunde genommen eingespeist. Das Führungsteam von itmatic verfügt über umfangreiche Branchenerfahrung im Halbleiterbereich. Sie verfügten über dieses Wissen, flossen es in dieses Modell ein und stellten es als Open Source zur Verfügung, damit Unternehmen darauf aufbauende Anwendungen entwickeln können. Sie stellten fest, dass die Chip Entwicklungszeit bis zur Markteinführung um 30 Prozent verkürzt wurde. Ein enormer Es handelt sich um ein Multimilliarden Dollar Unternehmen, und wenn ich meine Effizienz um 30 Prozent steigern kann, bedeutet das Einsparungen in Höhe von hunderten Millionen Dollar und eine Steigerung der fehlerfreien Fertigung auf Anhieb um 25 Prozent. Bei jeder Berechnung stellten Sie eine Verbesserung um 25 Prozent bzw. Eine 25-prozentige Genauigkeit bereits beim ersten Tank fest und auch andere Faktoren verbesserten sich. Nach der Feinabstimmung führten sie Evaluierungen durch und stellten fest, dass semicong für die Halbleiterindustrie deutlich besser abschnitt als alle anderen Modelle. Hier gibt es Sonet, Haiku und so weiter, sogar GPD. Außerdem profitieren Sie von allen Vorteilen der vollständigen KI Souveränität. Sie besitzen dieses Modell. Sie erhalten Sicherheit auf Industrieniveau mit On Premise Bereitstellung und können dieses Modell auch für Edge Intelligence quantifizieren. Dann gingen sie noch einen Schritt weiter und begannen mit der Entwicklung von Expertenagenten für Domänen. Sie stellten also offensichtlich Semikolons bereit. Doch dann kam ein großer IC-Hersteller auf sie zu. Und Wir wollen eine umfassende technische Unterstützung für dieses Modell schaffen. Also bauten sie einen vollständigen Expertenagenten für Domänenexperten auf. Dabei gab es drei Erstens die Erfassung. Dabei wurde das Basismodell, das Halbleiter Basismodell, das auf dem B Modell basiert, mit den domänenspezifischen Daten des IC Herstellers gefüttert und weiter optimiert. Zweitens wurden synthetische Daten generiert, um es zu trainieren. Diese synthetischen Daten wurden generiert, weiter trainiert und anschließend in der Produktion eingesetzt. Die erstellten Inhalte enthielten komplexe technische Informationen, Expertenwissen und so weiter. Hier ist ein Architekturdiagramm auf hoher Ebene, das zeigt, wie Sie das umgesetzt haben. Der neurosiolische Programmierer und Executor basiert auf dem Halbleitermodell. Der Expertenwissensspeicher umfasst dynamisches Wissen der Außendiensttechniker, ihre technischen Anleitungen und die über die Jahre gesammelten Datenquellen. All das wird in das Modell eingespeist. Feinabstimmung wird durchgeführt. Die Außendiensttechniker erhalten bei Fragen dazu Antworten, die möglicherweise nicht hundertprozentig korrekt sind. Die Außendiensttechniker modifizieren diese und speisen sie wieder in das Modell ein. So verbessert sich das Modell mit der Zeit, was den entscheidenden Vorteil dieses Systems darstellt. Die Komplexität ist deutlich gestiegen, was den agentischen Workflow und so weiter betrifft. Kommen wir nun zum Milliarden Modell. Dies ist das größte Modell, das wir veröffentlicht und eingeführt haben und es verfügt über vier oder fünf Milliarden Parameter. Für die Erstellung wurden Token benötigt. Es umfasst 16 Billionen Token. Es bietet hochmodernes, effizientes und hochgradig skalierbares Denkvermögen. Als wir das auf den Markt brachten, dachten wir, dass es von Leuten verwendet werden würde, um komplizierte Anwendungen usw. Zu erstellen. Und das tun die Leute auch. Aber der wichtigste Anwendungsfall, den wir sehen, ist die Generierung synthetischer Daten. Sie verwenden es als Speicherort für alle Daten, das Wissen und die Informationen und sie extrahieren diese, um die Modelle weiter zu verfeinern. Das sind ziemlich interessante Anwendungsfälle, die wir da draußen sehen. Und Hier ist ein Sokrypt ist ein großes Content Repository mit Zeitschriften und so weiter. Sie haben 200 Millionen monatliche Aktivitäten und sie nutzen die Generierung synthetischer Daten, um das gesamte Sucherlebnis für ihre Benutzer zu verbessern und so haben sie es Sie Als die Benutzer auf ihre Site kamen, stellten sie fest, dass sie nur eine Stichwortsuche durchführten und nicht in der Lage waren, den natürlichen Sprachkontext oder das semantische Verständnis dessen zu verstehen, was der Benutzer zu finden suchte. Sie nutzten alle drei B, B und B wurde zur Generierung von Inhalten, Verhalten und Kataloginformationen verwendet und erweitert. Im Vergleich zum Vorgängermodell erzielten sie einen um 76 Prozent schnelleren Durchsatz, eine 97-prozentige Genauigkeit bei der Suche nach Nutzern, was beachtlich ist, und 30 Prozent geringere Rechenkosten. Hier ist die Lö B generiert synthetische Daten, mit denen das B Modell optimiert wird, um die Kundenabsicht zu erkennen, einschließlich seltener und Randfragen. Anschließend wurde das B Modell verwendet, das im Wesentlichen auf den Inhaltsbibliothekskatalog abgestimmt ist und den Inhaltsbibliothekskatalog versteht. So können die Ergebnisse dem Nutzer bereitgestellt werden. Ich zeige Ihnen den Ablauf auf der nächsten Folie. Mit diesen drei Modellen können Nutzer bei Suchanfragen deutlich bessere Antworten basierend auf ihrer natürlichen Sprachanfrage erhalten. Hier sind alle Vorteile, die Sie hier sehen. Ich werde hier nicht alle Details erläutern, aber sie werden sie verstehen. Hier ist der grobe Der Nutzer sendet eine Abfrage, die aus einem langen Text bestehen kann, ganz ähnlich wie unsere heutigen Google Suchen. Wir suchen nicht mit wenigen Schlüsselwörtern. Wir suchen nach einem langen Text. Und dann analysiert das B Modell, oder besser gesagt das B Modell, den Kontext und erstellt eine umfangreichere Abfrage. Diese sendet es an das Lama B Modell, das bereits mit seinem Modellkatalog angepasst ist. Es extrahiert die Metadaten, gleicht den Inhalt mit der Nutzeranfrage ab und generiert die Antwort. Diese Antwort ist im Wesentlichen eine Liste des gesamten Katalogs. Es handelt sich also um ein Repository für Zeitschriften, Bücher, Podcasts und mehr. Es verfügt über umfangreiche Inhalte und kann diese damit abfragen. Wie Sie sehen, nutzen Sie alle drei Modelle, anstatt Anfragen nur an eine Stelle zu senden und Antworten zu erhalten. Das steigert Ihre Effizienz erheblich. Kommen wir nun zum Lama Stack, denn das ist sehr interessant. Modelle werden, wie Sie alle wissen, immer mehr zur Massenware. Und was wir in realen Anwendungen gesehen haben, ist großartig. Ja Wir können Request Response Modelle erstellen, aber es ist sehr schwierig für uns, die Modelle in die Produktion zu bringen. Warum? Weil es nicht viele Dienste für Rack, Destillation, Quantisierung, Feinabstimmung und so weiter gibt. Der Markt ist extrem fragmentiert, es gibt keine Standardisierung. Deshalb ist es sehr komplex, eine auf einem LLM basierende JAI Anwendung in die Produktion zu bringen. Deshalb haben wir den Lama Stack entwickelt, um Entwicklern eine standardisierte Entwicklungsumgebung zu bieten. Ich zeige Ihnen, wie das geht. Lamasac besteht aus drei Komponenten. Eine davon ist das Client SDK. Sie können es auf Lama herunterladen. Es ist vollständig Open Source und bietet einheitliche APIs und eine Ebene zum Aufrufen aller darunterliegenden Ressourcen. Es gibt Unternehmen, die Distributionen erstellen und diese als Linux ähnliche Distributionen betrachten. Sie können ein komplettes Distributionspaket mit verschiedenen Diensten erstellen und es ihren Mitarbeitern zur Verfügung stellen. So sehen die API Ebenen im Überblick aus. Es gibt Inferenzlösungen, darunter VLM, Tensor, RT usw. Agenten, viele agentenbasierte Frameworks, Speicher, REC und viele verschiedene Vektordatenbanken. Alle diese APIs verfügen über die benötigten Ressourcen und verfügen über eine einheitliche API Schicht. Wenn Sie Ihre Client Anwendungen erstellen und Ihre Dienste wechseln, müssen Sie Ihre Client Anwendung nicht ändern. Es genügt eine einfache Konfigurationsdatei, die Sie einfach austauschen können. Das ist ideal für Unternehmen, deren Teams an KI Projekten arbeiten und die unternehmensweit standardisieren möchten. Um Ihnen einen kleinen Einblick zu Inferenzanbieter wie Grok, VLMaws haben einen Inferenzadapter entwickelt, mit dem sie sich nun mit nur einer Konfigurationsdatei verbinden können. Dasselbe gilt für Speicheranbieter wie fhirs, die Open Source Vektordatenbanken wie Chroma und so weiter sind. Evaluierungsanbieter und Unternehmen wie Dell, Oracle und viele andere können Distributionen erstellen, ohne dass große Unternehmen erforderlich sind. Sie können als Entwickler eine Distribution für sich selbst erstellen. Wenn Sie bestimmte Dienste benötigen, wählen Sie diese aus und erstellen Sie eine Distribution. Verwenden Sie dann die Lama Stack API, also eine einheitliche API, um auf all diese Dienste zuzugreifen. So sieht die Struktur apps auf dem Lama Stack Client verbinden sich mit den verschiedenen APIs. Aktuell gibt es dafür rund 12 APIs und Provider. Diese Zahl wird mit der zunehmenden Anzahl an Diensten weiter steigen. Wussten Sie schon, basierend auf LLMs für GENI Anwendungen werden Sie einen weiteren Anstieg erleben. Sie müssen nicht mehr alle APIs verwenden. Sie können eine einzige Agenten API für Tool Aufrufe verwenden oder den Speicher für Aufrufe Ihrer Vektordatenbank nutzen, die remote oder inline erfolgen können. Das ist enorm leistungsstark. Wenn Sie Ihr Service Management ändern, können Sie all das mit einer einfachen Änderung der Konfigurationsdatei tun, ohne den Client ändern zu müssen. Hier ist ein Stellen Sie sich vor, Sie haben einen KI Agenten für die Datenanalyse. Sie laden eine CSV Datei hoch. Anstatt nur deren Inhalt zu beschreiben, kann er alle Erkenntnisse generieren. Dafür wird die Agenten API verwendet. Es handelt sich um ein agentenbasiertes Framework. Es zerlegt die Aufgabe in mehrere Schritte und führt mehrstufige Schlussfolgerungen durch. Er kann Python Code generieren, Erkenntnisse generieren, Trends erkennen, alle Berechnungen durchführen und sogar ein Tool aufrufen, um Daten von Yahoo Finance oder einer anderen Website abzurufen und in Ihre Excel Tabelle einzufügen. So erhalten Sie das perfekte Diagramm, das Sie benötigen. All Dies geschieht über Lama Stack. Sie können all dies abrufen. Hier ist eine Beispiel App, die wir erstellt haben. Im GitHub Repository von LamaStack finden Sie unzählige Beispiel Apps. Schauen Sie sich das an. Es gibt dort über 20 Beispiel Apps. Wir bieten außerdem Clients für verschiedene Benutzeroberflächen an, Python für Ihren server oder ihr Web Server, Swift und Co. Für iOS und Android sowie Not JS für ihr Web. Und die Leute lieben das. Wir haben eine enorme Akzeptanz erlebt und viele GitHub Stores nutzen es bereits sehr positiv. Und das ist erst der Anfang. Es wird noch viel mehr kommen. Wir haben es Ende letzten Jahres eingeführt und arbeiten noch daran. Es wird noch viel mehr kommen und andere Unternehmen entwickeln ähnliche Projekte, die Sie wahrscheinlich letzte Woche gesehen haben. Zusätzlich gibt es das sogenannte Lama Cookbook. Wie viele kennen Lama Recipes oder das Lama Cookbook. OK, wenige, Bitte klicken Sie hier. Es wurde von meinem Team entwickelt. Ich möchte, dass Sie es auch nutzen. Es bietet zahlreiche Ressourcen, von Schnellstartanleitungen über Anwendungsfälle bis hin zu experimentellen Inhalten in der Beta Phase. Es unterstützt alle Modelle. Es gibt auch Feinabstimmungsrezepte, Destillationsrezepte, Quantisierungsrezepte und so weiter. Hier finden Sie einen Scancode. Wenn Sie darauf klicken oder ihn scannen gelangen Sie zum Lama Cookbook Repository und gebt uns auch Feedback. Wir betreuen die Warteschlange ständig, um sicherzustellen, dass die Nutzer sie nutzen können. Vertrauensvolle Sicherheit ist extrem wichtig. Diese Modelle sind extrem leistungsstark und wir möchten sicherstellen, dass die Nutzer sie verantwortungsvoll nutzen. Deshalb haben wir auch verschiedene Tools für Vertrauen und Sicherheit eingeführt. Rechts oder links sehen Sie LAMA Guard, LAMA M, den Prompt Guard und so weiter. Ich möchte nicht ins Detail gehen, aber hier ist das Referenzsystem. Alles, was zu Ihrem Modell oder von Ihrem Modell zum Nutzer gelangt, können Sie mit einem Systemschutz versehen und das kann Ihr lahmer Teil sein. Sie können Ihre Taxonomy definieren, Sie können den Hebel ändern, um die gewünschte Sicherheit oder Nachsicht zu erreichen. All das ist flexibel und hängt von Ihren Anwendungsanforderungen ab. Meine letzten Folien zeigen, dass meta seit über 10 Jahren im Bereich KI arbeitet. Jan Lun gründete bei Meta ein Team für grundlegende KI Forschung und wir setzen auf Open Source. Wir lieben Open Source und werden das auch weiterhin tun. Wir haben uns außerdem mit IBM zusammengeschlossen, um die I Alliance zu gründen, die wir letztes Jahr gestartet haben. Über 100 Unternehmen nehmen mittlerweile daran teil und wir haben verschiedene Arbeitsabläufe. Ich habe hier auch einige Leute gesehen, die Teil der i Alliance sind. Wir haben über Open Source Projekte, darunter Ptorch, Llama, React und so weiter. Und wir sind nicht allein. Wir haben ein riesiges Partner Ökosystem, das uns und Lama geholfen hat, innerhalb des Ökosystems erfolgreich zu sein. Und das treibt Innovationen weltweit voran. Hier sind alle unsere Partner, aber das ist nicht auf diese Folie beschränkt. Es gibt natürlich noch viel mehr, was ich nicht auf die Folie bringen konnte. Hier sind einige Partner, von den Hyperscalern, die Sie hier sehen, bis hin zu vielen kleineren Unternehmen, globalen Systemintegratoren und Chip Partnern wie Nvidia, mit denen wir eng zusammenarbeiten, um sicherzustellen, dass das Modell auf der Metallebene optimiert ist. Und unser wichtigster Partner Deep Learning. Wir haben zahlreiche Kurse durchgeführt und diese Kurse haben großen Anklang gefunden, um die Prompt Engineering Kurse mit Lama 2 und 3 zu beschreiben. Wir haben den multimodalen Kurs Lama 3.2 durchgeführt. Nochmals vielen Dank an Andrew und das gesamte Team. Einige der Leute hier haben uns bei der Erstellung dieser Kurse geholfen. Wir haben auch mit Lamini daran gearbeitet, die Genauigkeit von LLM Anwendungen zu verbessern, Die Zahl der Lama Nutzer ist enorm gestiegen. 800 Millionen Downloads. Abgeleitete Modelle. Diese abgeleiteten Modelle sind im Grunde genommen fein abgestimmte Modelle von Lama, die Sie jetzt veröffentlicht haben. Sicher, es gibt viele fein abgestimmte Modelle, die Sie noch nicht einmal veröffentlicht haben, oder wir wissen noch nicht einmal, wie wir das berechnen sollen. Seit der Markteinführung haben wir ein zehnfaches Wachstum verzeichnet. Die Dynamik ist spürbar, aber sie fängt gerade erst an. Wir setzen alles daran, Lama weiterzuentwickeln. Wir werden es leistungsfähiger, zugänglicher und effizienter für reale Anwendungen machen und mit Ihrer Zusammenarbeit werden wir die Grenzen des Möglichen erweitern. Alles, was ich Ihnen gezeigt habe und viele weitere Fallstudien finden Sie auf unserer Website mit Lama Community Geschichten. Sie können sie sich ansehen. Dort finden Sie viele Details. Ich hoffe, Ihnen hat der Vortrag gefallen und ich hoffe, Sie beginnen, Lama zu nutzen. Wir können ein paar Fragen beantworten. Vielen Dank für den tollen Austausch über die Anwendungsfälle und das Rezept. Es gibt viele Informationen. Meine Frage ist nun, wie das passiert ist. Ursprünglich dachte ich, Sie würden nur Open Source nutzen, also hätten Sie tatsächlich einigen Kunden mit Lama geholfen. Wenn Sie den Lama Stack teilen, nutzen diese Erfolgsgeschichten bereits diese oder Sie sammeln Erfahrungen, die Sie später nutzen möchten, für die Kunden. Alles, was ich Ihnen gezeigt habe, ist bereits in Produktion. Alle Fallstudien, die ich Ihnen gezeigt habe, und viele weitere Community Geschichten sind bereits in Produktion. Wir bieten keine Beratung bei Meta an, aber wir kommunizieren grundsätzlich mit Entwicklern, beispielsweise über Kochbücher. Und wenn Sie eine Fallstudie haben, die Sie gerne teilen und von uns zitieren lassen möchten, arbeiten wir mit Ihnen zusammen, um die Fallstudie zu erstellen. Aber alles, was Sie entwickelt haben, stammt in der Regel von Ihrem eigenen Entwicklungsteam. Wir sind es nicht.










