AI Dev 25 | Apoorva Joshi: Building Agents That Learn—Managing Memory in AI Agents
Apoorva Joshi explains how to build memory systems for AI agents, mapping human memory types like episodic and semantic onto agent architecture. He covers a CRUD model for storing and retrieving memories: creation, persistence, exact or vector search, updates, compression, timestamps, importance scores, and deletion, with tradeoffs between latency, cost, and relevance.
Chapters
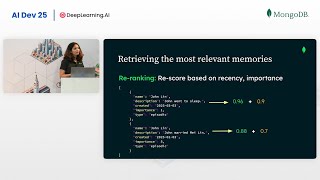
So, so. Wer hätte das gedacht? Wie damals, als ich Andrews Machine Learning Kurs besuchte, hätte ich nie gedacht, dass ich heute hier sein und diesen Vortrag halten würde. Ich freue mich riesig, heute hier zu sein. Juhu, danke, danke. Also hallo zusammen, ich bin Apurba und heute spreche ich mit Ihnen darüber, wie man künstliche allgemeine Intelligenz erreicht. Nur ein Das ist zu viel für einen minütigen Vortrag und ich habe definitiv nicht alle Antworten, aber ich werde etwas ebenso Grundlegendes besprechen, wie man Speicherverwaltungssysteme für KI Agenten entwickelt, damit sie wirklich aus Erfahrungen lernen und in Zukunft intelligent mit uns zusammenarbeiten können. Hier ein paar Informationen über mich. Letztes Jahr habe ich hier meine erste Rolle als Entwickleradvokat übernommen bei MongoDB und als Dev Advocate erstelle ich technische Inhalte, praxisorientierte Workshops und Vorträge. Sprechen Sie mit Entwicklern wie Ihnen, um sie zu inspirieren und ihnen beim Erstellen von KI Anwendungen zu helfen, mit oder ohne MongoDB. Davor habe ich etwa sechs Jahre lang an der Schnittstelle zwischen maschinellem Lernen und Cybersicherheit gearbeitet. Außerhalb der Arbeit lese ich gerne, mache regelmäßig Yoga, bis ich mir vor kurzem das Knie verletzt habe und bin immer bestrebt, so viele Cafés wie möglich zu besuchen. In meinem heutigen Vortrag werde ich zunächst darüber sprechen, was KI Agenten im Zeitalter der generativen KI sind und warum dieses Gespräch über Gedächtnis so wichtig ist. Anschließend werde ich über die Arten des menschlichen Gedächtnisses sprechen und wie und ob sie sich auf ajonctisches Gedächtnis übertragen lassen. Außerdem werde ich ausführlich darauf eingehen, wie man CRUD Erinnerungen verwaltet oder wie ich es gerne nenne. Abschließend werde ich meine Wünsche und die wichtigsten Erkenntnisse meines heutigen Vortrags darlegen. Ich hoffe, ich habe noch etwas Zeit für Fragen und Antworten gelassen. Falls nicht, kommen Sie gerne nach dem Vortrag zur Happy Hour oder wo auch immer vorbei. Super, lassen Sie uns gleich loslegen. Lassen Sie uns kurz darüber sprechen, was Key Agenten sind. Key Agenten gibt es schon lange, mindestens seit den ER Jahren. Hier sind einige Bilder, die ich aus den ER Jahren gefunden habe. Reinforcement Learning Agenten waren die ursprüngliche Idee von KI Agenten. Ein Machine Learning Modell wählt aus einer Reihe vordefinierter Aktionen aus, um die Belohnungen basierend auf einer Art Umgebungsfeedback zzu maximieren. Diese Belohnungs Feedback Schleife hat diesen Agenten geholfen, Spiele wie Backmin, Schach und Go zu meistern und sogar die Großmeister ihrer Zeit zu schlagen. Mit dem Aufkommen von lms hat sich diese Definition jedoch etwas verschoben. Wenn heute von KI Agenten die Rede ist, sind typischerweise LM basierte KI Agenten gemeint. In diesem Vortrag meine ich wie alle anderen auch LM basierte Agenten. KI Agenten, egal ob Reinforcement Learning oder LM basierte Agenten, haben im Wesentlichen die gleichen Hauptkomponenten. Die Wahrnehmung ermöglicht es ihnen, ihre Umgebung zu beobachten und zu interpretieren. Die Aktion ist die Art und Weise, wie sie mit ihrer Umgebung interagieren. Dann gibt es noch das Gedächtnis. Dadurch sollen sie Informationen über ihre vergangenen Erfahrungen, ihren Zustand und ihr Wissen sowie Feedback, also Signale aus der Umgebung oder vom Benutzer, speichern. Dies steuert ihr Verhalten. Bei LLM basierten Agenten kommt eine zusätzliche Komponente das logische Denken. Das bedeutet, dass sie nun ein Problem weitgehend selbstständig durchdenken und die Vorgehensweise zur Problemlösung bestimmen können. Im Kontext von LM-basierten Agenten basiert die Wahrnehmung auf Eingaben, die von Menschen oder Systemen wie Slack oder E Mail stammen können. Diese Agenten agieren mit Hilfe von tools, beispielsweise einfachen APIs wie Wetter oder Such APIs, Vektordatenbanken wie MongoDB oder anderen Datenbanken oder sogar speziellen Machine Learning Modellen. Das Gedächtnis des Agenten basiert auf seinen vergangenen Aktionen oder Interaktionen mit dem Benutzer oder der Umgebung und gibt den Agenten ebenfalls Feedback. Das Feedback stammt von den ausgeführten Tools, dem Benutzer und der Umgebung, in der er ausgeführt wird. Schließlich nutzen sie lms als Gehirn, was ihnen beim Denken und Entscheiden hilft. Die Definition eines KI Agenten im Zeitalter der generativen KI lautet. Ein KI Agent ist ein System, das mit Hilfe eines LLM ein Problem analysiert, einen Lösungsplan erstellt, diesen mit Hilfe von Tools umsetzt und ihn anhand des Feedbacks der Tools und früherer Interaktionen iteriert. Das ist enorm wichtig. Mit Agenten haben wir das Weltwissen von lms, ihre Denk und Sprachverständnisfähigkeiten sowie ihre Handlungsfähigkeit erweitert. Mit Agenten erscheint eine Zukunft der vollständigen Autonomie, das letztendliche Ziel der künstlichen Intelligenz, tatsächlich möglich und unfassbar näher als je zuvor. Vertrauen und Zuverlässigkeit spielen jedoch eine wichtige Rolle dabei, Agenten als zukünftige Partner zu betrachten. Die gute Nachricht, und für manche von uns auch eine schlechte ist, dass sich die Dinge ständig und schnell verbessern. Konnten wir vor wenigen Jahren noch ausschließlich über Text mit LMS interagieren, können wir heute über andere Modalitäten wie Bilder, Sprache oder eine Kombination dieser Möglichkeiten interagieren. LLMs werden auch im Denken immer besser. Früher mussten wir mit diesen Modellen hin und her gehen, um zu einem Ergebnis zu gelangen. Jetzt können wir LMS ein Ziel geben und sie dann planen, argumentieren, reflektieren, verfeinern und alles tun lassen, was nötig ist, um zu einer endgültigen Antwort zu gelangen, anstatt sie bei der Problemlösung an die Hand zu nehmen. Es gibt jedoch einen Aspekt von Agenten, über den noch nicht viele sprechen. Etwas, das für sie wirklich wichtig ist, um unsere Handlungsfähigkeit in Zukunft zu erweitern. Etwas, das es uns ermöglicht, ihnen die Steuerung unseres metaphorischen Vehikels unseres eigenen Lebens zu überlassen, und das ist das Gedächtnis. Ehrlich gesagt sehen wir in meisten heutigen LMLLM-Anwendungen eine Form von Gedächtnis, meist in Form des Chatverlaufs. Dieser liefert LMS den Kontext vergangener Interaktionen in einem Gespräch, um einen zusammenhängenden Dialog während des Gesprächs aufrechtzuerhalten. Und das funktioniert derzeit in den meisten Fällen, da der Umfang, für den wir LMS derzeit nutzen, recht begrenzt ist. Da wir von diesen Modellen und Agenten erwarten, dass sie anspruchsvollere und kompliziertere Aufgaben ausführen, wollen wir, dass sie intelligenter sind als bisher. Stellen Sie sich vor, wir könnten uns nur an unsere letzten Gespräche erinnern. So funktionieren wir aber nicht, oder Menschen haben grundsätzlich zwei Arten von Gedächtnis, Kurzzeit und Langzeitgedächtnis. Lassen Sie uns ein wenig darüber sprechen und dann sehen, wie und ob sich diese in KI in KI Agenten umsetzen lassen. Das Kurzzeitgedächtnis hilft uns, uns nicht nur an Gespräche der jüngeren Vergangenheit zu erinnern, sondern auch an andere Beobachtungen, wie zum Beispiel an das Wetter, das Sie heute Morgen in San Francisco nachgeschlagen haben. Es gibt sogar ein Kurzzeitgedächtnis, das Arbeitsgedächtnis, das vorübergehend Informationen speichert, mit denen Ihr Gehirn gerade arbeitet. Wenn Sie beispielsweise eine mathematische Aufgabe lösen, werden alle Zwischenberechnungen, die Sie durchführen, im Arbeitsgedächtnis gespeichert. Was uns aber wirklich zu den sogenannten intelligenten Wesen macht, die wir sind, ist die Fähigkeit, uns an Erfahrungen zu erinnern und aus ihnen zu lernen, die wir über einen längeren Zeitraum gemacht haben, auch bekannt als unser Langzeitgedächtnis, das wiederum in verschiedene Typen unterteilt werden kann. Beginnen wir mit dem sogenannten semantischen Gedächtnis, unserem langfristigen Wissensspeicher, zum Beispiel Fakten, die Sie in der Schule gelernt haben oder ein umgangssprachlicher Begriff, den Sie nachgeschlagen haben und der sich für immer schmerzhaft in Ihr Gedächtnis eingebrannt hat. Dann haben wir das episodische Gedächtnis, das uns hilft, uns an wichtige Ereignisse und Episoden in unserem Leben zu erinnern und sie abzurufen, wie zum Beispiel den Streit mit Ihrem Partner, ich weiß nicht, vor sieben Jahren oder den Tag Ihres Hochschulabschlusses. Wir haben auch das prozedurale Gedächtnis, das uns hilft, Dinge zu lernen und uns daran zu erinnern, wie man Dinge tut, zum Beispiel Tippen oder Fahrradfahren. Und schließlich das sensorische Gedächtnis, das Erinnerungen an Sinnesreize umfasst, zum Beispiel ein Konzert, das sie besucht haben und das sich wirklich gut angehört hat, oder eine Pizza oder ein Brot, das Sie während Covid gebacken haben und das köstlich schmeckte und roch. Aber KI Agenten sind keine Menschen, sie sind Software oder eine Kombination aus Software und Hardware. Und damit sie wirklich über die gleichen kognitiven Fähigkeiten verfügen wie wir, müssen wir die Gedächtnisformen, von denen ich gerade gesprochen habe, in Software übertragen können, damit KI Agenten sie nutzen können. Sehen wir uns also an, wie und ob die erwähnten Gedächtnisformen auf das agentische Gedächtnis abgebildet werden. Es gibt natürlich das Kurzzeitgedächtnis, einige von Ihnen haben es wahrscheinlich schon genutzt, und wie bereits erwähnt, manifestiert es sich typischerweise als Gesprächsverlauf in LM Anwendungen einschließlich Agenten. Heute konzentrieren wir uns jedoch auf das Langzeitgedächtnis und Agenten. Beginnen wir mit dem semantischen Gedächtnis, dem Langzeitwissen des Agenten. Agenten verfügen über ein semantisches Gedächtnis, da sie Informationen in den Gewichten der LLMs codiert haben, die sie als ihr Gehirn nutzen. Wir können ihr semantisches Gedächtnis aber auch durch externe Datenbanken oder Wissensquellen ergänzen. Diese können alle Informationen enthalten, die ihrer Meinung nach das Verhalten der Agenten beeinflussen können. Wenn sie beispielsweise einen Kundenservice Agenten entwickeln, könnte dies die Dokumentation der verschiedenen Anwendungen enthalten, die dieser Service unterstützen soll. Oder wenn sie ein Simulationsvideospiel entwickeln, könnte dies Informationen über die verschiedenen Charaktere oder Entitäten in ihrer simulierten virtuellen Welt enthalten. Dann gibt es das episodische Gedächtnis, das menschliche Erinnerungen an vergangene Ereignisse beschreibt. In agentenbasierten Anwendungen hingegen übersetzt es sich in Aktionssequenzen, die der Agent zur Erledigung von Aufgaben ausführt. Hier ein Angenommen, es handelt sich um einen Computeranwendungsfall, bei dem ein Agent beispielsweise Webaktionen ausführt, um Aufgaben zu erledigen. Sie könnten also einen allgemeinen Namen für die Aufgabe und eine Beschreibung in natürlicher Sprache für die Abfolge der Schritte haben, die der Agent zur Erledigung dieser Aufgabe ausführt. Dann gibt es das prozedurale Gedächtnis, das im Wesentlichen das Gedächtnis des Agenten dafür ist, wie er Dinge erledigt. Auch hier verfügen Agenten intrinsisch über ein prozedurales Gedächtnis, das in den Gewichten des LMS codiert ist, das sie als ihr Gehirn nutzen. Und dann ist da noch der Agentencode selbst, der derzeit definiert ist. Er definiert den Ausführungsfluss des Agenten und schränkt ein, was er tun kann und was nicht. Agenten können zwar ihre Gewichte und ihren Code noch nicht selbst modifizieren, aber zumindest ihre Eingabeaufforderungen. Nehmen wir an, sie haben eine Systemeingabeaufforderung für den Agenten, die im Laufe der Interaktion mit dem Benutzer zusätzliche Informationen oder nützliche Anweisungen liefert. Der Agent kann dann seine Systemeingabeaufforderung aktualisieren, um diese Informationen zu berücksichtigen. Und schließlich gibt es noch den Arbeitsspeicher. Diese Informationen speichert der LLM in seinem Kontextfenster, während er die aktuelle Aufgabe bearbeitet. Der Arbeitsspeicher kann aus Benutzereingaben, Ergebnissen von Tool Ausführungen, den Planungs und Argumentationsspuren des LLM bestehen und auch Erinnerungen aus seinem Langzeit oder externen Speicher in seinen aktuellen Zustand einbinden. Da dieser Vortrag 30 Minuten dauert, werden wir uns jetzt nicht mit dem sensorischen Gedächtnis befassen. Ich persönlich denke K Agenten sind noch weit davon entfernt, Dinge wie Gerüche, Geschmäcker und andere Sinneseindrücke verarbeiten zu können. Falls nicht, können sie mich gerne korrigieren. OK Wir haben also bisher darüber gesprochen, wie die verschiedenen Gedächtnisformen in Agentenanwendungen aussehen. Lassen Sie uns nun darüber sprechen, was nötig ist, um Erinnerungen zu erzeugen und zu speichern, sie zeitnah und effizient abzurufen, Erinnerungen bei neuen Informationen zu aktualisieren und Erinnerungen zu löschen oder auslaufen zu lassen, um Platz für neue zu schaffen. Ich stelle mir Speicherverwaltung als eine gute alte CRUD Operation vor. Sprechen wir also über die Erzeugung von Erinnerungen. Wie bereits erwähnt, sind Agenten noch nicht vollständig autark, wenn es um die Erzeugung von Erinnerungen geht. Dank LMS verfügen sie jedoch über integrierte Gedächtnisformen. Beispielsweise sind Die Gewichte des LL.M. eine Form des semantischen und prozeduralen Gedächtnisses für Agenten. Wir können aber auch einige ihrer Erinnerungen aktivieren. Beispielsweise können wir zusätzliche semantische Erinnerungen für den Agenten erstellen, indem wir einen externen Wissensbestand erstellen und ihm über Tools Zugriff darauf gewähren. Wir können auch detaillierte Eingabeaufforderungen schreiben oder Tools erstellen, mit denen der Agent Erinnerungen aus Rohinformationen erstellen kann. Meiner Ansicht nach gibt es vier Elemente, die Agenten zur Erstellung von Erinnerungen nutzen können. Die Planungs und Argumentationsspuren des LLM, in denen er ein Problem durchdenkt, entscheidet, welche Tools aufgerufen werden und im Nachhinein Beobachtungen macht. Die Ergebnisse von Tool Aufrufen einschließlich aller Protokollierungsspuren innerhalb der Funktionen oder Tools selbst. Gespräche mit dem, wenn der Agent mit tatsächlichen Benutzern interagiert oder Feedback aus der Umgebung, wenn der Agent in einer Sandbox Umgebung läuft und diese selbst modifiziert. Argumentationsspuren und Tool Ergebnisse sind meiner Ansicht nach jedoch nur die Zutaten zur Erstellung von Erinnerungen. Sie sind jedoch keine eigenständigen Erinnerungen. Stellen Sie sich vor, wir würden jedes einzelne Rohdetail jedes Gesprächs oder jeder Erfahrung speichern, die wir je geführt haben. Es ist einfach nicht effizient oder praktisch und bis zu einem gewissen Grad überflüssig und unnötig. Ähnlich verhält es sich mit Agenten. Sie sollen bestimmte Erkenntnisse aus ihrem Arbeitsgedächtnis extrahieren und im Langzeitgedächtnis speichern. Wenn Sie beispielsweise ein Simulationsvideospiel entwickeln, möchten Sie vielleicht, dass der Agent bestimmte Charaktereigenschaften, Beziehungen zwischen den Figuren im Spiel oder wichtige Ereignisse im virtuellen Leben der Figur extrahiert. Bei computergestützten Agenten möchten sie vielleicht erfolgreiche oder auch fehlerhafte Aktionssequenzen protokollieren. Oder bei der Codegenerierung möchten sie vielleicht alle Anweisungen menschlicher Experten protokollieren, die der Agent während der Interaktion mit einem Menschen erhält oder auch Fehler und deren Lösung. Beim Erstellen von Erinnerungen ist außerdem der richtige Zeitpunkt zu berücksichtigen. Ich habe das vor ein paar Tagen für einen persönlichen Assistenten ausprobiert, was ziemlich faszinierend war. Dabei stellte ich fest, dass LLMs ein gutes Gespür dafür haben, wann sie Erinnerungen erstellen, abrufen und aktualisieren sollten. Sie können den Agenten dabei unterstützen. So können sie beispielsweise den Agenten anweisen, Erinnerungen zu erstellen, sobald eine neue Eingabe eingeht. So kann er jede Antwort beeinflussen. Oder sie können ihn Erinnerungen basierend auf bestimmten Bedingungen erstellen lassen. Wenn beispielsweise das Kontextfenster des LM kurz vor dem Erreichen des Maximums steht, führen Sie eine Speichererstellungsoperation durch oder etwas deterministisch Ihres z. B. Nach X Gesprächsrunden. Lassen Sie ihn dieses Tool aufrufen. Und um Erinnerungen zu erstellen. Ich fand das Kontextfenster faszinierend und sehr sinnvoll, da Argumentationsketten und Gespräche ziemlich lang werden können. Dadurch besteht das Risiko, dass das Kontextfenster des LM voll ist, bevor der Agent überhaupt die Chance hat, Erinnerungen zu erstellen. Das fand ich eine sehr gute Lösung. Oder Sie können den Agenten am Ende jedes Gesprächs anweisen, Erinnerungen zu erstellen, und schließlich haben sie die Möglichkeit, Erinnerungen nach einem Zeitplan zu erstellen, z. B. Stündlich oder nächtlich. Diese Entscheidung hängt jedoch davon ab, wie der Kompromiss zwischen Anpassungsfähigkeit und Latenz für ihre Anwendung aussieht. Denn letztendlich ist das Erstellen von Erinnerungen eine zusätzliche Aktion, die der LM ausführen muss, was zusätzliche Schritte im Prozess und damit zusätzliche Latenz bedeutet. Ein weiterer Punkt, den Sie beim Erstellen von Erinnerungen bedenken, ist deren Speicherung für die spätere Verwendung. Andernfalls würden Erinnerungen im Kontextfenster des LM verbleiben und für zukünftige Benutzergespräche nicht verfügbar sein. Daher speichern wir sie in einer externen Datenbank und rufen sie bei Bedarf im Arbeitsspeicher des Agenten oder LM ab. Ich denke, das wird sich in Zukunft ändern, da LMS möglicherweise in der Lage sein wird, Erinnerungen zu optimieren oder wie ich es nenne, selbst zu optimieren. Aber im Moment benötigen wir meiner Meinung nach einen externen Persistenzmechanismus. Beim Speichern von Erinnerungen ist es daher auch wichtig zu überlegen, wie man sie so modelliert, dass sie effizient abgerufen und aktualisiert werden können. Wie Sie sicher schon beim Erstellen von Anwendungen gesehen haben, gibt es verschiedene Möglichkeiten, Daten zu speichern und zu modellieren. Ich möchte jedoch auf einige wichtige Muster eingehen. Alle Erinnerungen haben einen zeitlichen Aspekt. Daher ist es immer hilfreich, einen Zeitstempel für die Erstellung oder Aktualisierung zu haben. Dies hilft ihnen beispielsweise beim Filtern nach Zeitstempel, Priorisieren nach Aktualität, Ausblenden von Erinnerungen und Ähnlichem. Dies funktioniert gut für episodische Erinnerungen, für Erinnerungen an Entitäten oder prozedurale Erinnerungen. Wie Systemaufforderungen ist es sinnvoll, eine zentrale Informationsquelle zu pflegen, die sich mit neuen Informationen aktualisiert. Die Herausforderung besteht darin, Erinnerungen regelmäßig abzugleichen und zu komprimieren, um ein übermäßiges Wachstum zu verhindern. Es gibt jedoch Möglichkeiten, damit umzugehen, beispielsweise durch Zusammenfassungen. Super. Wir haben also über das Erstellen und Speichern von Erinnerungen gesprochen. Sprechen wir nun über das Abrufen. Bevor wir über verschiedene Techniken zum Abrufen sprechen, wollen wir kurz darüber sprechen, wann Langzeiterinnerungen abgerufen werden sollten. Der Zeitpunkt ist ziemlich wichtig. Man könnte das den Agenten überlassen oder den Prozess steuern. Bei Sims könnte man beispielsweise vor jeder Aktion Erinnerungen abrufen, um beispielsweise zu bestimmen, was eine bestimmte Figur als nächstes tut, basierend auf ihren vorherigen Aktionen oder um die Interaktion zwischen zwei Figuren zu steuern. Oder bei der Computernutzung könnte man vergangene Aktionssequenzen bereits in der Planungsphase des LM extrahieren, um die Planung der aktuellen Aufgabe zu unterstützen. Oder bei der Codegenerierung könnte man entscheiden, Erinnerungen nur dann abzurufen, wenn ein Fehler auftritt, um zu prüfen, ob es in der Vergangenheit Lösungstechniken gibt. Wenn es also darum geht, relevante Erinnerungen abzurufen, können wir Erkenntnisse aus der Entwicklung von Such und vielleicht auch REC-Anwendungen gewinnen und dieselben Techniken auf dieses neue Problem des Gedächtnisabrufs anwenden. Das einfachste Suchmuster, das beim Gedächtnisabruf helfen kann, ist die exakte Übereinstimmung. Dabei werden Informationen anhand eines bestimmten Kriteriensatzes abgerufen. Nehmen wir also das Beispiel von simps. Angenommen, zwei Charaktere unterhalten sich. Wenn ich die Namen dieser Charaktere extrahieren kann, kann ich dieses exakte Übereinstimmungsmuster verwenden, um die semantischen Erinnerungen, die ich über beide Charaktere habe, in das Arbeitsgedächtnis des Agenten zu extrahieren. Auch hier ist die Vektorsuche anwendbar. Für diejenigen unter Ihnen, die mit dieser Technik nicht vertraut sind, ruft die Vektorsuche Informationen basierend auf Absicht und Bedeutung mit Hilfe einer speziellen Art von numerischen Vektoren, sogenannten Einbettungen, ab. Wenn Sie schon einmal REC Anwendungen entwickelt haben, wird diese Technik dort häufig verwendet, gilt aber auch für dieses Problem. Nehmen wir also an, Sie haben vergangene Aktionssequenzen eines Agenten in einer externen Datenbank gespeichert. Bei einer neuen Aufgabe können Sie die Vektorsuche verwenden, um während der anfänglichen Planungsphase des Agenten ähnliche Sequenzen zu extrahieren und diese für die neue Aufgabe zu nutzen. Eine weitere Technik, die Sie vielleicht schon kennen, ist die Hybridsuche, die die Vorteile sowohl schlüsselwortbasierte als auch vektorbasierte Ansätze kombiniert. Nehmen wir also das gleiche Beispiel wie Die aktuelle Aufgabe des Agenten ist der Kauf eines Artikels bei Amazon. Die Hybridsuche kann also nicht nur Aktionssequenzen für ähnliche Aufgaben abrufen, sondern auch dazu beitragen, Amazon spezifische Sequenzen während des Abrufs abzurufen oder zu priorisieren. Schließlich können Sie Erinnerungen, die mit einer dieser Suchtechniken abgerufen wurden, neu bewerten und neu ordnen, um Kriterien wie Aktualität oder Wichtigkeit zu berücksichtigen. Nehmen wir das Beispiel einer SIM. Ich mag dieses SIM Beispiel irgendwie sehr Es ist so leicht nachvollziehbar, also eine SIM, in der ich episodische Erinnerungen an die Figur John Lin aufgezeichnet habe. Nehmen wir an, diese beiden Dokumente wurden per Vektorsuche abgerufen und haben die Werte 96 und 88. Sie können diese Bewertungen ändern, indem Sie beispielsweise eine Abklingfunktion auf den erstellten Zeitstempel anwenden. Deshalb habe ich gesagt, dass ein Zeitstempel eingefügt werden soll. Beachten Sie, dass das ältere Dokument etwas niedriger gewichtet wird, da ich neuere Dokumente gegenüber älteren priorisieren möchte. Außerdem kann ich eine Wichtigkeitsbewertung hinzufügen, um die Wichtigkeit einer bestimmten Erinnerung zu verdeutlichen. Diese Bewertung lässt sich mit Hilfe eines LLM während der Erstellung generieren. Nehmen wir an, ich habe das getan und in meiner externen Datenbank gespeichert. Beispielsweise ist die Erinnerung an Johns tägliches Einschlafen weniger wichtig als die Erinnerung an Johns Hochzeit. Deshalb habe ich die Wichtigkeit der Erinnerung an seine Hochzeit höher gewichtet. So können Sie auch einen ganzheitlich eren Bewertungs und Abrufmechanismus für die Erinnerungen der Agenten schaffen. OK, lassen Sie uns kurz auf die Aktualisierung von Erinnerungen eingehen. Wenn Agenten mit der Zeit neue Informationen lernen, müssen einige Erinnerungen möglicherweise korrigiert oder aktualisiert werden. Am einfachsten geht das, indem man die Abruf Erstellungs und Aktualisierungsvorgänge zusammenfasst. Egal in welchem Rhythmus Sie Erinnerungen erstellen, Sie rufen relevante Erinnerungen ab, aktualisieren sie bei Bedarf und speichern sie wieder auf Ihrem externen Speicher. Hier ein Beispiel dafü Angenommen, Sie speichern die Eingabeaufforderungen Ihres Agentensystems auf Ihrem externen Speicher. Beim ersten Aufruf des Agenten rufen Sie die Eingabeaufforderung ab und geben, dass es sich um eine Eingabeaufforderung zur Codegenerierung handelt. Während der Interaktion des Agenten mit dem Benutzer sagt der Benutzer Hey, jedes Mal, wenn Sie eine Funktion generieren, fügen Sie auch die entsprechenden Zeichenfolgen für diese Funktion ein. Der Agent kann diese neuen Informationen nutzen, um daraus zunächst eine Erinnerung zu erstellen, sie mit den abgerufenen Erinnerungen abzugleichen und diese aktualisierte Erinnerung zurück in die Datenbank zu schreiben. Und schließlich sprechen wir über das Löschen von Erinnerungen. Warum sollten wir Erinnerungen löschen wollen? Wäre es nicht großartig, wenn sich Agenten an alles erinnern könnten, was sie jemals getan oder gelernt haben? Nicht ganz Basisspeicher ist günstig, aber wenn Sie Speicher und Abruf auf Enterprise Niveau mit Redundanz, Backup und schnellem Zugriff benötigen, steigen die Kosten exponentiell mit zunehmendem Datenvolumen. Es ist zudem Verschwendung, Daten oder in diesem Fall Speicher, die lange nicht genutzt wurden, weiterhin zu speichern. Und schließlich ist mehr nicht besser, wenn Sie Speicher und benötigte Dinge nicht schnell finden können. Die schrittweise Löschung ungenutzter Speicher kann die Abrufleistung verbessern, indem Sie den Suchraum und die Latenz ihrer Anwendungen überschaubar hält. Daher sollten wir von Zeit zu Zeit Speicher löschen. Dies erreichen Sie, indem Sie wie mit anderen Daten umgehen, typischerweise durch die Einführung einer Datenlebenszyklusrichtlinie. Ich habe es in der Vergangenheit so Ich beobachte Nutzungsmuster und verschiebe ungenutzte Daten in einem bestimmten Rhythmus, den Sie anhand dieser Nutzungsmuster festlegen, auf günstigere, etwas langsamere Archivspeicher. Unabhängig von der Nutzung würden Sie außerdem Aufbewahrungsfristen festlegen, um die ältesten ungenutzten Speicher regelmäßig zu löschen. Das war's. Das ist mein Speedrun zur Verwaltung von Langzeitspeichern in Agenten. Ich weiß, ich komme fast an meine Zeit heran. Deshalb möchte ich kurz zusammenfassen, was hoffentlich Ihre wichtigsten Erkenntnisse aus diesem Vortrag sind. Speicher manifestiert sich in verschiedenen Anwendungen unterschiedlich. Sie mögen in jeder Anwendung dieselben Typen haben, aber ihre Bedeutung ist unterschiedlich. Wie wir gesehen haben, unterscheiden sich die Dinge von einer SIM-Karte über die Computernutzung bis hin zu anderen Anwendungen. Nicht alle Speicher sind gleich, was die Art Ihrer Speicherung, ihren Abruf und ihre Aktualisierung betrifft. Wenn Sie also über Speicherverwaltung nachdenken, müssen Sie möglicherweise unterschiedliche Verwaltungsmechanismen für verschiedene Speichertypen in Betracht ziehen. Die Speicherung aller Speicher von Anbeginn der Zeit ist in großem Maßstab nicht praktikabel und ehrlich gesagt verschwenderisch. Und schließlich halte ich Langzeitspeicherverwaltung für eine Schlüsselkomponente für AGI. Im Moment läuft es über externe Speichersysteme, aber ich denke, in Zukunft könnte es in die Gewichte der LMS selbst eingebettet werden. Aber egal, wie der Mechanismus aussieht, ich denke, damit KI Agenten ihr volles Potenzial entfalten können, müssen wir über Speicherverwaltung nachdenken. Ich hoffe also sehr, dass Sie beim Aufbau komplexerer Agentensysteme bei der Arbeit auch über das Langzeitgedächtnis nachdenken. Und Hier ist mein LinkedIn QR Code, falls Sie in Kontakt bleiben möchten. Ich hoffe, das werden Sie. Und ich denke ups, lassen Sie mich zurückgehen. Das war's von mir. Ich denke, wir haben noch etwa eine Minute Zeit für Fragen. Ja.
Ich bin neugierig auf Ihren Kommentar zum Unterschied zwischen Protokollen und Speicher, da ich mit solchen Suchsachen eigentlich keine Erfahrung habe. Punkt. Bisher konnten wir alles, aber Wir haben die Flexibilität, später zu speichern. Entschuldigung, es gibt ein bisschen Lärm. Könnten Sie das bitte wiederholen? Ich frage mich nur, wie Sie den Unterschied zwischen Protokollen und Speicher einschätzen. Bisher protokollierten wir alles, aber wir haben die Flexibilität, wenn wir versuchen, ungewöhnliche Dinge zu analysieren. Der Anwendungsfall kann auf einen späteren Zeitpunkt verschoben werden, und wenn wir den Speicher verwenden, wie Sie es beschrieben haben, überlassen wir dem die Entscheidung, was gespeichert werden soll. Manchmal treffen wir bereits Entscheidungen, wenn wir speichern. Da Sie auch Protokollexperte sind, habe ich Ihre Erfahrung in diesem Bereich bemerkt. Ich frage mich also, wie Sie zu Protokollen und Speicher stehen.
Ja, ich denke, der Anwendungsfall ist etwas anders. Wenn Sie beispielsweise alle Ihre Daten durchsuchen möchten, wenn Sie eine REC Anwendung erstellen, ist es sinnvoll, alle Ihre Daten dort zu speichern. Wenn Sie Daten jedoch als Speicher für den Agenten speichern möchten, benötigen Sie diesen Detaillierungsgrad nicht. Ich denke, es läuft auf zwei verschiedene Anwendungsfälle hinaus. Also. Ich denke, ich kann das auseinandernehmen, Kann.
Das langfristig dazu beitragen, zusätzliche zu vermeiden.
Es könnte zum Beispiel dazu führen, dass Sie episodische Erinnerungen protokollieren und einen Computer haben, der an Anwendungsfälle oder Codegenerierung gewöhnt ist, bei denen Fehler protokolliert werden. Je nachdem, was Sie im Speicher protokollieren, könnte dies dazu beitragen, Halluzinationen zu reduzieren oder den Agenten zuverlässiger zu machen.
Wenn Sie Ihr Langzeitgedächtnis nicht aktualisieren, kann dies ebenfalls zu Halluzinationen führen.
Also ja, wenn Erinnerungen nicht korrekt abgeglichen werden, könnte es einfach nur erfunden sein. Heute Morgen habe ich beispielsweise informationen zu einem MongoDB-Sticker nachgeschlagen und ihn Hey, was weißt du über mich? Und er Ich glaube, du magst MongoDB Sticker sehr und bist so ein mysteriöser Technikfreak oder so etwas in der Artikel. Wenn es also so interpretiert, was ich frage, dann könnte es auch zu weiteren Halluzinationen führen. Danke.










