#CloudUniversity Mejores prácticas de implementación durante el proceso de migración.
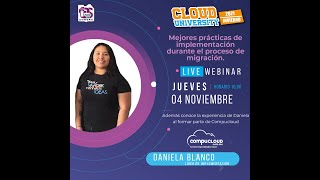
Best practices for implementing student integration and scholarship programs during cloud migration to AWS CompuCloud. Covers concrete strategies for managing the transition process and ensuring smooth adoption of new systems.
Buenos días, así es un gusto tenerlos por aquí. Creo que ya somos una buena cantidad de personas y podríamos comenzar entonces con la presentación acorde a la agenda. OK, muy bien, gracias. OK, listo. Muy bien, pues bueno, vamos a comenzar acerca de esta primera sesión que vamos a tener con ustedes, va enfocada principalmente a platicarles un poco de mi experiencia, platicarles un poquito más acerca de alguna charla técnica, enfocada en este caso las mejores prácticas de implementación en algún proceso de migración. Muy bien, voy a comenzar con mi experiencia, me voy a presentar con ustedes para los que no hayan estado en la sesión anterior quizás del Hackathon o la edición anterior. Soy Daniela Blanco, líder del Departamento de Implementación. Soy egresada de la carrera de Ingeniería en Sistemas en el Instituto Tecnológico de Minotitlán. Prácticamente nuestras escuelas son hermanitas y bueno, yo en su momento también participé en un Hackathon. Muy bien, en mi caso fue la edición del año 2019 y bueno, ya llevo prácticamente dos años y medio aproximadamente en empresa. Ha sido una trayectoria bastante interesante desde cómo inicia, mis antecedentes o precedentes al Hackathon y en el cómo se fue evolucionando a lo largo de estar en la organización. Ya estaba en el campo laboral, obviamente es muy diferente a cuando estamos en la escuela, ya las cosas son diferentes, ya no estamos como quien dice estudiantes para una buena nota, sino que estamos estudiando para estar implementando ciertos recursos. A final de cuentas, estos recursos van a ser para los clientes implementar cargas de trabajo con buenas prácticas que puedan cumplir con los requisitos que el cliente ha solicitado, por ejemplo. Bien, les platico un poco de mi desarrollo partiendo del hackathon. En este caso, digamos que el primer reto una vez que se completa este hackathon que pasamos o que fuimos algunos de los seleccionados, bien, el primer reto en la organización siempre es la certificación de Cloud Practitioner. Tengo entendido que, bueno, en el TEC de Zamora están, creo que con la plataforma de Educate de AWS, eso es excelente, de verdad les va a brindar mucha información. Sin embargo, yo lo complementaría también con algunos otros recursos. En mi caso yo utilicé por ejemplo, la plataforma de Udemy en su momento. No siempre es necesario pagar por un curso, hay muchos recursos que son gratuitos y que podemos obtener simplemente con tener una cuenta. Hay otros que sí podemos adquirir, o sea, podemos pagar por estos cursos y son muy buenos, o sea, siempre es bueno también adquir estos cursos y no solamente tenerlos ahí como para consultarlos después, sino sobre todo aprovechar este recurso por el cual estamos pagando, que no lo consideren como una pérdida de dinero, sino consideren una inversión a final de cuentas. ¿Adicional a esto, si se dan cuenta, tengo como tres iconitos y obviamente Compu Cloud, compuclo lo coloque porque obviamente las pláticas que nos dieron previo al Hackathon si nos sirvieron de mucho, fueron de mucha ayuda y es por eso que en la organización, en la empresa se sigue con este esquema de poder darles algunas pláticas técnicas que les puedan servir a ustedes previo al Hackathon y sobre todo para su futuro, que sea información que les pueda servir de utilidad, que les digan, OK, saben qué? Este tema del que me hablaron se ve interesante, voy a indagar un poquito más, digamos, incentivar un poquito la curiosidad que se tiene. Adicional a esto, ya una vez digamos que obtuve la certificación Club Practitioner, que como les mencionaba, es la primera, es la fundamental para todos en la organización. Aquí es, digamos, por ley que el departamento de Ingeniería tenga esta certificación, pero mis compañeros no se quedan atrás, mis compañeros de ventas, de marketing, de administración también aplican para obtener esta certificación. Prácticamente todos en la organización tenemos esta primera certificación, o sea, nadie se salva de eso. Posteriormente, ya estando aquí en la organización, pues bueno, existen webinars que AWS nos brinda. Anteriormente, antes de la pandemia era workshops o webinars presenciales. Algunos temas por ejemplo, eran de migración principalmente, dado que era como mi core principal en ese momento, mi pilar fundamental. En este momento me enfocaba más en temas de migración, por eso iba webinar, tomaba webinars, iba a workshops de migración. Adicional esto, existen capacitaciones de AWS enfocadas a migraciones, cargas de trabajo de Microsoft, bases de datos, obviamente mi preparación para las siguientes certificaciones como son las isops y la Solution Architectural y bueno, temas de seguridad de AWS, Estos han sido como mi pilar a lo largo de todo el tiempo que llevo. Y bueno, aquí nos desarrollamos como por champions, Entonces yo traigo por ejemplo, los temas de resiliencia y respaldos, continuidad del negocio para las organizaciones principalmente. Bien, partiendo de aquella información que les compartí hace un momento, pues bueno, eso me fue de mucha ayuda, adicional con obviamente cursos que la empresa nos proporciona o al algunas plataformas que nos proporcionan más cursos adicionales que uno también puede adquirir en otras plataformas, ya depende de cada uno si vamos a seguir con los pads que tenemos aquí, pero siempre es bueno complementar con información adicional, en este caso a mí me fueron de ayuda también algunos cursos externos para complementar la información que ya teníamos y bueno gracias a estos también junto Associate y Solution Architect Professional que prácticamente son las tres que tengo en este momento, estas dos junto con la Practitioner. Y bien, ese fue básicamente mi desarrollo digamos previo a entrar y ya una vez estando dentro de la organización. Y ahora les voy a hablar un poquito más acerca de mi rol actual en la empresa. Como les mencionaba soy la líder del departamento de implementación, tipos de implementaciones que yo tengo son de medion y también colaboro con el departamento de Preventa, más que nada como back, en ocasiones los apoyo para algunas sesiones, algunos dimensionamientos o simplemente apoyarles, igual les iré platicando un poquito más a detalle en las siguientes slides. Y bueno, soy responsable de la seguridad de AWS, enfocándonos digamos en accesos centralizados y existe también dentro de la organización un comité de seguridad que estamos revisando constantemente haciendo auditorías, tenemos sesiones para ver qué otras mejoras podemos implementar en la organización, sobre todo para que cada departamento cuente con los estándares de seguridad dependiendo las funciones que van a llevar a cabo, porque no es lo mismo la seguridad que necesita el departamento de administración a la seguridad que necesita digamos el departamento de ingeniería. Obviamente los datos que se tratan en cada departamento es diferente, obviamente necesitan un trato diferente cada uno de ellos. Bien, ¿Cuál es el objetivo de este departamento? A final de cuentas el objetivo es poder garantizar la satisfacción del cliente mediante una correcta implementación, en este caso de los servicios. Estos servicios digamos que parten de lo que Preventa le propone al cliente, ya el cliente tiene la decisión de digamos elegir cuál de las opciones, la opción A o la opción B es la más adecuada. Se pueden hacer obviamente dimensionamientos acorde a lo que necesita y bueno con lo mínimo necesario acorde a lo que necesita y obviamente dimensionamientos un poquito más avanzados. De hecho la finalidad de la plática, de la sesión es poder comentarles cuáles son aquellos puntos fundamentales y cuál es aquel digamos servicios que nos pueden ayudar a optimizar Bueno, prácticamente esa es la finalidad del departamento de implementación. Obviamente vamos acorde a un plan de trabajo que nosotros utilizamos o establecemos con la herramienta de Monday, de la cual más adelante les platicaré un poco. Como líder de implementación, mis responsabilidades son, por ejemplo, gestionar el seguimiento oportuno de cada uno de los proyectos, garantizar la generación oportuna de los planes de trabajo, que como les comentaba, todo seguimiento y todo plan de trabajo lo vamos a desarrollar en la plataforma de Monday. La verdad es que es una herramienta que nos sirve muchísimo, no solamente para este tipo de proyectos de implementación con el cliente, incluso para proyectos internos o simplemente para control a lo mejor de, por ejemplo, algunas licencias que tengamos que ir comprando sucesivamente constantemente y prácticamente todos en la organización tenemos acceso a este recurso. Bien, también parte de mis responsabilidades son garantizar los cierres de proyectos eficientes, la gestión oportuna de los cambios, digamos, en cuanto a cambios me refiero a que a lo mejor el cliente se da cuenta que en realidad la propuesta B era mejor que la propuesta, pero ya había aceptado la propuesta A, entonces es gestionar con su ejecutivo de cuenta, con el ingeniero de preventa, para que nos puedan apoyar y hacer el cambio de cotización en este caso, para que el cliente la pueda volver a aceptar y en el caso de implementación poder avanzar acorde, podemos decir, una nueva orden de trabajo si lo queremos ver de esta forma. Y el otro punto es innovar constantemente. El departamento de implementación, a final de cuentas estamos buscando cómo optimizar ciertas actividades, cómo ir mejorando el departamento a través de algunos procesos que podamos ir desarrollando, pueden ser procesos nuevos o simplemente mejoras en los procesos que nos ayuden a optimizar los tiempos o implementar ciertos recursos que permitan facilitar la implementación de los proyectos de los clientes. Por ejemplo, hablándoles acerca de las implementaciones de Medion a High y el tema de Preventa Back, OK, les voy a platicar en el caso de implementaciones un poco acerca del proceso que seguimos. Hay que seguir cierta metodología o lineamientos que nos permitan generar de forma oportuna cada proyecto de implementación. Digamos, no solamente es que el vendedor confirme con el cliente ya una venta, sino que necesitamos cierta información, digamos que del lado de implementación no podemos trabajar desde cero, necesitamos por ejemplo, el escenario que el cliente aceptó para saber qué es lo que necesita y poder tener una sesión de kick up. Todo esto lo gestionamos a través de una plataforma que se llama CRM Dynamics. Mediante esta plataforma se nos asignan casos con la información del cliente, contacto, contratos, órdenes de compra, el escenario o el dimensionamiento que aceptó el cliente y nosotros con esta información ya podemos trabajar. Se genera un plan de trabajo acorde al escenario que fue aceptado por el cliente y procedemos a agendar una sesión de kick off en la cual el departamento de ventas nos presenta con el cliente. En ese momento nosotros aprovechamos la sesión para recabar la información necesaria para poder generar una implementación óptima. Posteriormente, una vez que ya tenemos la sesión de Kicos, empezamos con la implementación, se les presenta el plan de trabajo en Monday, vamos avanzando con una transferencia de conocimiento y con una memoria técnica que a final de cuentas es lo que le presentamos o entregamos al cliente. Mira, esto fue lo que te implementamos, tienes estos recursos, estas son sus características y necesitamos que nos lo firmen. Con esta memoria técnica firmada, vaya, nosotros lo que hacemos es cerrar el proyecto y hacer la transición hacia el departamento de Customer Success. Y bueno, en Preventa Back, como les comentaba, más que nada apoyo en ciertas sesiones de dimensionamiento, si están enfocadas más que nada a temas de continuidad de negocio, respaldos de ERP, por supuesto, creo que soy yo la persona que voy a estar apoyándolos continuamente para estos temas, dado que como les comentaba fue como el punto principal en donde me estuve capacitando en un inicio. Entonces digamos que si vamos a Champions, que cada una en la organización tiene como un champion específico, el mío sería este de continuidad de negocio. Bien, en cuanto a las implementaciones, también les mencionaba que utilizamos Monday, que les dije que es una plataforma que nos sirve para gestionar los proyectos y adicional utilizamos cloudcraft. Cloudcraft lo utilizamos haciendo una integración, una relación de confianza entre la cuenta del cliente y la plataforma de cloudcraft. Y lo que nos permite es generar diagramas de forma automatizada. En este caso, estos diagramas nos permiten conocer cómo está la infraestructura de un cliente que ya tiene recursos en AWS y nos ayuda también a la generación de la memoria técnica, dado que en la memoria técnica colocamos ciertos diagramas, entonces utilizamos Clockcraft de base para poder ver cómo quedó la relación entre los recursos. Digo, de manera inicial siempre utilizamos ya luego van agarrando experiencia y prácticamente ya sabes cómo está la relación, no necesitas la herramienta. Pero si nos da un vistazo general de cómo se va relacionando los recursos e incluso el flujo de comunicación, por ejemplo, entre grupos de seguridad. Como parte de ser responsable de seguridad en AWS, les mencionaba que existe un comité de seguridad que estamos constantemente generando, auditor, revisando cómo nos encontramos en compliance, la organización, pero también me enfoco en temas de la consola. Tenemos una consola centralizada de accesos y vaya, yo me encargo de gestionar y administrar estos accesos centralizados para los ingenieros de la organización y para los demás departamentos que necesiten acceso a esta consola u otra consola que podamos tener. Más que nada también es auditar la seguridad interna de la organización y implementar ciertas políticas y lineamientos de las cuentas de AWS. Aquí implementamos un esquema en el que no se tenga que estar teniendo varias cuentas o varias credenciales de las diversas consolas de los clientes, sino que de forma centralizada podemos hacer un salto a la cuenta mediante una relación de confianza que se crea. Este proceso se llama Cross Account Roll, no solamente es para los usuarios, sino que se pueden hacer este tipo de cross account también entre recursos para obtener cierta comunicación, por ejemplo, de un usuario de una cuenta a un bucket de s de una cuenta. Este esquema sirve para diversas cosas, vaya. Y bueno, creo que no lo puse en un inicio, pero también un tema de colaboraciones en las cuales he estado es Service Delivery Program, estos son programas de AWS que avalan la capacidad del partner para ciertas cargas de trabajo. En este caso participé, colaboré con Pedro que es el departamento de DevOps en el SDP de cargas de trabajo de Windows Server para y actualmente también traigo temas de Google Architect, comencé ciertas colaboraciones, ahorita es una de mis principales actividades, los Well Architects, que son aquellos assessments que vamos generando hacia los clientes con la finalidad de evaluar en qué punto se encuentra su carga de trabajo. Este es un assessment de aproximadamente 55 preguntas y nos permite conocer cómo se encuentra el cliente. De esto se parte para determinar cuáles van a ser las remediaciones que se tengan que hacer y al hacer remediaciones vamos a aumentar el nivel de porcentaje de cómo compliance en cuanto a las mejores prácticas de AWS. Básicamente esta fue mi plática en cuanto a mi experiencia en la organización, en cómo me he desarrollado y en un momento más Vamos a comenzar con la presentación técnica. OK, listo. Bien, la presentación técnica va a tratar acerca de las mejores prácticas de implementación durante el proceso de migración. Elegí, digamos, las mejores prácticas porque es importante conocer cuáles son aquellas prácticas fundamentales con las cuales debemos contar y aquellas prácticas que pueden no ser fundamentales, pero que son importantes que nos permiten reforzar u optimizar la infraestructura que ya tenemos. Me voy a enfocar en estas prácticas principalmente en temas de seguridad, espero que también les sea de ayuda para el hackathon. Ya saben que se tiene que desarrollar una arquitectura en la cual se deben implementar temas de seguridad, entonces creo que sí va a ser una buena charla. Me voy a enfocar en la información más relevante. Yo sé que es un tema bastante extenso, pero me voy a enfocar en aquellos puntos relevantes o fundamentales para que puedan tener una buena arquitectura. ¿Y por qué en el proceso de migración? Bueno, en realidad vamos a establecer ciertos como esquemas de conectividad para la migración. No vamos a tratar un caso de uso particular, sino que les voy a hablar también acerca de algunos servicios de migración que ustedes pueden utilizar, que puede ser de ayuda también para este tema del hackathon, del reto técnico, vaya. Bien, la agenda se va a dividir en tres La habilitación de un ambiente seguro, que prácticamente lo fundamental, ahorita les voy a hablar un poquito más de ello. Tenemos también las estrategias de migración, que les voy a hablar acerca de los servicios que ustedes pueden utilizar para generar diversas migraciones dependiendo el caso de uso en particular. Y el último punto es reforzando la seguridad en la nube, que aquí ya vamos a entrar en temas de optimización o trazabilidad incluso. Muy bien, OK, comenzando con estos temas de seguridad, un poquito más en temas de seguridad, de las buenas prácticas, les quiero hablar acerca de los pilares del camino evolutivo de la seguridad. Son varios, tomé los más importantes a mi consideración y lo dividí en un tema fundamental, eficiente y optimizado. Muy bien, como les mencionaba, la sesión se encuentra dividida en tres partes. La primera es la base y la segunda, bueno, la tercera parte es el refuerzo de seguridad. En este caso el fundamental va a ser la primera parte y el eficiente y optimizado va a ser cómo vamos a reforzar esta carga de trabajo, pero mediante algunos servicios de los cuales les voy a hablar un poco Pero ¿Por qué la evolución en la seguridad? Bueno, el principio de toda seguridad sea en AWS, en cualquier otra nube o incluso en on premise es aprovechar las diversas tecnologías que se pueden tener para poder para poder proteger los datos, sistemas y los activos en forma tal de que podamos mejorar esta posición de seguridad. Con activos nos referimos a cualquier tipo de dato o aplicación que la organización o la carga de trabajo pueda tener. Ya digamos que esto va a ser muy dinámico si lo vemos así, no todas las cargas de trabajo son iguales, pero tienen en común los datos y los sistemas. Los datos son la parte fundamental que más debemos de proteger. Pero ¿Cómo lo podemos proteger? ¿Qué estrategias debemos implementar? Bueno, es de los que les voy a hablar a continuación. Vamos a comenzar con habilitación de un ambiente seguro, comenzando con aquellos principios de diseño, también hay varios principios de diseño, lo enfoqué a lo más fundamental, en este caso implementar una base de identidad sólida y aplicar la seguridad en todos los niveles. Creo que ya por los títulos se podrán ir dando cuenta de que vamos a estar hablando un poquito más y vamos a comenzar con implementar una base de identidad sólida. Como pueden observar del lado derecho tenemos algunas prácticas, son los puntos que vamos a tratar en este primer punto, implementar una base de identidad sólida. Y bueno, básicamente este punto se refiere a implementar el principio de privilegio mínimo. ¿A qué nos referimos con esto? Nos referimos principalmente a aquellas políticas o permisos que se pueden asignar ya sea a un usuario o algún acceso programático, en caso, como bien saben en la consola podemos tener tanto usuarios como accesos programáticos, uno va a ser de acceso a la consola y el otro puede ser para acceso mediante CI o mediante o la interacción entre recursos, más que nada algún servicio que pueda necesitar permiso para acceder a algún servicio B, depende mucho de eso, básicamente es aplicar la segregación de tareas con la autorización indicada para cada una de las interacciones con los recursos. Enfocándonos un poquito más en la organización, en los usuarios, podemos decir que este esquema o permisos de privilegios mínimos se va a enfocar en la función que tenga cada uno de los colaboradores dentro de la organización, digamos el DBA, el administrador de la base de datos no necesita los mismos permisos que el que administra la parte de redes, uno va a estar enfocado a permisos, digamos pueden ser puros RDS por ejemplo, y el otro va a tener puros permisos digamos de la VPC para la administración de toda la red de la VPC. Entonces hay que ir, podemos decir acotando dependiendo al rol los permisos que va a tener cada uno de los usuarios, si pueden existir este permisos base para todos, por ejemplo que cada uno pueda cambiar su propio password o este visualizar datos específicos, va a ir dependiendo mucho de lo que haga la organización y de cuál sea el rol de esta persona en empresa. También es importante definir una correcta clasificación de los recursos BUYA, ya que esto nos permite establecer una base sólida para las cuentas de AWS, por eso vemos más abajito también un tema de etiquetado de recursos y alarmas de billing, ahorita van a ver la relación entre cada uno de ellos. Bien, continuando con este tema vamos a comenzar con el uso de MFA y privilegios mínimos, ¿Por qué lo puse junto? En este caso a final de cuentas todos se encuentran en el servicio de IAG o no es un MFA token y el otro simplemente son políticas o permisos que se pueden asignar a los diversos recursos, principalmente usuarios o roles. El dispositivo MFA lo que provee es una protección adicional a los recursos de AWS. Estos tipos de tokens pueden ser virtuales, pueden ser físicos, pueden ser las llaves, las llaves prácticamente son como un USB que se puede conectar a la máquina o bien puede tener como la huella registrada. Hay diversas, en el caso del virtual está Auti, Google Authenticator, Microsoft Authenticator y prácticamente creo que son esos tres los que se utilizan y el físico si está un poquito más delimitado a los gemalto y acaban de añadir uno nuevo, está como que muy segmentado. Usualmente los clientes les recomendamos el virtual, de hecho también cada que terminamos una implementación a ellos se les hace una transferencia de conocimiento, como les comentaba anteriormente, partiendo esta transferencia de conocimientos aprovechamos esta sesión que tenemos en conjunto con el cliente ya prácticamente para cerrar el proyecto, para entregarle sus accesos, darles una de las personas que tiene acceso a la consola configure su MFA, se los dejamos prácticamente activos. Esta es una muy buena práctica porque muchas veces ha pasado que a lo mejor alguien está compartiendo sus credenciales con otra persona, esto es una muy mala práctica, compartir las credenciales con otra persona es una mala práctica porque qué tal si se pelean con esta persona o esta persona ya no forma parte de la organización y sigue teniendo acceso a la cuenta pues es un riesgo de seguridad que quizás la otra persona hace digamos esta maldad por decirlo así afecta a la organización y al final de cuentas el usuario que va a aparecer en Cloud Train va a ser el de la persona de la cual pertenece la cuenta, la persona que compartió estas credenciales entonces por ello es importante siempre contar con un token aunque otra persona pueda conocer tus credenciales muy bien pero no va a tener acceso a este token entonces no va a poder ingresar a la consola y no va a poder generar como acciones maliciosas y bueno el esquema de privilegios mínimos ya les hablé un poquito, su principio es garantizar solo los permisos para completar una tarea como les mencionaba esto va a ir mucho en función del rol que tenga la persona en la organización y sobre todo de las acciones que ellos tengan que generar a cabo bien, como les dije pueden tener una un esquema de permisos base, esto se puede gestionar a través de grupos también se los voy platicando, pueden gestionar estos permisos a través de grupos si son varias personas que van a tener este mismo permiso o que pueden crear por ejemplo un grupo administración, grupo base de datos, grupo redes y le van a asignar la política correspondiente este es un aquellos que tienen algunos permisos base y que comparten ciertos permisos en común pero este es el punto fundamental sea para un usuario o sea para un acceso programático siempre es importante delimitar las acciones que éste tiene que llevar a cabo si por ejemplo con nuestro acceso programático vamos a estar accediendo o administrando a lo mejor los buckets de s para copiar datos OK, no hay que brindarle el acceso total a la consola sino que solamente vamos a tacharle una política para administración de s tiene que tener el MFA activo un usuario para poder generar ciertos movimientos esto incluso por ejemplo en la organización lo que hago con mis compañeritos ya los inge saben es que las cuentas o bueno las políticas de las cuentas de los clientes tienen esta condición en el que quizás se les desactivó el MFA en la consola de accesos pero al momento de que se hacen el switch a la consola de cliente OK, si van a poder acceder pero si tienen que generar alguna actividad, gestionar algo en específico a lo mejor activar algún recurso no lo van a poder hacer porque no tienen activos un MFA, si se van a poder loguear y van a poder visualizar todos los recursos acorde a la política, pero no van a poder hacer ningún movimiento. Entonces esta es otra estrategia que se puede implementar en las políticas para que si una persona desactivó su MFA, OK, sí, sí puedes acceder a tu recurso y puedes ver que tienes, si necesitas cierta información la puedes obtener pero no vas a poder hacer ningún movimiento. Era lo que les comentaba anteriormente de compartir credenciales. Si tenemos también activa este MFA, evitamos aquellos movimientos maliciosos y aquí también entra el tema de que sea una persona la que les esté administrando el uso de MFA para que no se lo estén activando y desactivando y puedan generar estas actividades maliciosas o actividades que no están en compliance con la organización. ¿Va a ser muy variable esto, OK? Luego tenemos el tema de Access Analyzer. Aquí Access Analyzer es un servicio que nos permite estar, digamos, identificando si los recursos se encuentran comunicándose o se encuentran compartidos con entidades externas. Las entidades externas vienen siendo aquellas otras cuentas, pueden ser cuentas de AWS principalmente, de hecho se asocian con un ID, cada ID de las cuentas de AWS tiene un ID específico, este es muy particular y existen ciertos recursos que Access Analyzer puede estar detectando, por ejemplo, los roles de i, los buckets, las funciones lambda, las llaves de KMS y las colas de SQS son algunos de los recursos que Access analizan puede detectar y esto digamos que se revisa en base a los permisos que se puedan tener en cada uno de los roles y Access Analyzer utiliza lo que es como un tipo de razonamiento lógico para detectar identidades externas, digamos que no se programa, este es una característica que solamente nosotros tenemos que activar y por sí solo Access Analyzer comienza a trabajar utilizando el razonamiento lógico y haciendo match con las políticas que puedan existir en los diversos roles, por ejemplo, para detectar entidades externas. Y una vez que genera como este reporte, lo que se puede hacer es analizar obviamente la información ya de forma manual para detectar cuáles son aquellas cuentas que se encuentran como activas. Si ves que es una cuenta conocida, aunque la puedes archivar y ya lo manda digamos como a una lista blanca, pero en caso contra, en caso de que no, que no sea así, lo que hace es que te va a seguir marcando estas cuentas y bueno, ya uno tiene que tomar las acciones correspondientes para revisar el rol, revisar el bucket de la política que exista, por ejemplo, que se encuentra asociada al recurso y ver cuáles son los permisos que tiene. También digamos como adicional a Access Analyzer dentro de cada uno de los usuarios nosotros podemos visualizar en función de la política que tenga asignada en este caso el usuario o el rol, podemos visualizar un apartado de cuáles son los servicios que tiene activo, si tenemos una política y si le colocamos el asterisco después del permiso, por ejemplo, del servicio, sabemos que le estamos dando todo el permiso sobre ese recurso, sobre ese servicio en particular. Pero al visualizar dentro de, digamos en un esquema de auditorías, al estar revisando esta parte de accesos del usuario, podemos ver, o sea, ya un poquito podemos decir tangible hasta cierto punto, o sea ya un poquito más visual cuáles son aquellos servicios a los cuales están accediendo y ya puede partir de ello. Otra cosa es que también actualmente AWS digamos que vinculó el servicio de cloudtrade con IAG para poder generar políticas personalizadas acorde a un tiempo específico. Obviamente todas aquellas llamadas APIs, todos aquellos movimientos que se hagan en la consola quedan registrados en cloudtrade, es nuestra base fundamental para ver quién hizo movimientos no deseados o quién hizo un movimiento específico que alguien a lo mejor haya eliminado algún recurso, no se tenía que eliminar, pues durante 90 días al menos podemos estar visualizando estos blogs propiamente en la consola. Si queremos información adicional, pues bueno, ahí entra un esquema de hacer una relación de confianza quizás con otra cuenta o simplemente con un bucket de s en la misma cuenta para poder ir almacenando estos logs y añadir una retención de tiempo diferente, ya va a ser muy variable también acorde a la organización y a cuánto tiempo quiere tener de retención en cuanto a logs para auditoría. Pero bien, al hacer esta integración de i con CloudTrail, lo que se buscaba es poder irle delimitando, digamos un poquito más, pero de forma automática los permisos que puedan tener. Esto nos sirve para, por ejemplo, si le asignamos un Administrator Access a una persona solamente para ir evaluando, digamos, cuáles son aquellas acciones que comúnmente lleva a cabo y quizás esta persona solamente estaba accediendo a RDS, por ejemplo, o puro s, aunque con CloudTray ya definimos un tiempo específico y bueno, nos va a acotar o generar una política acorde a ese periodo de tiempo y acorde a las acciones que se fueron generando. Esa también es una buena práctica. Incluso digo Access Analyzer nada más por control total, pero puede ser un Power User por ejemplo, y partir de ello para delimitar los permisos un poquito más y ya acorde a todo lo que se pueda definir con Access Analyzer podemos ver la interacción que existe y cuáles son aquellos recursos que se encuentran activos. Bien, entrando al tema de etiquetado de recursos, ¿Cuál es la importancia del etiquetado de los recursos, de los tags en estos recursos? Bien, nos permiten asignar permisos en base a los tags, por ejemplo, permitir solamente acceso a los ambientes específicos, ese es el punto principal. Nosotros tenemos la práctica en implementación de colocar tags a los recursos, los vamos asociando, por ejemplo, por default le colocamos un nombre, fecha de creación, nuestro tag para poder asociar las políticas de Lifecycle Manager para el tema de respaldos, el nombre del sistema operativo y el ambiente también, dependiendo cuántos ambientes tengan, si sabemos que solamente tiene un ambiente productivo, lo podemos dejar así, si sabemos que tiene múltiples ambientes de desarrollo y QA, colocamos los tags específicos. ¿Por qué colocamos también estos tags en el lado de Customer Success? ¿Al momento de que hacemos una transición? A ellos les sirve esta información para poder generar una administración de los recursos. Esto muy adicional de que se comparte la memoria técnica, se tiene centralizada en una carpeta específica en la cual todos los ingenieros de soporte de servicios profesionales tenemos accesos para consultar en qué último punto se encontraban los clientes al momento de que dejaron la implementación e hicieron la transición para, por ejemplo, la activación de su póliza. Entonces, esta información les sirve También, por ejemplo, el tema del sistema operativo lo colocamos porque muchas veces en la información que nos brinda cuando seleccionamos la instancia no aparece muy específico en la AMI, o por ejemplo, si fue una recuperación de una AMY personalizada, o sea que en nuestra instancia original tuvo alguna falla, tuvimos que hacer la recuperación a través de una AMY, lanzarla desde cero, ya no nos aparece cuál es la versión. Y luego para visualizar, digo, solamente es para una vista rápida, porque si queremos saber cuál tiene, podemos entrar al screen esta instancia o bien a los logs y ahí nos indica cuál es, pero para un vistazo rápido por buenas prácticas, vamos colocando también cuál es el sistema operativo que tiene el recurso para que se pueda gestionar más rápidamente. Si necesitan validar alguna integración o compatibilidad con el sistema operativo entre algún recurso, sea inspector, sea cloudwatch, para instalar el agente por ejemplo, es más fácil visualizarlo ahí que estará yendo al screen o revisando los logs. Además nos permite identificar a los individuos o unidades de negocio responsables de los recursos, en este caso de tenerlos segmentados digamos como por ambientes o digamos la aplicación específica que contiene el recurso, nos permite tener una mejor gestión de quién tiene que estarlo administrando. Del lado de los clientes lo hacemos para que cuando ellos tengan que administrarlo también sepan qué es lo que tiene cada uno de los servidores, digo, lo pueden asociar obviamente por la IP pública o privada que tenga el servidor, pero si le colocamos un tag e incluso el nombre es bastante claro de qué es lo que tiene ese servidor, es más fácil para ellos poderlo administrar. Y el último punto es identificar recursos en conjunción con políticas con la finalidad de delimitar los accesos, es lo que les comentaba anteriormente acerca de los privilegios mínimos que podemos colocar ciertas condiciones que nos permitan estar por ejemplo delimitando el acceso a ciertos recursos como el ejemplo del bucket S que les mencionaba con el ARN del recurso, podemos estar asociando este recurso específico para que solamente puedan administrarlo. Existen otros esquemas en el cual podemos delimitar por ejemplo las políticas incluso a una IP pública específica, entonces si esa persona no está pues en esa IP se está conectando de otro lado, no se está conectando esa máquina y el lugar que usualmente lo hace no se va a poder conectar a la cuenta. En este caso, bueno, ya en los recursos ya lo delimitaremos más adelante, pero es en función de los grupos de seguridad. Y bien, esto es en cuanto a los tags, igual antes de que se me pase este, esta segmentación de ambientes o este etiquetado también nos permite este, bueno, el área de administración, por ejemplo determinar o identificar cuál es el recurso asociado a cierta, digamos a cierta cuenta factura, porque muchos clientes también piden su facturación separada por ejemplo por ambientes, entonces tenerlo segmentado también nos permite hacerlo con el tema del etiquetado y administración, le facilita pues identificar cuáles son los recursos y poder generar una factura pues más fácil, un poquito más optimizada mediante el tema etiquetados, de otra forma tendría que estar como buscando y sacando la cuenta de cuántas horas son, si a lo mejor son tres servidores con la misma capacidad, con la misma familia, pues tendría que sacar la diferencia y si a lo mejor una fue de QA o que cuánto tiempo estuvo encendida, es un poquito más complejo, entonces mediante el etiquetado se puede facilitar estas actividades. Luego tenemos el tema de las alarmas de billing, esta es otra muy buena práctica, nosotros tanto para tema de POX como para las cuentas activas como las implementaciones que se concluyen, se configura una alarma de billing. Estas alarmas de billing nos permiten identificar o colocar un presupuesto, digamos puede ser mensual en el cual nosotros podemos tenerlo asociado ya sea mensual, trimestral o anual, dependiendo si las empresas tienen un presupuesto anual, OK, se coloca de forma anual y pues ya el billing va a ir avanzando, va a ir recabando la información de forma mensual obviamente, de hecho es día a día, nos va indicando en qué punto se encuentra, solamente que del día anterior porque el día actual tarda un poquito en reflejarse, pero sabemos más o menos cómo se encuentra el billing. ¿Pero también por qué se recomienda este tema de las alarmas de billing? Nos permiten identificar potenciales ataques relacionados con la minería, por ejemplo de bitcoins o despliegues de instancias para formar parte de redes de bot y actividades inusuales en la cuenta, enfocándonos también en los ambientes, si ya una organización sabe que no tiene que estar por ejemplo generando pruebas en su consola, no tiene, o sea, ellos hacen quizás su prueba dentro del mismo servidor durante las 720 horas que éste se esté ejecutando en el mes por ejemplo, OK, ellos saben que no necesitan tener recursos adicionales encendidos bajo este escenario, simplemente cuando se activa esta alarma se les notifica, OK, saben que como que se incrementó tu billing, que estuvieron haciendo, OK, ya se valida y se pueden detectar incluso pues que a lo mejor alguien encendió un servidor, esto ocasionó que se incrementará el billing y bueno, por eso también es importante colocar ciertos porcentajes en el billing para poder ir conociendo a lo largo de por ejemplo del mes o del presupuesto establecido en qué punto se encuentra, va a lanzar ciertas alarmas a los correos que se hayan indicado y se pueden tomar acciones específicas. Por ejemplo, si es una empresa que tiene un esquema de pruebas en su cuenta de AWS, muy bien, pues se puede activar un esquema de automatización para detener o eliminar los recursos y se puede asociar el recurso específico para ello se tiene que gestionar a través de un rol para los budgets, pero si nos permite generar esas actividades y tener más control dentro de la consola y dentro del presupuesto que se tenga establecido. Bien, aplicar la seguridad en todos los niveles es el siguiente punto, esta parte fundamental. ¿Por qué la importancia de la seguridad en todos los niveles, en todas las capas? Bueno, la seguridad es la forma fundamental de los diversos niveles, ya que nos brinda de forma inicial la certeza de poder comenzar a trabajar en la nube. Pero ¿Cómo determinamos esto? Estos puntos se relacionan, parten de hecho del tema de conectividad. Procedemos con la segmentación de redes y el control de tráfico. El esquema de segmentación de redes y control de tráfico se los voy a explicar a través de un par de diagramas. Y el tema de la conectividad es el siguiente. En temas de conectividad, digamos, lo primero que se debe definir es cómo me voy a conectar a mi recurso. ¿Cuál va a ser este esquema de conexión? ¿Va a ser un esquema público en donde no necesitemos estos tres puntos de conectividad y se tengan que conectar a través de una IP pública o va a ser a través de una VPN Site to Sitesite, una OpenVPN o un Bastion Host? ¿En qué consiste cada uno de ellos? Bueno, la VPN Site to Sitesite obviamente nos permite, digamos, generar un túnel entre diversas locaciones, un túnel VPN entre diversas locaciones y nos permite tener una conexión segura, puede ser de AWS hacia alguna oficina de la empresa. Esta es una de la OpenVPN, pues simplemente es una herramienta de conectividad de tipo cliente servidor. Si nos da un poco más de versatilidad en el tema de conexión, porque quizás si no estoy en oficina me puedo conectar desde mi casa a través del cliente que se tiene configurado, ya que propiamente se les da como se genera una comunicación entre la OpenVPN y la instancia que esté generada o la RD, para poder generar esta conexión a través de una IP que OpenVPN nos proporciona. Y el tema del Base Inhost no es otra cosa más que un servidor destinado a poder realizar ciertas conexiones a los recursos ubicados en una red privada, digamos que todos los recursos se encuentran privados menos un servidor que nos permite conectarnos, este puede ser Windows dependiendo también los servidores que se tengan o puede ser Linux si es mediante una conexión SSH. Hacia los demás recursos va a ser muy variable pero hacia alguna oficina de la empresa esta es una de la OpenVPN pues simplemente es una herramienta de conectividad de tipo cliente servidor, si nos da un poco más de versatilidad en el tema de conexión porque quizás si no estoy en oficina me puedo conectar desde mi casa a través del cliente que se tiene configurado ya que propiamente usualmente son esos dos. Entre las ventajas o beneficios que podemos encontrar entre una VPN, OpenVPN y el Basion bien de la VPN es la confidencialidad e integridad obviamente de las conexiones y de los datos, podemos tener un tema de cifrado de datos en tránsito en este caso dado que como es una conexión privada pues no va a haber mayor tema y obviamente restricción de acceso porque solamente va a estar delimitado a las oficinas. En el caso de la OpenVPN pues bueno es la restricción de acceso porque si se asocia por una cuenta de cada uno de los usuarios que se genera y la ventaja es que nos puede conceder conexiones remotas fuera de sí y el basing host no es otra cosa más que una puerta de enlace. La realidad es que entre estos tres los que deberíamos darle prioridad sería una VPN site to site de primera mano y luego una OpenVPN ya se les da como bueno se genera una comunicación entre la OpenVPN y la instancia que esté generada o la RDS para poder generar esta conexión a través de una IP que OpenVPN nos proporciona y el tema del base en host no es otro, también depende mucho del tipo de carga de trabajo que tenga el cliente y sobre todo también cosa más que un servidor destinado a poder realizar ciertas conexiones a los recursos ubican el presupuesto pero es recomendado tener alguna de estas tres estrategias que no tengan ningún esquema de conectividad. Bien, vamos a comenzar con la segmentación de redes sociales que bien sabemos son redes privadas y redes públicas, esto a través de un diagrama, como pueden observar en el diagrama tenemos en este caso digamos cuatro recursos principales que serían dos instancias bajo un tema de autoescalamiento y dos RDS, en este caso dos bases de datos. En este caso las RDS pues son prácticamente de réplica, una es la principal y la otra solamente es de lectura. Reader y Reader, bien, y están bajo un balanceador de carga ubicados en una red privada. Digamos que todos los recursos se encuentran privados, menos un servidor que nos permite conectarnos, este puede ser Windows, dependiendo también los servidores que se tengan, o puede ser Linux si es mediante una conexión SSH. Hacia los demás recursos va a ser muy variable, pero usualmente son esos dos. Entre las ventajas o beneficios que podemos encontrar, hasta aquí estamos bien, tenemos la estructura necesaria para poder tener una carga de trabajo que entrega contenido, por ejemplo puede ser un e commerce. Entonces al tener este esquema estamos bien, ¿Por qué? Porque tenemos generada una subred pública, en este caso para los recursos que se encuentran en el front, que pueden ser la aplicación principalmente, y tenemos nuestros datos protegidos de nuestras RDS en una subred privada. Esta es una excelente práctica de primera mano. Hay que recordar que aunque vayamos a tener público quizás nuestra RDS, debemos de tenerlos en subredes diferentes, hay que tenerlo segmentado de tal forma que podamos tener nuestra RDS en una sola subred y nuestra aplicación en otra subred. Y ya podemos ir generando cuantas subredes necesitemos para las diversas zonas de disponibilidad, sobre todo si vamos a estar bajo un esquema de balanceador o auto scaling, es necesario poder contar con al menos dos zonas de disponibilidad para el balanceador de carga, puede ser la zona 1, la zona 2, la que ustedes deseen encontrar entre una VPN, Citusa y la OpenVPN, y el Basion bien de la VPN es la confidencialidad e integridad obviamente de las conexiones y de los datos. Podemos tener un tema de cifrado de datos en tránsito, en este caso dado que como es una conexión privada, pues no va a haber mayor tema. Y obviamente restricción de acceso porque solamente va a estar delimitado a las oficinas. Y sobre todo por ejemplo contemplar al momento de generar una que digamos que AWS nos dé la recomendada, la zona recomendada y nosotros seleccionamos la otra ya específico diferente de la que nos recomendó AWS. Usualmente AWS te recomienda aquella que digamos puede estar un poquito menos transitada, si lo vemos así, hace esa recomendación pero al final de cuentas todas las zonas de disponibilidad no siempre, entonces siempre hay que contar mínimo con dos subredes, una privada, una pública y cada una con al menos dos zonas de disponibilidad, esto por buenas prácticas y sobre todo porque en caso de que una zona de disponibilidad llegase a fallar podamos tener otra zona de disponibilidad activa. Ya posteriormente se pueden hacer diversos esquemas de la OpenVPN, pues bueno, es la restricción de acceso porque si se asocia por una cuenta de cada operación para poder tratar de recuperar nuestros datos, uno de los usuarios que se genera y la ventaja es que nos puede conceder conexiones remotas fuera de sitio y el Basing host no es otra cosa más que una puerta de enlace. La realidad es que entre estos tres los que deberíamos darle pilatos y que la carga de trabajo siga funcionando en estado óptimo, pero ya va a depender también de las estrategias que quiera la organización en este caso. Posteriormente pasamos al control de tráfico, la diferencia entre el diagrama anterior y este es que en este podemos visualizar lo que son los grupos de seguridad. ¿Por qué es importante limitar los grupos de seguridad? Esto va a partir del esquema de conectividad que nos puedan estar brindando, bueno que haya seleccionado el cliente de forma inicial, sea una VPN site to site, la OpenVPN, el Basion o sin algún esquema de conexión, sino a través de la IPS pública en este caso. Bien, bajo este escenario ya una vez que tenemos delimitado nuestro esquema de conectividad, si es una VPN site to site, pues en realidad no nos tenemos que preocupar tant sería una VPN site to site de primera mano y luego una OpenVPN ya si no un base en host. También depende mucho del tipo de carga de trabajo que tenga el cliente y sobre todo también el presupuesto, pero es recomendado tener alguna de estas tres estrategias que no tenga ningún esquema de conectividad. Viento Si es importante delimitar siempre el flujo de conexión de comunicación que va a existir entre cada uno de los recursos. Este se pueden asociar obviamente Security Groups con Security Group, eso no hay ningún problema, pero si hay que delimitarlo a los puertos. Pero si es un esquema público, bajo ese escenario tendríamos que estar como delimitando a través de las IP públicas de las personas o del sitio del cual se van a estar conectando para para delimitar lo más posible, porque sí existen los ataques obviamente e incluso pueden estar llegando a través del balanceador de carga, pueden estar haciendo peticiones, temas de bots que puedan estar quizás obteniendo información quizás no de forma maliciosa pero siempre es un riesgo, entonces por eso es importante limitar los puertos, principalmente los de conexión RDP, el de base de datos, el SSH, dependiendo del sistema operativo hay diversos puertos que tendrían que estar delimitando de forma inicial. Vamos a comenzar con la segmentación de redes que bien sabemos son redes privadas y redes públicas, esto a través de un diagrama, como pueden observar en el diagrama tenemos en este caso digamos cuatro recursos principales que serían dos instancias bajo un tema de autoescalamiento y dos RDS solamente segmentándolos a las IPs públicas del sitio o de la máquina de la cual se van a estar conectando y obviamente delimitar acerca de los puertos de entrega de contenido entre las instancias y los balanceadores se pueden configurar obviamente grupos de seguridad, por ejemplo 84.43 delimitado a 80 84.43 del balanceador, no se hacemos esa delimitación para no dejar campos abiertos y bueno vamos a hablarles acerca ahora de las estrategias de migración CAS 2 Bases de datos Bien en este caso las RDS pues son práctica de forma general tenemos el rehost que es el leaf and sheets, este es el más utilizado por los clientes, tenemos el replatform, report, relocate y refactor, esos son como los principales ticamente de réplica, una es la principal y la otra solamente es de lectura breaded y reader y están bajo un balanceador de carga. OK, hasta aquí estamos bien, tenemos la estructura necesaria para poder tener que existen en leaf Cheese consiste en simplemente automatizar utilizar una herramienta de migración, de hecho nos vamos a enfocar más que nada en esta estrategia de migración para los servicios que se van a utilizar. El siguiente pues replatform nos permite utilizar alguna herramienta pero sí consiste en determinar una nueva plataforma, por ejemplo comenzamos con un rehogar en donde migramos nuestro servidor, nuestra aplicación que viene un monolito por ejemplo, ya que estemos migrados ya podemos proceder a un tema como de modernización, una carga de trabajo que entrega contenido por ejemplo puede ser un e commerce hasta cierto punto en donde podemos pasar la base de datos hacia una RDS y aquí lo que estamos haciendo es determinando una nueva plataforma para este recurso, estamos modificando entonces al tener este esquema estamos bien, ¿Por qué porque tenemos generada una subred pública en esta cierta forma la inform infraestructura del recurso y ya procedemos con un tema de validación, la transición y las operaciones correspondientes para validar que todo esté funcionando en un estado óptimo? Caso para los recursos que se encuentran en el front, que pueden ser la aplicación principalmente y tenemos nuestros datos protegidos de nuestras RDS en una subred privada, hay temas de pasar, en lugar de hacer una migración, pasar nuestra red, nuestra aplicación, por ejemplo un tema de contenedores o comprar todo desde cero, básicamente volverlo a hacer, eso sería un poquito más como con temas de licenciamiento y la refactorización, pues bueno, es prácticamente rediseñar todo. La realidad es que en estrategias de migración el rehost sería lo recomendado de forma inicial para que no sea una transición tan dura la que tiene, que esta es una excelente práctica de primera mano. Hay que recordar que aunque vayamos a hacer una transición más transparente para el cliente para poder ir digamos creciendo en la nube, o sea que se vaya acostumbrando, que vaya modernizando de poco en poco, de hecho en el público quizás nuestra RDS debemos de tenerlos en subredes diferentes, hay que tenerlo segmentado de tal forma que podamos tener nuestra RDS en una sola subred y nuestra aplicación en otra subred y ya podemos ir generando cuantas. Se puede hacer por ejemplo una migración y hacer una de Google Architect para poder ir viendo cuáles son aquellos puntos de vulnerabilidad. Si lo vemos así, no es una auditoría, no lo queremos decir como una auditoría, pero sí nos sirve para medir como el nivel de compliance en el que se encuentra una carga de trabajo. Bien, existen ciertas metodologías de AWS, de migración de aplicaciones, lo principal por ejemplo es tener nuestra planeación, en ella vamos a estar definiendo nuestra estrategia y el diseño, vamos a ir clasificando cuál es la aplicación más importante, cuál es la lógica, vamos a evaluar necesitamos para las diversas zonas de disponibilidad, sobre todo si vamos a estar bajo un esquema de evaluar el perfil del cliente para determinar cuál sería la mejor estrategia. Y entramos balanceador o auto scaling. Es necesario poder contar con al menos dos zonas de disponibilidad para el balanceador de carga, puede ser la zona 1, la zona 2, la que ustedes deseen, la parte de diseño donde se va a estar generando el plan de migración, cuál va a ser la top y sobre todo, por ejemplo, contemplar al momento de generar una red, o sea, se va a estar haciendo toda, digamos, ir viendo cuál va a ser como la arquitectura que va a tener el cliente durante el proceso de migración, vamos a estar preparando la infraestructura, es básicamente lo que les comentaba anteriormente de la parte fundamental, ir viendo cuáles son aquellas partes fundamentales que es nuestra parte de diseño para poder generar una migración. Al entrar en la migración, OK, ya empieza lo que es, por ejemplo, la instalación de los agentes correspondientes, la habilitación del ambiente, digamos, on premise, por ejemplo, de hacer la integración de las aplicaciones con infraestructuras que AWS nos dé la recomendada, la zona recomendada y nosotros seleccionamos la otra ya específico diferente de la que nos recomendó AWS. Usualmente AWS te recomienda aquella que digamos, puede estar un poquito menos transitada si lo vemos así, pero al final de cuentas todas las zonas de disponibilidad no sirven, dura y todas estas actividades y la transición no es otra cosa más que ir validando la funcionalidad, vamos haciendo algunas pruebas pilotos para que el cliente pueda ir accediendo a los recursos, ir validando por qué sus servicios no funcionan. Cabe mencionar que, digamos, no es por arte de magia que hacer una migración y ya está listo tu servidor, no, es un proceso que requiere pruebas, que requiere levantar el servidor no una, sino puede ser hasta tres o más veces para que el cliente pueda ir viendo. Entonces siempre hay que contar mínimo con dos subredes, una privada, por qué mi servicio no levantó, qué necesito hacer para que mi servicio levante de forma automática. Básicamente esos son los puntos que se deben de hacer a una pública y cada una con al menos dos zonas de disponibilidad. Esto por buenas prácticas y sobre todo porque en caso de que una zona de disponibilidad llegase a fallar, podamos tener otra zona de disponibilidad activa. Ya posteriormente se pueden hacer diversos esquemas de rese durante este tema de transición es ir evaluando el por qué no funciona la aplicación, porque el recurso si está claro, porque no funciona la aplicación y hacer las modificaciones correspondientes. Y ahí entra el tema también de ejecución, en donde se va a hacer una capacitación, obviamente al personal, cómo se va a estar monitoreando este recurso, este que tenemos que hacer cuando exista algún problema, cómo puedo, por ejemplo, si fue un DRP, aunque cómo puedo accionar mi doctor y un tema de mejora que no es otra cosa más que estar monitoreando constantemente la carga de trabajo, operación para poder tratar de recuperar nuestros datos y haciendo alguna integración continua o despliegues de nuevos servicios o bien mediante un Wellatos y que la carga de trabajo siga funcionando en estado óptimo. Pero pues ya va a depender también de las estrategias que quiera la organización, en este caso como les mencionaba anteriormente, que nos permita conocer en qué punto se encuentra la carga de trabajo y poder aplicar mejoras. Las mejoras no solamente son esos sobre los recursos que ya se tienen, sino ir optimizando. ¿OK? Posteriormente pasamos al control de tráfico, la diferencia entre o reforzando lo que se tiene con nuevos servicios o nuevas metodologías por ejemplo también bien, tenemos ciertas herramientas de migración, les voy a hablar un poco de ellas, son cuatro Migration Hub, nos sirve de forma general para estar monitoreando y los otros son los servicios como tal para poder estar generando las migraciones. De manera inicial tenemos las herramientas de migración que el diagrama anterior y este es que en este podemos visualizar lo que son los grupos de seguridad, porque es importante, no son otras cosas más que herramientas que nos permiten generar una migración transparente limitada a los grupos de seguridad. Esto va a partir del esquema de conectividad que nos pueden estar brindando, bueno, que haya seleccionado el cliente de forma inicial, sea una VPN site to site, la OPD hacia el cliente de una forma segura y sin grandes inversiones de basion o sin algún esquema de conexión, sino a través de la IP. Usualmente AWS tiene estos recursos sin un costo adicional, dependiendo también si es un DRP, si te cobra por ejemplo por clovendur, pero si es una migración no tiene un costo adicional de servicio más que los recursos que se vayan a estar lanzando en la consola. Entonces AWS te apoya de esa forma porque bueno está buscando que a final de cuentas los recursos se puedan subir a la nube de ellos. Entre algunos beneficios podemos tener migraciones sencillas, minimizar los tiempos de inactividad, porque es una, por ejemplo un pública en este caso. Bien, bajo este escenario, ya una vez que tenemos el límite aplicado de información que se hace en segundo plano, entonces no tenemos inactividad en los recursos. Existe obviamente la reducción de costos, sí, porque al momento de que se puedan estar migrando nuestro esquema de conectividad, si es una VPN site to site, pues en realidad no nos tenemos que preocupar tanto sí es importante delimitar siempre el flujo de conexión de comunicación que va a existir entre cada uno, están pagando por ejemplo 100 dólares por un servidor de forma mensual, pueden que ahora estén los recursos, se pueden asociar obviamente Security Group con security group pagando 50 porque estaban sobreaprovisionado y estamos optimizando también su infraestructura para que trabaje con lo que en realidad necesita y no esté sobrado este servidor. Se puede tener un mayor control en cuanto a temas de migración, nosotros podemos estar como configurando los templates o características que va a tener este nuevo servidor, eso no hay ningún problema, pero si hay que delimitarlo a los puertos, pero si es un esquema público incluso si existe algún error que hubo algún cambio en la capacidad que se quería OK, podemos cambiar por ejemplo la capacidad de cómputo necesaria a una familia diferente. La configuración usualmente de estos servicios es rápida, es sencilla y es bajo ese escenario tendríamos que estar como delimitando a través de las IPs públicas de las personas o del sitio del cual se van a estar conectando para delimitar lo más posible porque sí existen los ataques obviamente e incluso pueden estar llegando a través del balance un proceso fiable, o sea nos da esa fiabilidad de que la integración de los recursos va a ser de forma transparente, muchas veces no es más que una gente que se tiene que instalar y todo el esquema de la planificación o la configuración de los planes se tiene que hacer a través del servicio ya propiamente en la consola o en la página específica del servicio como tal. Bien, como les mencionaba está AWS Migration Hub que este es digamos que prácticamente nos provee esta locación para servor de carga, pueden estar haciendo peticiones, temas de bots que puedan estar seguir el proceso de las migraciones como menciona aquí el texto, esta herramienta también nos permite seleccion cuál va a ser la herramienta que puede ofrecer un mayor beneficio al cliente, quizás obteniendo información, quizás no de forma maliciosa pero siempre es un riesgo, entonces por eso es importante alimentar los puertos. La visibilidad que nos esté ofreciendo de las migraciones entre el portafolio de aplicaciones nos da como una vista general, sin embargo ya es cuestión de principalmente los de conexión RDP de base de datos, digamos del ingeniero que haya estado a cargo que defina cuál sería la mejor estrategia, eso nunca lo dejamos de lado si nos apoyamos de las documentaciones, pero siempre es importante conocer qué es lo que el cliente necesita para poder determinar la mejor estrategia de migración en este caso. Para eso también existe en el caso de Migration Hub un panel de migración, esto nos da visibilidad, nos da un dashboard de en qué punto se encuentra y cuáles son aquellas aplicaciones que se están migrando y conocer el estatus de las mismas, incluso el tiempo que ha transcurrido el SSH, dependiendo del sistema operativo hay diversos puertos que se tendrían que estar delimitando de forma inicial entre una y otra de las migraciones que se esté llevando a cabo. Posteriormente tenemos también el seguimiento de la migración, este es un tema más específico acorde a la aplicación específica que solamente segmentándolos a las IPs públicas del sitio o de la máquina estamos migrando, podemos visualizar en qué estatus se encuentra, cuál fue la herramient que se está utilizando, se van a estar conectando y obviamente de alimentar acerca de los puertos de entrega de contenido entre las instancias y los balanceadores se pueden configurar obviamente grupos de seguridad, por ejemplo, cuál fue el último date, los resultados, ya nos brinda información adicional de seguimiento, si bien podemos dar seguimiento dentro de las propias aplicaciones, Migration Hub nos provee información más específica de cómo está trabajando nuestra herramienta, en qué punto va y cuánto, cuál ha sido, si hubieron problemas incluso, OK, sabes que hubieron problemas aquí, este es el porcentaje a lo mejor de migración. Bien, entre la integración de las herramientas como les mencionaba esta SMS, este nos permite importar imágenes de 84.43 delimitado a 80.84.43 del balanceador, máquinas virtuales de ambientes existentes, ambientes listos para usarse en instancias de AWS, o sea hacemos esa delimitación para no dejar campos abiertos. Y bueno vamos a hablarles acerca ahora de las estrategias de migración, este básicamente genera como AMI si lo queremos ver así. Luego tenemos CLO de forma general, tenemos el rehost que es el leaf sheets, es porque provee migraciones en tiempo real de manera automatizada hacia AWS desde ambientes físicos, virtuales u otras nubes. Y posteriormente está DMS que nos ayuda a migrar bases de datos de manera fácil y segura, les iré platicando un poquito más de ellos para que lo puedan ir conociendo. Server Migration Service, este es un servicio que automatiza la migración de aquellas máquinas virtuales on premise hacia la nube de AWS y consiste simplemente estar generando como réplicas incrementales de los servidores como máquinas virtuales o como AMI si los queremos ver así que era lo que les decía básicamente al generar una AMI digamos la manda más utilizado por los clientes tenemos el replat por ejemplo a un bucket de s se hace un proceso como report, relocate y refactor, esos son como los principales de conversión y se genera la AMY correspondiente si bien en este servicio vamos a tener como una app que existen en leaf and Cheese consiste en simplemente automatizar utilizar una herramienta de pérdida de datos si lo vemos así porque no es una replicación continua, si son incrementales de hecho nos vamos a enfocar más que nada en esta estrategia de migración pero al momento si pueden silenciarse por favor bien ya que como les mencionaba nos permite generar las amis y bueno obviamente va a existir una pérdida de los datos dependiendo en qué punto exista una falla o en qué hora fue el último incremental el proceso de configuración es instalar en este caso un conector de migración que nos va a permitir obtener la información en este caso como son máquinas virtuales bueno para los servicios que se van a utilizar el siguiente pues replatform si nos permite utilizar alguna herramienta pero sí consiste en determinar una nueva plataforma por ejemplo comenzamos con rehost en donde migramos nuestro servidor, nuestra aplicación que viene, ver cuál es el tipo de servicio que se está utilizando por ejemplo si es bingware, un monolito por ejemplo ya que estemos migrando ya podemos proceder a un tema como de modernización, instalar el conector en la aplicación de VMware, hacer la integración, regresar a AWS para seleccionar la máquina virtual a migrar, configurar lo que es el horario de replicación y la frecuencia y posteriormente lanzar la instancia de EC desde la AMI para esto quiere decir que ya se generó nuestro proceso de replicación, si ocurrió algún detalle durante el proceso de migración y los servidores fallan, OK pues quizás a lo mejor hubo no sé 30 minutos de diferencia entre el último incremental porque si tiene que tomar una imagen a final de cuentas para poder estar generando la AMI que vamos a poder hasta cierto punto en donde podemos pasar la base de datos hacia una rds recupera en una instancia de ec y el paso 4 y aquí lo que estamos haciendo es determinando una nueva plataforma para este recurso, estamos modificando pues básicamente es bueno repetir este proceso de replicación de forma automática según la frecuencia específica dependiendo las necesidades del cliente también va a ser de cierta forma la infraestructura del recurso y ya procedemos con un tema de validación, la transición y las operaciones correspondientes para validar que todo esté funcionando en un estado óptimo, la programación que se vaya a estar definiendo que consiste básicamente en programar, cargar, convertir y la creación de la AMI, que bueno, son los puntos que se indicaban a partir del paso 2 si lo vemos así. Posteriormente entramos a la herramienta de cloud, CloudEndure es un servicio que nos permite generar, hay temas de pasar, en lugar de hacer una migración, pasar migraciones a la nube, incluso DRP, que era lo que les mencionaba, con el DRP la herramienta tiene un costo adicional y con la migración no existe costo adicional más que los servicios que se estén, pues nuestra aplicación por ejemplo en temas de contenedores o generando dentro de la consola de AWS pueden hacerse recuperaciones como les decía desde físico virtual o nube con un esquema de replicación continua y comprar todo desde cero básicamente volverlo a hacer, eso sería un poquito más como con temas de licenciamiento y la refactorización pues. Pues bueno, es prácticamente rediseñar todas automatizadas de máquinas y orquestación de pilas de aplicaciones. La ventaja entre CloudEndure y el servicio que les mencionaba anteriormente de Service Migration Service es que CloudEndure está replicando constantemente la información, de hecho voy a pasar a la siguiente, pero les voy a platicar el funcionamiento antes de entrar en cómo va replicando la información. Cloendur Se necesita un agente instalado en el servidor, se genera un área de ensayo en este caso en donde se va a estar recibiendo la información de los volúmenes club, se va a llevar la estructura que tenga el servidor tal cual, si el servidor tiene tres volúmenes te bajo. La realidad es que en estrategias de migración el reho sería lo recomendado de forma inicial para que no sea una transición tan dura la que hagan, tiene que ser una transición más transparente para el cliente para poder ir, digamos generar tres volúmenes en comparación con una AMI que puede estar unificando, creciendo en la nube, o sea que se vaya acostumbrando, que vaya modernizando de poco en poco, de hecho los volúmenes en uno solo. Gloventure mantiene la estructura que tiene el servidor, esto entra a un esquema de replicación continua, La replicación continua digamos prácticamente cada 10 minutos está generando puntos de recuperación, pero incluso es mejor que SMS. Posteriormente entra un tema de coordinación y conversión de las máquinas, esto ya va a depender cuando nosotros queremos generar las pruebas, podemos estar haciendo esta conversión, se genera un nuevo servidor que va a procesar como este snapshot que se generó, este punto de recuperación, se genera este servidor para procesar esta información y poder convertirlo en un EC, se puede hacer por ejemplo una migración y hacer un un assessment de Google Architect para poder ir viendo cuáles son aquellos puntos de vulnerabilidad, si lo vemos así, si genera snapshots, digamos del volumen hasta cierto punto total, no es una auditoría, no lo queremos decir como una auditoría, pero si nos sirve para medir como, pero Cloudendor ya lo va separando el momento de que hace el lanzamiento de los recursos, existe el nivel de compliance en el que se encuentra una carrera de trabajo, existe la conmutación por error y la conmutación por recuperación, que son dos esquemas para el lanzamiento de los recursos que existen dentro de la consola. En el momento en el que se puede estar detectando un error, obviamente se estaría lanzando este nuevo recurso, se estaría apuntando a este nuevo recurso para que el cliente pueda recuperar su productividad prácticamente a los 10 minutos, no diría al momento, pero sí a los 10 minutos, ¿No? Por el proceso que tarda de lanzarse este recurso y nos ofrece un tema de recuperación o de retención más que nada hasta 90 días en este caso. ¿Bien, existen ciertas metodologías de AWS de migración de aplicaciones, lo principal por ejemplo es tener nuestra planeación, en ella vamos a estar definiendo nuestra estrategia y el diseño, vamos a ir clasificando cuál es la aplicación más importante, cuál es la lógica, vamos a evaluar En cuanto a la arquitectura, pues bien, tenemos este esquema como tal les mencionaba, se hace la instalación de la gente y mediante el puerto TCP comienza un proceso de replicación, para ello obviamente tienen que pasar por un esquema de validación de el perfil del cliente para determinar cuál sería la mejor estrategia y entramos a instalación de la gente en donde a final de cuentas valida si cumple con los requisitos, lo vemos así, esta es la consolidación, administración y básicamente se necesita el puerto 443 para poder estar administrando como aquellos templates para poder generar la migración con el TCP en el puerto 1500 comenzamos la replicación y entra al área de espera en donde está replicando, digamos en este caso los cinco volúmenes en cinco EV que se tachan a una sola instancia para poder estar almacenando la información, OK? Y ya bueno, acorde a como la planificación o el template que tenemos, se van a estar generando los servidores de la parte de diseño donde se va a estar generando el plan de migración, cuál va a ser la topología de red, o sea, se va a estar haciendo toda, digamos ir viendo cuál va a ser como la arquitectura que va a tener el cliente durante el proceso de migración, vamos a estar preparando de destino en caso de que exista algo problema, si es un DRP o simplemente por el esquema de migración que se tiene y aquí vamos a poder esta infraestructura es básicamente lo que les comentaba anteriormente de recuperándonos en producción o pasando nuestra producción a la nube en caso de ser necesario. Bien, es en cuanto a cloud y en cuanto a temas de Database Migration Service, que es obviamente el servicio que nos permite facilitar la migración de bases de datos relacionales, almacenes de datos, bases de datos no SQL y otros tipos de almacenes de datos. Bueno, esta es la herramienta adecuada. Aquí tenemos cuáles son aquellas bases de datos compatibles que podemos estar migrando a través de este servicio y tenemos en el siguiente slide la combinación de orígenes y destinos. Prácticamente podemos la parte fundamental ir viendo cuáles son aquellas partes fundamentales que es nuestra parte de diseño para mirar desde cualquier origen hacia Amazon en este caso, pero sí que poder generar una migración. Al entrar en la migración, OK, ya empieza lo que es por ejemplo la instalación de los agentes correspondientes, la habilitación de queremos migrar por ejemplo hacia hacia otra nube, no está soportado. Usualmente estos servicios solamente nos permiten migrar hacia recursos en AWS, por ejemplo, en el ambiente, digamos on premise, por ejemplo, de hacer la integración de las aplicaciones con infraestructura en lugar de estar migr por ejemplo hacia un premise, de un premise a un premise, no está soportado y otra no ve a on premise, tampoco está soportado. De ahí en fuera podemos hacer migraciones hacia nuestros recursos en EC o bases de datos específicas, bueno, servicios administrados de bases de datos específicos. El funcionamiento y la arquitectura de DMS consiste en identificar cuál va a ser el origen de nuestros datos, cuál va a ser este origen que tenemos y hacer la configuración de los puntos de enlaces correspondientes de origen y destino, tal cual. Posteriormente se aprovisiona una instancia de replicación. A final de cuentas esta instancia de replicación es la que va a estar gestionando los datos que vamos a estar migrando. Más adelante les voy a hablar, bueno en el siguiente slide les voy a hablar de cuáles son aquellos como métodos o todas estas actividades y la transición no es otra cosa más que ir validando la funcionalidad, vamos haciendo algunas pruebas pilotos para que el cliente pueda ir accediendo a los recursos, ir validando por qué sus servicios no funcionan, tareas de replicación que se pueden configurar y por último es crear la tarea de replicación específica, dependiendo cuál va a ser el tipo de estrategia que vamos a estar siguiendo. Ya una vez que tenemos mencionar que digamos, no es por arte de magia que hacer una migración y ya está listo, hemos definido todos estos pasos, pues bueno, dependiendo cuál sea nuestro origen, lo vamos a estar migrando o replicando hacia nuestro destino. Este proceso también es de forma transparente, no necesita estar inactivo el servicio y en caso de que exista alguna falla en estos recursos de origen, OK, nos podríamos recuperar en esto. ¿Para ello servidor no es un proceso que requiere pruebas, que requiere levantar el servidor no una, sino puede ser hasta tres o más veces para que el cliente pueda ir viendo, OK, por qué mi servicio no levantó, qué necesito hacer para que mi servicio levante de forma automática? Básicamente esos son los puntos que se deben de hacer durante este tema de transición, es ir evaluando el por qué no funciona la aplicación, porque recurso si está activo, por qué no funciona la aplicación y hacer las modificaciones correspondientes. Y ahí entra el tema también de ejecución, en donde se va a hacer una capacitación obviamente al personal, cómo se va a estar monitoreando este recurso, qué tenemos que hacer cuando exista algún problema, cómo puedo, por ejemplo, si fue un DRP, aunque cómo puedo accionar mi DRP y un tema de mejora que no es otra cosa más que estar este monitoreando constantemente la carga de trabajo y haciendo alguna integración continua o despliegues de nuevos servicios, o bien mediante un well architect como les mencionaba anteriormente, que nos permita conocer en qué punto se encuentra la carga de trabajo y poder aplicar mejoras. Las mejoras no solamente son sobre los recursos que ya se tienen, sino ir optimizando o reforzando lo que se tiene con nuevos servicios o nuevas metodologías, por ejemplo. También bien tenemos ciertas herramientas de migración, les voy a hablar un poco de ellas, son cuatro Migration Hub nos sirve de forma general para estar monitoreando y los otros son los servicios como tal para poder estar generando las migraciones de manera inicial. Tenemos las herramientas de migración que no son otras cosas más que herramientas que nos permiten generar una migración transparente hacia el cliente de una forma segura, ágil y sin grandes inversiones. De hecho usualmente AWS tiene estos recursos sin un como costo adicional, dependiendo también si es un ERP, si te cobra por ejemplo por cloventure, pero si es una migración no tiene un costo adicional de servicio más que los recursos que se vayan a estar lanzando en la consola. Entonces AWS te apoya de esa forma porque está buscando que al final de cuentas los recursos se puedan subir a la nube de ellos. Bien, entre algunos beneficios podemos tener migraciones sencillas, minimizar los tiempos de inactividad porque es una por ejemplo un replicado de información que se hace en segundo plano, entonces no tenemos inactividad en los recursos. Existe obviamente la reducción de costos, sí, porque al momento de que se puedan estar migrando, si estaban pagando por ejemplo 100 dólares por un servidor de forma mensual, este pueden que ahora estén pagando 50 porque estaban sobre aprovisionado y estamos optimizando también su infraestructura para que trabaje con lo que en realidad necesita y no esté sobrado este servidor. Se puede tener un mayor control en cuanto a temas de migración, nosotros podemos estar configurando los templates o características que va a tener este nuevo servidor e incluso si existe algún error, hubo algún cambio en la capacidad que se quería, OK, podemos cambiar por ejemplo la capacidad de cómputo necesaria a una familia diferente. La configuración usualmente de estos servicios es rápida, es sencilla y es un proceso fiable, nos da esa fiabilidad de que la integración de los recursos va a ser de forma transparente. Muchas veces no es más que una gentry que se tiene que instalar y todo el esquema de la planificación o la configuración de los planes se tiene que hacer a través del servicio ya propiamente en la consola o en la página específica del servicio como tal. Bien, como les mencionaba está AWS Migration Hub, que este es digamos que prácticamente nos provee esta locación para seguir el proceso de las migraciones como menciona aquí el texto. Esta herramienta también nos permite seleccionar cuál va a ser la herramienta que puede ofrecer un mayor beneficio al cliente dependiendo la visibilidad que nos esté ofreciendo de las migraciones. Entre el portafolio de aplicaciones nos da como una vista general, sin embargo ya es cuestión de, digamos, del ingeniero que hay estado a cargo que defina cuál sería la mejor estrategia, eso nunca lo dejamos de lado, si nos apoyamos de las documentaciones, pero siempre es importante conocer qué es lo que el cliente necesita para poder determinar la mejor estrategia de migración en este caso. Para eso también existe en el caso de Migration Hub, un panel de migración, esto nos da visibilidad, nos da un dashboard de en qué punto se encuentra y cuáles son aquellas aplicaciones que se están migrando y conocer el estatus de las mismas, incluso el tiempo que ha tenido transcurrido entre una y otra de las migraciones que se esté llevando a cabo. Posteriormente tenemos también el seguimiento de la migración, este es un tema más específico, acorde a la aplicación específica que estemos migrando, podemos visualizar en qué estatus se encuentra, cuál fue la herramienta que se está utilizando, cuál fue el último update, los resultados ya nos brinda información adicional de seguimiento. Si bien podemos dar seguimiento dentro de las propias aplicaciones, Migration Hub nos provee información más específica de cómo está trabajando nuestra herramienta, en qué punto va y cuál ha sido, si hubieron problemas incluso, OK, sabes que hubieron problemas aquí este es el porcentaje, lo mejor de migración. Bien, entre la integración de las herramientas, como les mencionaba, esta SMS, este nos permite importar imágenes de máquinas virtuales de ambientes existentes a ambientes listos para usarse en instancias de AWS. Este básicamente genera como AMI si lo queremos ver así. Luego tenemos CLO que provee migraciones en tiempo real de manera automatizada hacia AWS desde ambientes físicos virtuales u otras nubes. Y posteriormente está DMS que nos ayuda a migrar bases de datos de manera fácil y segura. Les iré platicando un poquito más de ellos para que lo puedan ir conociendo. Server Migration Service, Este es un servicio que automatiza la migración de aquellas máquinas virtuales on premise hacia la nube de AWS y consiste simplemente estar generando como réplicas incrementales de los servidores como máquinas virtuales o como AMI si los queremos ver así que era lo que les decía, básicamente al generar una AMI, digamos la manda por ejemplo a un bucket de s, se hace un proceso como de conversión y se genera la AMI correspondiente. Si bien en este servicio vamos a tener como una pérdida de datos, si lo vemos así, porque no es una replicación continua, sí son incrementales, pero, pero al momento si pueden silenciarse, por favor. Bien, ya que como les mencionaba, nos permite generar las AMIs y bueno, obviamente va a existir una pérdida de los datos dependiendo en qué punto existe.
More from Paulina
Todo sobre la Nueva Región de AWS en México | Beneficios, Infraestructura y Migración
DEMO: De VMware a AWS. Administración de ambientes dentro de la consola de AWS.