Ventajas de un plan de recuperación de desastres DRP con Amazon Web Services - Oct 2013
Avanzo presents AWS disaster recovery strategies for enterprise systems in this October 2013 technical talk. The presentation covers AWS infrastructure, cloud computing methodology, and cost-effective DRP solutions designed for Latin American businesses running ERP systems.
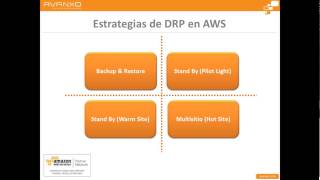
¿Vamos a dar inicio con la presentación un poco acerca de Qué es Avanzo? ¿Quién es Avanzo? Nuestro objetivo como empresa es hacer realidad los beneficios de Cloud Computing para empresas en toda América Latina. Nuestra metodología está basada en tres pilares fundamentales que garantizan el éxito de cualquier iniciativa de Cloud Computing. La primera de ellas es que optimizamos los procesos a través de la aplicación de mejores prácticas comprobadas, asegurando el logro de los objetivos estratégicos, incrementando la productividad de nuestros clientes. Nuestra estrategia Cloud está desarrollada de acuerdo a las necesidades propias de cada cliente e involucran soluciones líderes de tecnología Cloud para la optimización de sus procesos de negocio e impulsamos la correcta adopción de un modelo de trabajo basado en procesos, en herramientas, en roles, en responsabilidades y funciones que están acorde y están totalmente alineadas con metodologías de capacitación y gestión del cambio. Es aquí donde ingresa todo el tema de personas. Avanzo es pionera en hacer realidad los beneficios de Cloud Computing en América Latina. Desde nuestras oficinas de Colombia, México, Brasil y Perú cubrimos toda la región en donde hemos aplicado nuestra metodología comprobada en más de 350 implementaciones en 11 países y ayudando a nuestros clientes a optimizar sus procesos de negocio para acelerar la adopción de este tipo de soluciones en el mundo de Cloud Computing. Algunos de nuestros clientes Nuestro profundo conocimiento en tecnologías Cloud y nuestra experiencia con clientes de la talla de Telefónica, ING, Novartis, Liberty, Seguros, La Equidad o el Icfes por mencionar algunos, certifica la calidad en la ejecución de nuestros proyectos que han permitido a estas empresas y a muchas otras responder mucho más rápido a cambios en su negocio y al mismo tiempo reducir el TCO de su inversión en tecnología. Tenemos una estrecha relación con los proveedores de las soluciones de Cloud Computing más exitosas del mercado. Hemos consolidado una oferta multiproducto multiservicio basada en un portafolio de los productos líderes e innovadores en estas tecnologías. Iniciamos con Amazon Web Services, un líder indiscutible de Infraestructura como servicio. Somos partners de AWS y ofrecemos servicios sobre la plataforma de Infraestructura como Servicio para que nuestros clientes puedan elegir su plataforma de desarrollo predilecta o el modelo de TI que más se acople a sus propias necesidades de negocio. Trabajamos también con Cansiron que es el líder de integración de software y aplicaciones en la nube KUPA que es un líder en gestión de compras y gastos en la nube, DocuSign que es el principal proveedor de firma electrónica en el mundo, Google Apps, la más innovadora en comunicación y colaboración. Somos distribuidores autorizados de Google Apps que es quien lidera el mercado de soluciones de comunicación y colaboración en nube. Salesforce. COM es el líder en CRM y plataforma en la nube, es la empresa más innovadora del mundo según Forbes y es líder indiscutible de soluciones de software como servicio para la gestión de relaciones con los clientes o CRM. Avanzo fue el primer reseller de Salesforce en el mundo y hoy en día Avanzo es Premier Consulting Partner de Salesforce. Com y contamos con el mayor número de consultores certificados en Latinoamérica. ServiceNow es el líder para gestión de servicios de TI en la nube, SuccessFactors el líder en gestión y desarrollo de talento y VIVA que es una solución de CRM, la solución de CRM más innovadora de la industria farmacéutica. Todo esto de la mano de más de 350 clientes y proyectos implementados en América Latina a través de nuestros más de 120 consultores especialistas entre esas plataformas. Con respecto a Amazon Web Services, cuenta actualmente con las siguientes credenciales de socios que están avaladas por el AWS Partner Network en 2011, como channel partner que es el inicio Service Provider para poder entregar soluciones basadas en Amazon, Consulting Partner en 2012 y Advanced Consulting Partner en 2013. Gracias al volumen de proyectos que hemos implementado en Amazon, especificidad de las aplicaciones que se han implementado y a las certificaciones que han adquirido todos los especialistas que hacen parte de la plataforma en Avanzo, estas membresías y las correspondientes acreditaciones obtenidas por Avanzo demuestran que contamos con la capacidad, con la experiencia, la formación para poder implementar, operar, administrar infraestructura como servicio basado en Amazon y que Avanzo hace parte del grupo élite de compañías a nivel mundial que han alcanzado este reconocimiento y que cuentan con los incentivos que así lo demuestran. Justamente quería para este punto recalcar que contamos también con recurso humano que está certificado en ABCBP del Disaster Recovery Institute International y nuestra metodología de ERP está basada en las mejores prácticas del DRI. Para arrancar es importante poder considerar esas preguntas que ustedes ven allí en la presentación, un poco para ver en qué punto estamos y cómo podemos empezar a afrontar los requerimientos y las necesidades de negocio que apuntan hacia un plan de recuperación de desastres. Todo esto surge por la necesidad de contar con infraestructura, con sistemas y aplicaciones que estén disponibles. Justamente este tipo de tecnologías, este tipo de soluciones tienen unos altos costos y puede resultar muy complejo crecer, soportar y y mantener infraestructura de contingencia en infraestructura tradicional en centros de datos alternos tradicionales. Adicionalmente a esto se adiciona la coyuntura de respaldo geográfico de medios de backup y tener que contar con copias geográficamente distribuidas para garantizar la continuidad de nuestro negocio. Dado que el volumen de los datos que deben almacenarse sigue creciendo constantemente, las empresas se enfrentan con un aumento de los costos y la complejidad derivada de la gestión de todos estos datos. Además, nunca antes había sido tan importante proteger los datos y asegurarse de que se presentan elevados niveles de durabilidad y disponibilidad para los mismos. Un poco acerca de los antecedentes y proyección Antecedentes estadísticos Tenemos que Acronis tomó una muestra de 6.000 empresas entre pequeñas y medianas en más de 18 países de este estudio, el 33 % de ellas no invierten copias de seguridad ni en recuperación de desastres y no cuenta con el personal capacitado de TI para gestionar el sistema. De igual forma, la mitad de los 20 países más expuestos a pérdidas humanas y económicas a causa de un desastre se encuentran en América Latina y en el Caribe. De igual forma, Gartner estima que los usuarios almacenarán hasta un tercio del contenido digital global en la nube para el año 2016. Solo el 35% de las pequeñas y medianas empresas tienen un plan de recuperación de desastres efectivo, sólo el 65 % de los negocios no tienen un plan de recuperación, el 68 % de los negocios que experimentan un desastre y no tiene un plan de recuperación pueden cerrar en menos de dos años y finalmente, una compañía que experimente una interrupción en superación tecnológica que dure más de 10 días nunca se va a poder recuperar completamente. Entrando en materia durante la presentación vamos a usar dos términos comunes del sector para la planificación ante desastres que es el RTO y la RPO. El RTO es un parámetro que se corresponde con la cantidad de tiempo y el nivel de servicio al que se debe restablecer un proceso empresarial después de un desastre, de una falla o una caída con el fin de impedir o pues con el ánimo de impedir, consecuencias inaceptables que estén asociadas a la interrupción de la continuidad del negocio. Por ejemplo, si un desastre se produce a las 12 del mediodía y el RTO que se ha establecido es de 8 horas, el proceso de recuperación antidesastres debería garantizar que la recuperación del nivel de servicio aceptable para esta aplicación o para esta solución puntual fuera posible estar disponible recuperada en su totalidad a las 8 de la noche o antes y el RPO que se encarga de escribir el volumen aceptable de datos perdidos medidos en el tiempo. Por ejemplo, si el RPO establecido o requerido es de una hora, una vez se recupera el sistema, éste debería contener todos los datos hasta el punto temporal de las 11 de la mañana, ya que el desastre ocurrió al mediodía. Una empresa normalmente decide acerca del RTO y el RPO en términos de acuerdo a su función y lo que impacta financieramente para que su negocio pueda continuar cuando los sistemas no están disponibles. El impacto financiero se evalúa normalmente al considerar muchos factores como la pérdida que supone para el negocio y hasta qué punto repercute la situación en su reputación debido al tiempo de inactividad y a la falta de disponibilidad de los sistemas. Las organizaciones de TI o las áreas de TI deben programar soluciones para ofrecer de forma rentable una recuperación del sistema basada en el RPO que se haya definido dentro de una línea temporal y el nivel de servicio que es el que establece el RTO. Algunas prácticas tradicionales de inversión en recuperación de desastres Tenemos el enfoque tradicional con respecto a este tema, en el que se ofrecen diferentes niveles de duplicación exterior al sitio principal donde tengo mis datos y a la infraestructura. Estos servicios, que son los más importantes para la empresa, se configuran y se mantienen en esta infraestructura y se prueban con intervalos regulares. La infraestructura de origen y la ubicación del entorno alterno para la recuperación de desastres obligan a tener una distancia física considerable con el fin de garantizar que dicho entorno quede aislado de errores o de fallas o inconvenientes que se puedan presentar en el sitio de origen. Normalmente, la infraestructura que yo requiero o que se necesita para admitir el entorno duplicado incluiría, entre otras cosas, instalaciones para alojar la infraestructura, incluida la alimentación y la refrigeración. Seguridad para garantizar la protección física de todos los recursos que están en el sitio alterno. La capacidad adecuada para poder escalar el entorno en caso de que se active la contingencia. Soportar toda la posibilidad de reparar, sustituir y actualizar esta infraestructura según se requiera. Acuerdos contractuales con un proveedor de servicios de Internet de ISP para ofrecer conexión a Internet que pueda soportar la utilización del ancho de banda para el entorno en caso de que se presente una situación de carga máxima. Todos los temas relacionados con infraestructura de red como firewalls, switches, enrutadores, balanceadores de carga, en fin, capacidad enorme para que los servidores tengan la suficiencia para poder ejecutar todos los servicios de vital importancia, incluidos los dispositivos de almacenamiento para poder respaldar los datos, los servidores para poder ejecutar estas aplicaciones, servicios de backend como todos los relacionados con la autenticación de los usuarios, sistemas de nombres de dominio, servidores de HCP, servidores de monitoreo, en fin, la lista puede ser innumerable, pero en función de la importancia de los servicios, el entorno duplicado puede convertirse en también en un cuello botella o en un punto a tener en cuenta en el caso de que se quiera ofrecer configuración de forma tolerante a fallos para toda esta infraestructura. Esto suele implicar además la duplicación de toda la infraestructura para poder garantizar alta disponibilidad, lo que se traduce pues finalmente en una inversión, una inversión muy considerable de recursos que pueden estar subutilizados a lo largo del tiempo y también pues un gran desgaste administrativo. Es aquí donde mostramos las ventajas o por qué sería bueno o qué tiene de bueno considerar un DRP en AWS. Básicamente queremos mostrar seis características muy importantes, seis valores muy esenciales de Amazon, entre muchos otros que ofrece la plataforma. El primero de ellos es la rápida recuperación. Las empresas utilizan Amazon para poder realizar una recuperación de desastres mucho más efectiva, mucho más rápidamente para sus sistemas de TI fundamentales, sin tener que incurrir en gastos adicionales de infraestructura de un segundo sitio alterno. Es acá donde avanzo justamente puede apoyar todas las ideas o todas las iniciativas para estructurar el plan y dimensionar la infraestructura que se requiere en la recuperación antidesastres, de tal forma que se facilite una rápida implementación, una reducción efectiva de costos, un mantenimiento y un crecimiento versus a instalaciones tradicionales que se ejecutan en centros de datos locales. Otra característica esencial de Amazon es el bajo costo. Amazon permite empezar a hacer uso de la computación en la nube sin costos iniciales y sin compromisos a largo plazo. Cuando se considera el costo de TI, los clientes deben contar con todos los costos asociados con la prestación del servicio, como todos los que acabamos de enumerar en la diapositiva anterior. La ventaja o una de las opciones que se tiene acá es que podemos hacer uso de instancias de cómputo de Amazon EC, que ya lo vamos a ver en un momento, donde todos estos costos están incluidos en una reducida tarifa por hora por cada instancia. En relación con los bajos costos está además la tendencia histórica de Amazon de bajar sus precios en todos sus servicios. Esto no tiene precedentes. A lo largo de los últimos 5 años, Amazon Web Services ha reducido los precios en más de 20 oportunidades en toda su oferta del portafolio. No se trata pues de un descuento relacionado con precios debido a un exceso de inventario. Tampoco es una reducción especial de precios por un periodo promocional limitado. La computación en la nube es un juego de bajo costo pero de alto volumen y Amazon sabe muy bien hacer este tipo de estrategia, de tal forma que todo lo que hace Amazon se traslade directamente en ahorros para sus clientes. Otra ventaja que podríamos enumerar acá en el bajo costo y que está totalmente ligada a temas de ERP es que no hay cinta. Yo puedo eliminar los costos asociados con el transporte, el almacenamiento y la recuperación de medios relacionados con cinta o respaldos y adicionalmente también librar un poco de todos los temas de software asociados a la copia de seguridad en cinta. Otra ventaja muy interesante es el pago solo por uso. Yo puedo asignar recursos de acuerdo con su utilización con un beneficio tangible en ambientes de ERP, ya que puedo mantener infraestructura apagada o reducida a su mínima expresión y que esté lista para crecer cuando se active la contingencia. La nube de Amazon y en conjunto con los servicios profesionales de avanzo, puede prestar apoyo para definir muchas arquitecturas de recuperación de desastres conocidas en diferentes entornos y que estén listos para escalar en un momento dado a entornos activos que permiten una rápida conmutación por error. La distribución geográfica Gracias a los centros de datos con los que cuenta Amazon actualmente en el mundo tiene nueve regiones. Cada región se compone de múltiples centros de datos. AWS ofrece una serie de servicios basados en la nube que permiten una recuperación rápida de los datos y la infraestructura de TI. Escalabilidad y flexibilidad. Crecimiento en el momento de que el negocio lo necesite y únicamente durante el tiempo que lo necesite. Como les comentaba hace un momento con respecto al bajo costo, yo puedo ejecutar ambientes de prueba, puedo activar componentes parciales o totales y hacer una afinación de la infraestructura para recuperación de desastres bajo las necesidades propias del negocio. No requiero incurrir en grandes inversiones iniciales para poder empezar a hacer uso de estos beneficios. Finalmente y no menos importante, la seguridad. Amazon es una plataforma de tecnología segura y duradera que tiene certificaciones y auditorías totalmente reconocidas por el sector. La seguridad es una prioridad fundamental para las organizaciones y legítimamente lo es. Proteger los datos del cliente y garantizar la disponibilidad de la información es una de las prioridades más importantes para Amazon. Nadie lo entiende más que Amazon Web Services. AWS invierte constantemente en seguridad y privacidad de extremo a extremo con el fin de proteger a todos los clientes de acuerdo con las mejores prácticas y certificaciones de seguridad como FSMA Moderate SOC, anteriormente conocida como SA SOC PCI, que es toda la regulación que tiene que ver con temas de tarjetas de crédito, transaccionalidad financiera de este tipo, ISO 27001, en fin, menciona algunas para que sean consideradas, pero Amazon cuenta con otros muchos más reconocimientos en este ámbito y continúa obteniendo certificaciones de seguridad pertinentes y realizando las autoridades que correspondan con el fin de demostrar la seguridad de su infraestructura, de sus servicios. Antes de hablar acerca de las diferentes tecnologías o de los diferentes enfoques relacionados con la recuperación antidesastres que podemos considerar, vale la pena revisar las funciones y los servicios de Amazon Web Services más destacados para la recuperación ante desastres. A continuación vamos a mencionar algunos y que corresponderán a unas arquitecturas que tenemos de ejemplo que queremos mostrarles para que estemos un poco familiarizados con los términos de Amazon Web Services. El primero de ellos y uno de los más esenciales son los temas de regiones y zonas de disponibilidad. Amazon proporciona servicios a los clientes a escala mundial. Los servicios de Amazon se encuentran disponibles en varias regiones en el mundo, por lo que se puede elegir la ubicación más adecuada ya sea por temas de latencia o temas de disponibilidad de recursos. El sitio de recuperación en el cual yo quiero desplegar mi infraestructura o todo un sistema completo misional con un DRP. Las zonas de disponibilidad son ubicaciones geográficas independientes que están diseñadas para estar aisladas unas de las otras y de fallos que se puedan producir en cualquiera de las zonas de disponibilidad que hacen parte de una región. Adicionalmente, una ventaja de las zonas de disponibilidad es que proporcionan conectividad de red de baja latencia, son redes de alta velocidad que Amazon ha dispuesto para interconectar sus centros de datos dentro de una misma región, de tal forma que yo puedo crear arquitecturas altamente disponibles y que no van a tener una dependencia directa de temas de latencia. Actualmente, como les comentaba, Amazon opera nueve regiones en todo el mundo. Cada región tiene mínimo tres zonas de disponibilidad, lo que permite definir arquitecturas tolerantes a fallos y proporcionan redundancia de los datos. Adicionalmente a las regiones, Amazon mantiene otras 44 instalaciones que sirven como puntos de presencia estratégicamente distribuidos de forma global para temas de distribución de contenido y servicios de DNS como Route 53, que es el servicio DNS que ya vamos a ver. Entrando ya un poco en materia, en la especificidad de los servicios que podemos obtener y la flexibilidad que podemos obtener de ellos dentro de la plataforma. Infraestructura Como servicio de Amazon Web Services tenemos inicialmente los servicios de procesamiento. Iniciamos con Amazon EC, es una plataforma que proporciona capacidad informática de tamaño variable en la nube. Básicamente es lo que normalmente podemos denominar como máquinas virtuales o servidores virtuales virtuales en un ambiente de cloud. La ventaja es que en cuestión de minutos yo puedo crear instancias de EC, que son máquinas virtuales sobre las que puedo tener pleno control, puedo gestionar absolutamente los recursos que hacen parte de las máquinas virtuales y en el contexto de la recuperación antidesastres, pues es de vital importancia tener esta posibilidad de poder manipular rápidamente o poder crear máquinas virtuales de forma muy rápida que se puedan controlar y escalar de acuerdo con con las necesidades de mi plan de recuperación. De la mano de este concepto de Amazon EC están las amis que corresponden a las imágenes de las instancias de cómputo. La ventaja es que yo puedo preconfigurar imágenes para que estén listas para soportar mi ERP o puedo a su vez hacer uso de todo el marketplace con el que cuenta Amazon para poder traer sistemas operativos y algunas imágenes que ya tienen aplicaciones preconfiguradas para adaptarlas a mi entorno. En el contexto de la recuperación antidesastres, pues es muy recomendado tener ya preconfiguradas e identificadas las imágenes que se puedan iniciar de forma rápida como parte del procedimiento de recuperación. Estas imágenes deben estar ya listas con el sistema operativo requerido, además de los componentes necesarios para las capas de aplicaciones que correspondan a mi sistema crítico. Un concepto muy interesante es el tema instancias reservadas de Amazon EC, que suelen utilizarse para obtener un descuento importante en el costo de ejecución de una instancia de cómputo. Ofrecen además la ventaja de que resultan especialmente importantes para la recuperación ante desastres. Es decir, si yo ya conozco cuál va a ser el comportamiento de mi aplicación y dependiendo de la estrategia ERP que defina, puedo reservar instancias para garantizar que esa capacidad que reservé está lista y disponible para el momento que yo la requiere y con la ventaja de que además me va a costar mucho menos. Los temas de auto escalamiento hacen parte fundamental de todo el entorno de procesamiento de Amazon. Como su nombre lo indica, me permiten escalar automáticamente la capacidad de Amazon EC, ya sea para aumentarla o reducirla de acuerdo a unas condiciones o unos umbrales que yo defina. Puede asegurarse de que el número de instancias de Amazon EC que se esté utilizando en un momento dado aumente sin interrupciones durante los picos de demanda, ya sea por una activación de contingencia o a fin de mantener el rendimiento y que se reduzca de forma automática durante los periodos de calma en la demanda para minimizar los costos, es decir, si ya pasó la contingencia y retorné al estado de operación normal, voy a reducir el tamaño de las instancias y voy a tener una reducción también en costos ahí relacionada. Resulta especialmente adecuado este esquema para aquellas aplicaciones que muestren variaciones en el tiempo según la hora, día, semana o que sean impredecibles, como es el caso de una contingencia. En temas de almacenamiento tenemos el almacenamiento por bloques. Básicamente es el almacenamiento que se presenta a las instancias de EC para que puedan tener manejo de volúmenes. De estas instancias yo puedo de estos volúmenes yo puedo hacer snapshots como punto de partida para crear nuevos volúmenes y para proteger los datos que se deseen conservar a largo plazo. Después de crear un volumen, este se puede enlazar con otra instancia de cómputo independiente y estos volúmenes ofrecen un almacenamiento independiente de la vida de la instancia, es decir, puedo tenerla independientemente de que yo destruya la instancia o la elimine, puedo conservar los datos que están almacenados en estos volúmenes. Amazon s es una funcionalidad o un servicio muy especial de Amazon. Es un servicio que proporciona una infraestructura de almacenamiento altamente disponible y que está diseñado para datos que son vitales para el negocio. Los objetos, que son los elementos que almaceno dentro de los buckets o repositorios de almacenamiento de Amazon s, están guardados en varios dispositivos diferentes en instalaciones dentro de Amazon Web Services. Cada vez que yo escribo un dato, automáticamente tengo la tranquilidad de que está escribiéndose en dos almacenamientos adicionales que están aislados físicamente el uno del otro. Puedo aplicar políticas sobre los depósitos sobre estos almacenamientos, puedo manejar identidades, puedo establecer control de versiones, en fin, puedo hacer muchas cosas muy interesantes allí con Amazon s. Amazon Glacier es una derivación del producto de Amazon s y lo que me permite es ofrecer almacenamiento o contar con almacenamiento de costo extremadamente bajo para garantizar temas de durabilidad o realizar copias de seguridad y archivar datos para mantener este bajo costo. Amazon Glacier está optimizado para datos a los que se accede con poca frecuencia y para cuando son aceptables varias horas para su recuperación. Cloud Storage es un servicio que me permite a mí tener una perfecta migración de mis datos locales de forma bidireccional con almacenamiento de nube en Amazon para mis aplicaciones locales. Esto se logra almacenando datos de volúmenes de forma local en la infraestructura con la que contamos actualmente y en AWS de forma simultánea. Gracias a esto, las aplicaciones locales pueden llegar a almacenar datos en la infraestructura de Amazon de una forma muy rentable, segura y duradera sin perder el acceso a baja latencia de los mismos. Ya más adelante vamos a ver un poco la arquitectura de esa solución y cómo funciona. Finalmente, con respecto a los servicios de almacenamiento, tengo el servicio de Import Export que se encarga de acelerar la transferencia de grandes volúmenes de datos hacia Amazon Web Services utilizando dispositivos de almacenamiento portátiles. Yo puedo enviar estos dispositivos a Amazon de tal forma que pueda contar con redes de alta velocidad como son las redes internas de Amazon, sin necesidad de tener que subir esos volúmenes de datos por Internet. En el caso que se trate como les comentaba, de volúmenes de gran tamaño, AWS Import Export suele resultar mucho más rápido que transferirlos por un canal de Internet y es mucho más rentable que tener que actualizar, por ejemplo, el enlace para subir su ancho de banda. A nivel de redes, Amazon cuenta con el servicio de Route 53, que es un servicio de DNS totalmente escalable y altamente disponible. Está diseñado para ofrecer a los desarrolladores y a las empresas una forma sumamente fiable y rentable permitir a los usuarios finales acceder a los recursos y aplicaciones en Internet. Tenemos también el balanceador de carga elástico de Amazon que principalmente lo que se encarga es distribuir de forma automática el tráfico entrante hacia las aplicaciones entre varias instancias de Amazon EC. De igual forma permite conseguir aún más tolerancia a fallos en las aplicaciones porque nos proporciona la capacidad de equilibrio de carga que se necesita como respuesta al tráfico entrante de las aplicaciones. Aquí es donde justamente para temas de ERP sirve mucho porque en el momento que yo requiera activar mi contingencia puedo empezar a provisionar muchas instancias de cómputo y automáticamente voy a tener un balanceador que me va a soportar esa carga y va a distribuirla de forma uniforme entre los recursos de cómputo que yo haya aprovisionado. Está el tema de Amazon Virtual Private Cloud. Nos permite contar con una sección privada y totalmente aislada de la nube de Amazon donde puedo lanzar recursos de AWS en una red virtual que yo puedo definir. Es posible que se controlen todos los aspectos de entorno de red virtual, incluida la selección de mi grupo de direcciones IP propio. Yo puedo determinar qué rango de direcciones IP requiero, puedo crear subredes, puedo configurar tablas de enrutamiento, puedo establecer puertas de enlace red, permitiendo también crear una conexión VPN entre mi centro de datos corporativo y Amazon Web Services para poder utilizar la nube de Amazon como una extensión de mi centro de datos corporativo. En el contexto de ERP se puede utilizar Amazon VPC para ampliar la topología existente en mi red local con la de la nube y esto puede resultar especialmente útil si queremos recuperar aplicaciones empresariales típicas de la red interna. Amazon Direct Connect es un servicio que facilita el establecimiento de una conexión de red dedicada desde las instalaciones de Amazon hacia la red, hacia mi red corporativa. En muchos casos esto puede reducir los costos de la red aumentando el rendimiento del ancho de banda y ofreciendo una experiencia de red mucho más coherente a las necesidades que tenga mi aplicación. Las direcciones IP elásticas son direcciones IP públicas que están diseñadas para la informática dinámica de Amazon Web Services. Yo puedo distribuir estas direcciones IP elásticas entre mis instancias de cómputo y en algún momento si tengo alguna falla, algún tema que tenga que activar en mi contingencia, puedo utilizar estas instancias de la forma que yo requiera, distribuyéndolas uniformemente de acuerdo con los recursos que haya provisionado. A nivel de Amazon. En bases de datos tenemos RDS que es un servicio de base de datos totalmente relacional, es muy fácil de configurar, gestionar y escalar. Para bases de datos tipo Oracle MySQL Server se puede utilizar en la fase de alistamiento de un doctor para que se cuenten con los repositorios de datos listos y que estén disponibles para ejecutar una protección de datos de acuerdo a las necesidades del negocio. Amazon DynamoDB es un repositorio de datos, un almacén de datos que no es relacional, es altamente disponible y tiene un gran acceso a disco. Me permite un gran acceso a disco porque la tecnología que se usa es discos de estado sólido y y me permite descargar todo el trabajo de gestión de administración de base de datos. También lo puedo utilizar en la fase de alistamiento y recuperación de desastres de un proceso de ERP. Finalmente también puedo aprovisionar servidores de base de datos, aplicaciones de base de datos en instancias de EC como las que vimos hace un momento. Yo puedo ya ahí desplegar la base de datos que requiera de acuerdo con lo que necesite mi aplicación. Ya entrando un poco más en materia, les queremos mostrar las estrategias de ERP que nos ofrece Amazon y que hemos implementado en Avanzo en diversos clientes que se acomodan a muchas necesidades de acuerdo ya sea el presupuesto y como les comentaba inicialmente, al RPO o al RTO que tenga cada una de las aplicaciones. Vamos a describir estos cuatro escenarios que vemos allí en la pantalla. Son escenarios de recuperación antidesastres en los que se destaca el uso de Amazon Web Services y se compara AWS con entornos tradicionales de recuperación antidesastres. El primero de ellos es Backup y Restore. Básicamente es un tema de copia y restauración de datos. Aquí tenemos una topología de ejemplo. En los entornos más tradicionales las copias de seguridad de los datos los almacenamos en una cinta y se envían fuera del sitio físico con cierta regularidad. El tiempo de recuperación va a ser el más largo con con la utilización de este método. Acá es donde justamente podemos hacer uso de Amazon s para las copias de seguridad de los datos, ya que se trata de una solución diseñada para ofrecer una durabilidad de los objetos de once nueves durante un año determinado. Es decir, la durabilidad de los datos ahí es enorme, Yo puedo colocar cualquier dato y lo voy a poder conservar en el tiempo sin ningún inconveniente. La transferencia de los datos entrantes y salientes de Amazon s se realiza normalmente a través de la red y por lo tanto estos datos pueden estar accedidos desde cualquier ubicación, obviamente con las políticas de seguridad que puedo establecer para estos repositorios de datos. Como les comentaba hace un momento, el servicio de Import Export también me permite manejar allí temas de copias de respaldo para eventos, para conjuntos de datos muy grandes y enviando los dispositivos directamente a Amazon Web Services. También tenemos allí temas de Direct Connect, que es una funcionalidad que me permite establecer conexiones de alta velocidad de 1 giga o de ten gb hacia Amazon desde mi red corporativa. Este es el servicio de Cloud Storage que les mencionaba hace un momento. Este servicio es muy interesante, nos permite copiar de forma transparente snapshots de volúmenes de los datos locales que tengamos en nuestra red hacia Amazon s para poder realizar copias de seguridad. A partir de estos snapshots se pueden crear volúmenes locales o volúmenes de Amazon EBS que son los que presentamos instancias de cómputo de Amazon Web Services. Esta solución nos permite tener los datos de forma local mientras de forma Asi son EBS que son los que presentamos instancias de cómputo de Amazon Web Services. Esta solución nos permite tener los datos de forma local mientras de forma asincrónica se realiza un respaldo de los mismos en Amazon Web Services. Estos volúmenes nos proporcionan las aplicaciones locales acceso de baja latencia para los datos, de tal forma que puedo también facilitar todo el tema de gestión de copias de respaldo en Amazon. Ahí la tecnología lo que hace es crear una especie de caché local para que los datos que están normalmente siendo más accedidos estén disponibles de forma local y los que ya hacen parte de históricos o temas de copias de respaldo se van a empezar a enviar de forma paulatina hacia Amazon Web Services. Como pueden ver acá, este modelo resulta totalmente ideal para temas de temas de recuperación antidesastres, temas de creación de datos de espejo en la nube o temas de copias de seguridad externas. Que yo quiero librarme de las cintas, lo puedo hacer a través de esta solución. Ya una vez los datos están en Amazon, yo puedo desplegar instancias de cómputo para poder empezar a hacer uso de estos datos, ya sea para ambientes de pruebas, por ejemplo, o si quiero replicar mi ambiente de producción para temas de desarrollo, lo puedo hacer dentro de este mismo ambiente o esquema de recuperación de desastres a través de backup y restore. Básicamente, lo que les mostraba en las dos diapositivas anteriores hace parte de un 50% del proceso. La recuperación de los datos en un escenario desastre debe probarse y conseguirse de forma rápida y fiable, porque yo puedo tener los datos almacenados, pero si no tengo políticas o metodologías para probar regularmente que esos datos que estoy respaldando son consistentes y funcionan en mi infraestructura, pues no tendría mucho sentido hacer esto. Para cualquiera de estos escenarios que les comentaba, es importante considerar cuatro pasos clave para establecer las copias de seguridad y restauración. Uno de ellos es seleccionar la herramienta o el método adecuado para poder realizar estas copias de seguridad de los datos en Amazon. El segundo es asegurarse de que se dispone de una política adecuada de retención para estos datos de acuerdo a las necesidades de la aplicación o mi negocio. Puntualmente, asegurarse de que se dispone con las medidas de seguridad adecuadas para estos datos, incluidas las políticas de acceso y temas de cifrado, por ejemplo, probar regularmente la recuperación de estos datos y la restauración del sistema. El segundo escenario que queremos presentar desde el día de hoy es el de luz piloto. La idea de luz piloto es una estrategia o una analogía que surge del calentador de gas. En un calentador de gas, una llama inactiva pequeña que está siempre encendida puede encender rápidamente una caldera para calentar el agua de una casa, por ejemplo. Es acá donde justamente los temas de copia de seguridad o replicación de datos se vuelven muy importantes y muy tangibles para poder hacer de un DRP una realidad en Amazon Web Services. Aquí normalmente lo que vemos en el diagrama es que yo regularmente estoy haciendo una replicación de mi repositorio de base de datos de forma continua en instancias pequeñas y las otras capas adicionales, como pueden ser las capas de presentación, las capas de aplicación o las capas que procesan esos datos se encuentran apagados, pero están listos y ya preconfigurados para activarse. De tal forma que si hay una contingencia, yo puedo empezar a crecer las instancias de base de datos o o encender las instancias de cómputo que se encuentran apagadas y también crecerlas de acuerdo con las necesidades de mi plan de activación de contingencia. Allí también habría algunas tareas de DNS, según corresponda, que pueden ser manuales o pueden ser automatizadas para redireccionar el tráfico de una forma muy rápida, eficiente hacia Amazon Web Services. La tercera estrategia de ERP que les queremos presentar es la de warmsight. Es una evolución de la arquitectura que veíamos hace un momento de luz piloto, con la diferencia de que no tengo instancias apagadas en Amazon, sino que el lado de Amazon siempre tengo las instancias encendidas y listas para atender los requerimientos, lo que hace que la reducción de los tiempos, en el caso de que se activen la contingencia, sean mínimos. Ahí, como pueden ver, se mantendría siempre un repositorio de datos. En este caso, en este momento, cuando los dos ambientes están disponibles, tanto el principal como la contingencia, todos los datos van a ser accedidos a la base de datos que tengo de forma local y cuando haya una contingencia, básicamente a través de DNS se desactiva el tráfico hacia mi instancia principal y empiezo a redireccionar todo el tráfico hacia Amazon Web Services y puedo empezar a utilizar temas de balanceo de cargas para aprovisionar instancias de cómputo que estén detrás del balanceador y así poder responder a las necesidades de tráfico y de requerimientos puntuales que tenga mi aplicación. Finalmente, está un esquema mucho más disponible, altamente disponible, que es el de multisitio Hot Site, en el cual yo puedo tener dos infraestructuras altamente disponibles, las dos activas. Como veíamos en el ejercicio anterior, yo únicamente tenía el tráfico activo hacia mi instancia principal y hacia la estancia o a la infraestructura que tenía en Amazon Web Servicio.
More from Paulina
Todo sobre la Nueva Región de AWS en México | Beneficios, Infraestructura y Migración
DEMO: De VMware a AWS. Administración de ambientes dentro de la consola de AWS.