Webinar: Aprenda a construir bases de datos relacionales en la nube de manera fácil y rápida.
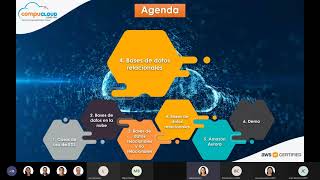
Jorge Monzión, Zadia Olivares, and Ismael Armas walk through building relational databases in the cloud using Amazon RDS and Aurora. The webinar covers database types, migration tools, and includes a live demo of setting up RDS on AWS.
A continuación les presento al equipo que va a estar interactuando con nosotros en el webinar. Va a estar con nosotros la ingeniera Sadia Olivares, quien forma parte del equipo de Customer Success, el ingeniero Ismael Armas, quien es el team líder de esta área y un servidor, Jorge Monzión, soy consultor comercial de la zona occidente y Bajío. Vamos a revisar a continuación la agenda para ver cuáles son los temas que vamos a tratar en este webinar. Vamos a revisar a continuación unos casos de uso y de éxito. Después vamos a revisar lo que son las bases de datos en la nube. Posteriormente hablaremos de las bases de datos relacionales y no relacionales para conocer un poquito cuáles son las diferencias entre ellas. Vamos a ver las bases de datos relacionales más a detalle. Posteriormente hablaremos de lo que son las bases de datos en Aurora y al final tendremos una demo para que conozcamos cómo crear una base de datos relacional en la nube. A continuación les comparto que CompuCloud es el líder, el partner número uno en lo que es México y Centroamérica. Nosotros somos un partner con la categoría Advanced. Esta categoría o este nivel de partner es el más alto que hay en los niveles de AWS como partners. Para nosotros poder ser un partner Advanced necesitamos todas las certificaciones y reconocimientos por parte de AWS que son mandatorios. Todo nuestro equipo cuenta con estas certificaciones, por lo que nosotros podemos apoyar a las organizaciones en su transición desde un inicio hacia la nube y posteriormente también apoyarlos con temas de modernización, con temas de well architected y de igual forma podemos apoyarlos en temas de migración también de bases de datos. Entonces, a continuación vamos a revisar de manera rápida para poder tener tiempo para realizar la demo, algunos casos de éxito. En la siguiente lámina vamos a poder ver algunas de las compañías que actualmente están trabajando con las bases de datos administradas por Amazon AWS. Estas compañías están trabajando con estas bases de datos por algunos de los beneficios que más adelante vamos a revisar. Uno de ellos es la fácil administración de las bases de datos. Nosotros prácticamente les ahorramos lo que es a los ingenieros de TI esta parte de la administración, temas de parches, etc. También simplificamos todas sus tareas, apoyamos en temas de costos. Entonces, la verdad es que los beneficios son muchísimos y más adelante se van a dar cuenta cuando entremos a la parte técnica de todos estos beneficios a detalle. Vamos a revisar a continuación un ejemplo de una empresa a nivel global, anteriormente ellos tenían lo que son bases de datos autogestionadas, ellos manejaban lo que es MySQL, ellos son una empresa que se dedica 100% a conectar propietarios de inmuebles con vacacionistas, ellos aumentaron considerablemente sus transacciones, han crecido muchísimo actualmente pues ya cotizan en la bolsa de valores, se han estado subiendo muchísimo su valor, ellos tenían el miedo de caer, de que durante su migración estuvieran mucho tiempo fuera, porque al final de cuentas el tiempo en las organizaciones es dinero y sobre todo el tiempo caído y el tiempo también de los arquitectos o de los ingenieros trabajando en temas de remediaciones, entonces con ellos aplicamos por ahí y me gustaría que lo tengan en mente que vamos a revisar esta herramienta un poquito más adelante, la herramienta de DMS, la cual les apoyó ellos para que su migración fuera en solamente 15 minutos de lo que es, ellos migraron de lo que es como les comenté de MySQL autogestionada a una base de datos administrada por AWS también con mysql, entonces para que vean esta parte es muy importante. También les pido por favor que tengan muy en mente el servicio de Multi Multi AZ del cual vamos a hablar más adelante, este servicio permite que Airbnb tenga un tema de alta disponibilidad, ellos están 100 % operacionales en la nube y no tienen temas de caída, entonces vamos a revisar un ejemplo similar, sin embargo esta empresa a continuación les comento Trimble, ellos son una empresa que se dedica a soluciones de telemática, ellos de hecho es imposible que estén fuera o que estén caídos porque prácticamente sus soluciones son por ejemplo GPS para aviones, entonces imagínense si están caídos o llega a fallar un poquito sus instrumentos pues es prácticamente una pérdida muy grande para ellos. Ellos de igual manera utilizaron el servicio de DMS, pero esto lo hicieron ellos porque antes tenían lo que son las bases de datos con Oracle, administradas con Oracle, ellos utilizaban lo que es la base de datos SQL Postgres y migraron de igual forma también a Postgres, sin embargo ahora a lo que es las bases de datos administradas por AWS, Entonces les comento que ahora Trimble disminuyó sus costos y ahora también tiene mejor performance en tiempos de transacciones y ellos están muy contentos actualmente con el servicio de RDS. A continuación mi compañera Zadia nos va a hablar un poquito sobre lo que son las bases de datos en la nube. Adelante Zadia.
Así es, muchísimas gracias. Muy buen día a todos, les agradecemos por continuar con nosotros estar aquí en este webinar que esperamos sea de gran ayuda informativa para ustedes. A continuación, antes de entrar más a profundidad con nuestro servicio enfoque en este webinar que es Amazon RDS, les queremos dar una pequeña introducción de lo que son las bases de datos. Como algunos podemos conocer, tenemos diferentes tipos de bases de datos, en esta ocasión vamos a mencionar las relacionales y las no relacionales. Las bases de datos relacionales son un tipo de base de datos que almacena y nos permite proporcionar acceso a puntos de datos que están relacionados entre sí. Este tipo de base de datos se maneja bajo un modelo de entidad relación o modelo relacional, el cual es una forma sencilla e intuitiva de representar datos en tablas, como podemos ver aquí en la imagen, esto es básicamente un tipo de base de datos relacional, ellos están fundamentados en tablas, estas tablas tienen diferentes elementos que los ayudan a poder relacionarse, a poder conectarse entre ellas. A estas tablas, como su nombre técnico es, les llamamos entidades y la relación que hay entre ellas es gracias a las llaves o claves que cada una de ellas tienen. Tenemos diferentes tipos de claves o llaves, las más principales o importantes son las primarias y las foráneas y gracias a ellas es como se logra tener la conexión entre las diferentes entidades o tablas. Las tablas, otros de los elementos que utilizan son las filas y las columnas, que son básicamente los atributos y los registros que cada una de nuestras entidades van a tener. Por otro lado tenemos las bases de datos no relacionales. Estas bases de datos están diseñadas para modelos de datos específicos y la verdad son reconocidas por su facilidad en cuanto al desarrollo, la funcionalidad y el rendimiento a escala. Las bases de datos no relacionales cuentan con diferentes tipos como lo son de clave, valor, de documentos, gráficos, como lo podemos ver aquí en estas imágenes, las cuales son optimizadas para el rendimiento, para la memoria y la escalabilidad que pueden tener. También pueden soportar lenguajes de consulta de tipo SQL. Este tipo de bases de datos son también llamados NoSQL, pero eso no significa que no puedan soportar ese tipo de consultas, también están diseñadas para eso. Bien, una vez dicho esto, a continuación les vamos a presentar las diferencias que tenemos entre las bases de datos relacionales y no relacionales y cuándo más o menos podemos utilizar cada una de ellas. En la siguiente lámina podemos observar una tabla en la cual nos da las características principales o primordiales de estos tipos de bases de datos, las relacionales están basadas en tablas mientras que las no relacionales en documentos, en las tablas como ya les mencioné anteriormente nos permite realizar esta conexión entre las diferentes entidades las cuales van a tener nuestros datos, sin embargo las no relacionales son simplemente documentos los cuales van a tener todos nuestros registros y estos tipos de bases de datos nos permiten tener redundancia de nuestros datos y es por esto que las consultas a estos tipos de bases de datos son mucho más rápidas y eficientes. En cuanto a las relacionales mantiene una estructura definida previamente al diseño, antes de que nosotros tengamos una base de datos necesitamos diseñarla bajo un diagrama en el cual tengamos visualmente qué entidad va a estar conectada con qué otra entidad y gracias a que llaves, las principales, las entidades van a tener sus claves primarias las cuales van a estar conectadas con otras tablas gracias a las llaves foráneas. En cuanto a los no relacionales su estructura puede ser dinámica, esta es para bases orientadas a documentos, las relacionales están diseñadas para tener la menor redundancia posible de nuestros datos, esto nos ayuda a no obtener información repetida. En cuanto a nuestras entidades, como ya lo comentaba anteriormente, las no relacionales nos permite tener esta redundancia y es este el beneficio que nos da tener un mayor rendimiento en nuestras bases de datos. Grandes empresas como lo es Amazon necesitaba este tipo de consultas y este tipo de respuestas que fueran ágiles, rápidas, de alto rendimiento, entonces Amazon decide realizar su propio tipo de base de datos, perdón, su propia base de datos la cual la llama DynamoDB, esta base de datos la pone a nuestra disposición a través de su servicio de Amazon Web Services, nosotros podemos tener también una base de datos con este motor, con este gestor, entonces otras grandes empresas también han utilizado este tipo de bases de datos ya que para la interacción o para la manipulación de grandes datos como los que manejan estas empresas Amazon o Facebook otro ejemplo, necesitan esta agilidad y es por eso que ellas necesitan o utilizan más bien este tipo de bases de datos. En la siguiente lámina podemos vamos a hablar, nos vamos a adentrar un poquito más ya a las bases de datos relacionales, ya que hemos dicho como las diferencias de cada una de ellas. Bueno, en esta ocasión nos vamos a adentrar un poquito más a las relacionales. Y bueno, aquí les vamos a dar como los motivos por los cuales decimos que la autogestión de las bases de datos relacionales pues es un poco más complicada si la tenemos por nuestra propia cuenta, si la autogestionamos, esto puede ser sinónimo de un uso de nuestro tiempo mayor, es más compleja y más costosa. ¿Por qué? Porque necesitamos preocuparnos de la instalación, del parcheo de nuestros motores, de las copias de seguridad y también del hardware. Si nosotros necesitamos mayor recursos para para poder gestionar nuestro motor, entonces tenemos que esto nos implica una gran logística para poder comprarlo, instalarlo y demás, entonces también podemos ocasionar o podemos tener y presentar problemas del rendimiento y de la alta disponibilidad. Por lo que igual les comento, si nosotros necesitamos más recursos en ese momento no lo podemos tener tan simple y sencillo como hacer unos clics, sino que es toda una logística. Al igual con la seguridad, es más vulnerable el tener nuestra propia base de datos por nuestra cuenta. Es por esto que Amazon también nos pone a disposición un servicio llamado Amazon RDS, que a continuación les vamos a dar el significado. Amazon RDS es un servicio administrado que nos facilita las tareas de configuración, operación y escalación de base de datos relacionales en la nube. Así como Amazon tiene una base de datos de tipo no relacional, pone a nuestra disposición este servicio que nos dan nuestros motores que ya conocemos, los motores con los que estamos trabajando día a día o comúnmente y nuestros aplicativos ya cuentan, tenemos este servicio que es Amazon RDS Relational Database Service, el cual tiene a disposición todos estos motores, estos gestores que más adelante les vamos a decir cuáles son los que tenemos a nuestra disposición. Es importante recalcar que Amazon RDS es un servicio administrado, es decir, nosotros con este servicio nos vamos a olvidar de estas instalaciones, del parcheo, del aprovisionamiento del hardware para nuestro gestor, no es una base de datos en sí, es el servicio que nos ayuda a administrar nuestra base de datos. Bien, a continuación les vamos a dar un pequeño recuento de los beneficios más sobresalientes de este servicio. Administración sencilla ¿Esto a qué nos referimos? Bueno, como les comentaba antes, que si tenemos una base de datos de autogestión no podemos aprovisionar recursos con unos solos clics, pues Amazon RDS nos da esa facilidad y eso es lo extraordinario de este servicio, que tan solo si nosotros vemos que en las métricas estamos viendo un alto rendimiento, perdón, un alto uso de nuestros recursos y creemos que necesitamos más de ellos, tan solo dar unos clics, indicarles cuántos, cuánto queremos más de CPU, de RAM, de almacenamiento, incluso nosotros podemos tener esos recursos a nuestra disposición en cuestión de minutos. También nos pone a nuestra disposición la aplicación automática del parche del software y nos da sugerencias sobre prácticas recomendadas mediante el análisis de las métricas de configuración. De estas métricas mi compañero Ismael va a hablar más adelante que la verdad es una maravilla poder tener métricas a nuestra disposición de una manera tan sencilla como Amazon RDS nos los da. Otro punto importante de los beneficios de RDS es la escalabilidad, como les comentaba podemos aprovisionar recursos de una manera sencilla, RDS pone a nuestra disposición la implementación de poder ampliar o reducir nuestros recursos, tenemos hasta un máximo de 32 CPU y 244 GB de RAM, al igual que en el almacenamiento nosotros tenemos como mínimo poder utilizar 5 gigas y tenemos hasta 6 terabytes para poder utilizarlos. También tenemos diferentes tipos de clases de familias que están a nuestra disposición, los cuales tienen como diferentes categorías los cuales son estándar, con la memoria optimizada o con micro instancias. Otro de los beneficios es la disponibilidad y durabilidad, lo que también nos lleva al siguiente beneficio que son los respaldos de seguridad. Con la disponibilidad podemos tener copias de seguridad automatizadas, estas copias también las podemos generar de manera manual mediante los snapshots de nuestras RDS, el cual se realiza manualmente una copia de seguridad de la base de datos y estas las podemos tener con frecuencia como nosotros lo deseemos o lo requeriramos. En cuanto a las copias de seguridad de manera automática nosotros podemos establecer el tiempo en el que se va a realizar cada copia de seguridad, con qué frecuencia y qué tiempo de retención van a tener éstas. Otro beneficio que nos da RDS es la seguridad, nos permite cifrar nuestras bases de datos mediante la administración a través del KMS, estas copias de seguridad también van a estar cifradas, si nosotros tenemos réplicas de lectura de nuestra base de datos, estas también van a estar cifradas, al igual que las copias de seguridad que extraigamos de manera automatizada o los snapshots, también van a estar seguras las réplicas de seguridad. Las réplicas de lectura son copias de nuestra base de datos, las cuales mantienen toda la información que nosotros tengamos en nuestra base de datos original. ¿Y esto para qué nos ayuda? Las réplicas de lectura nos ayudan para poder disminuir el tráfico de nuestra base de datos para las consultas en una sola, así podemos tener como, digámoslo así, varias copias chiquitas de nuestra base de datos, que si un usuario necesita una consulta el cual se debe de extraer de esta base de datos, no todo este tráfico caiga sobre una sola, sino que se va a distribuir y eso nos va a ayudar en el rendimiento de nuestra base de datos y también en las respuestas de nuestras consultas, esto optimizando y dando mejor performance a nuestro servicio. La seguridad también la podemos obtener con el aislamiento de la red, esto gracias al servicio de VPC y también la seguridad la podemos tener con el servicio de IAM, el cual nos va a permitir negar o acceder permisos a nivel de recursos, es decir, si nuestro colaborador de desarrollo solo debe de tener acceso a nuestra base de datos de desarrollo, con el servicio de IAM nosotros les podemos asignar sabes qué empleado A, solo tú puedes tener acceso a la base de datos de desarrollo, pero el empleado B solo va a tener acceso a la base de datos de productivo y pues bueno no van a tener interacción con otras bases de datos más que las que se les sea asignadas. Bien, a continuación les podemos dar en resumidas cuentas este gráfico, gracias a RDS ustedes solamente se van a tener que preocupar por el diseño de los esquemas, la construcción de las consultas y la optimización de las mismas y de todo lo demás se lo dejamos a AWS, esa es la nobleza de este servicio, que nosotros no tenemos que estarnos preocupando por otras cosas más que en sí por nuestra base de datos, que de todo lo demás se encarga AWS. A continuación mi compañero Ismael les va a hablar un poco más sobre RDS de Amazon Aurora y aquí sobre cómo podemos migrarlas para tener este servicio, muchas gracias.
Qué tal, buenos días a todos, muchas gracias aadia, es correcto, como les comentaba mi compañera Zadia, para migrar los que son base de datos ya sea mysql, Postgres, mariadb, son unos cuantos lenguajes como también Amazon Aurora, para esto utilizamos lo que es el servicio DMS, Database Migration Service, en el cual nosotros podemos llegar a migrar lo que es en cuestión de minutos, ya sea si ustedes llegasen a tener su base de datos en on premise o llegasen a tener la base de datos ya en la nube en alguna instancia EC, podemos llegar nosotros a migrarlas. Este servicio es muy práctico, simplemente necesita en este caso el objetivo desde donde pretendemos migrar y obviamente este proceso es rápido. Una vez migrado esta base de datos crearía una RDS en los servicios de Amazon Web Services y obviamente ustedes ya estarían accediendo a este RDS que se creó y obviamente administrando ya sea en la nueva plataforma su base de datos. En caso que tuvieran un esquema diferente, Amazon RDS nos permite poder hacer una conversión, en este caso si ustedes tuvieran una base de datos Postgres y quisieran migrarla tal vez a una Aurora Postgres o quisieran migrarla del lenguaje, existen herramientas database tools por ejemplo, para que en el momento de la migración ustedes pudieran hacer la conversión del lenguaje, obviamente solamente en las tablas que sean definidas las temporales no entrarían en este tipo de conversión y obviamente al hacer la conversión les sugeriría qué tablas pueden ser la conversión sin ningún problema y y qué tabla necesitarían algún ajuste, debido a que migrar de un lenguaje a otro es algo específico y si se necesitan algunas intervenciones por así decirlo, pero en caso de que quieran migrar de un mysql a una Amazon Aurora mysql sin ningún problema DMC los apoyaría en lo que es esta migración. Pues como mencioné algunos motores son MariaDB, MySQL, también contamos con motores para la RDC de PostgreSQL y SQL Server y también inclusive pues se tiene compatibilidad con Oracle Database. A continuación el siguiente punto de la agenda es algo muy importante llamado Amazon Aurora. Bueno Amazon Aurora surge, es un motor propio de base de datos de de AWS, surge en octubre del 2014, este motor es diseñado en este caso los usuarios de MySQL y PostgreSQL, esto debido a que Amazon se preocupaba por performance que tenían estos usuarios para hacer request o cargas de trabajo extremadamente pesadas, entonces ellos diseñan lo que es el motor de base de datos Amazon Aurora, el cual tiene 5 veces más rendimientos en cuestiones de compatibilidad con MySQL y 3 veces más de rendimiento en PostgreSQL. Amazon Aurora es un motor de base de datos relacional como lo explicó mi compañera Zadia y una característica muy notable de Amazon Aurora es que lo maneja por default en clusters. Cluster quiere decir que dentro del clúster vas a tener siempre dos bases de datos, dos bases de datos, el cual uno va a ser específicamente para lectura y otro va a ser específicamente para escritura, esto pues haciendo un desfogue de presión en las bases de datos a través de los request y obviamente pues teniendo una eficiencia opcional. Amazon Aurora también cuenta con multi AZ como lo mencionó mi compañera, en el cual nos provee una disponibilidad totalmente alta debido al día de mañana, ya que Amazon Aurora cuenta con red réplica también el día de mañana que ustedes tuvieran tal vez la de solo escritura llegase a corromperse. La segunda redes que se mantiene siempre en standby pasa a ser la primaria y entonces Amazon Aurora tarda milisegundos en hacer el switcheo de este cambio, obviamente al hacer este switcheo ustedes no van a estar fuera de línea en ningún momento debido a su alta disponibilidad y en base a que la secundaria convirtió en la primaria, esta crearía la copia de la nueva primaria, la nueva base primaria y la volvería una secundaria, un standby. Obviamente esta segunda base de datos siempre estaría actualizada debido a que toda actualización que se haga sobre la primaria al instante se configura en la secundaria, aunque ésta se encuentre por así decirlo dormida. Una de las ventajas de Amazon Aurora es que puede en este caso puedes llegar a tener un clúster o en este caso puedes meter muchas más instancias dentro de este mismo cluster, tal vez puedas tener tres proyectos, los puedes administrar en un mismo clúster y como también tiene auto provisionamiento, ¿Que quiere decir con auto provisionamiento? Amazon ahora puede autoprovisionarse según la demanda del aplicativo que ustedes tengan en la nube. A continuación también vamos a ver una de las características donde voy a explicar más a fondo qué se trata este auto provisionamiento. Las principales características de Amazon Aurora son las que ven a continuación, en las cuales es disponible y duradera, como lo comentaba mi compañera Zadia, debido a su alta disponibilidad no tiende a dejar nada fuera de línea, siempre está todo arriba milisegundos en hacer el failover, que así se llama cuando cambia de una instancia a otra y pues obviamente nos da la seguridad que antes de realizar un failover, la mayor seguridad que nos da es que saca un snapshot de esta base de datos, así no nos tenemos que preocupar de que OK, pero antes de hacer la continuación quiero tener un respaldo, lo saca en automático y hace el failover, obviamente después, inclusive después de que hace el failover vuelve a sacar otro snapshot, entonces saca dos snapshots en automático por procesos del propio Amazon Aurora y en el momento que hace el failover, pues otra vez vuelves a tener tu base de datos primaria arriba. Esto con alta disponibilidad y alta escalabilidad y rendimiento En comparación de las Amazon RS normal como son las MySQL, SQL Server, Oracle Database, Amazon Aurora cuenta como comentaba mi compañera, 5 GB como mínimo, pero el máximo de Amazon aurora no son 6 teras, sino el máximo de Amazon aurora son 64 terabytes de almacenamiento, en el cual ustedes pueden tener inclusive cargas demasiado pesadas, Amazon Aurora las va a cubrir sin ningún problema. ¿Y alta escalabilidad a qué se refiere? Bueno, alta escalabilidad se refiere a que si ustedes deployen algún aplicativo que pese un ejemplo 7 GB y de repente por cuestiones internas o cuestiones del aplicativo, este llegase a crecer un poco la base de datos temporalmente ustedes no tienen que preocuparse por tal vez agregar más GB a lo que es el storage como se hace en las Amazon RDS, sino ustedes no se preocupan por eso debido a que Amazon Aurora lo va a autoprovisionar solo, entonces va a tener una respuesta rápida, va a provisionar estos 100 gigas que tal vez creció de repente y obviamente también va a provisionar ya sea si necesita memoria, si necesita RAM, debido a que los queries deben ser óptimos. Una ventaja también aprovisiones 100 gigas, cuando dejes de utilizar tal vez de esos 100 gigas que aprovisionaste 50 gigas, Amazon Aurora se va a ajustar nuevamente a que OK, dejaste de ocupar 100 gigas y ahora estás ocupando solamente 50, OK, vamos a bajar el auto provisionamiento o te vamos a quitar lo que ya no necesitas. Entonces Amazon Aurora se preocupa más por el uso, entonces siempre vas a pagar al final del día lo que uses. Si tuviste un crecimiento a mitad del día a 100 gigas, pero al final del día solamente ocupaste, en realidad se quedó con 20 gigas, de esos 100 gigas solamente te va a cobrar los 20 gigas que se aprovisionaron de no te va a cobrar esa escalabilidad que se usó tal vez en una o dos, tres horas, simplemente te va a cobrar por el uso real que tengas. Otra de las ventajas pues es compatible con dos lenguajes de base de datos, en este caso los más comunes que se utilizan MySQL y PostgreSQL y como quinta ventaja pues nos da las cuestiones de, obviamente es una gestión completa, simplemente tú la configuras, la echas a andar y ya no te preocupas por el storage, ya no te preocupas en este caso por la memoria en caso de que tú veas también es buena práctica del lado de nosotros, si nosotros vemos que vas a tener desde un inicio un performance alto, te recomendamos una familia de performance alto para iniciar obviamente si a través de ese performance vas creciendo, pero son crecimientos que se van a ir dando tal vez dos que tres días pues el auto provisionamiento te va a apoyar en eso. La base siempre va a ser en base a tu carga de trabajo, si tienes un performance alto, un performance bajo, vamos a determinar el tipo de familia que vamos a darte como base inicial y a través de esa base pues Amazon Aurora va a ser el crecimiento o el decrecimiento conforme vaya en la demanda. Todo esto a través de su gestionamiento completo y pues su autoadministración, ya sea su autoaprovisionamiento en storage. A continuación vamos a realizar una demo de cómo ustedes pueden hacer andar una Amazon RDS, aquí les comparto mi pantalla, actualmente yo tengo una Amazon RDS arriba pero vamos a crear una desde cero nosotros cuando entremos a nuestra consola de Amazon Web Service vamos a poder escribir sin ningún problema RDS Pues la primera opción que nos sale en este Amazon RDS vamos a obtener pues lo que es un dashboard, un dashboard en este caso en el cual nos dice cuántas RS tenemos, los clústeres, reservas, si tenemos algún snapshot y las opciones de grupo, vamos a darle en debug y aquí en la parte superior arriba pues le damos crear. Al crearla nos va a pedir ciertas cuestiones como pues si vamos a crearla de forma estándar que es donde vas tú poniendo la configuración de esta RS que tú vas a deployar, perdón ahí disculpe, Amazon RS que vas a lanzar y los motores que son compatibles como tal. Aquí lo que vamos a hacer es lanzar obviamente una Amazon Aurora, en este caso vamos a lanzarla con motor compatible a PostgreSQL y la capacidad vamos a hacerla, obviamente que se autoprovision, existen dos tipos, autoprovisionar y serverless, donde en el serverless tú aplicas un mínimo y un máximo, esto quiere decir que tú necesites un mínimo ya sea en memoria, tú pones que la base de datos empiece desde 5 gigas de memoria o desde 30 GB de storage más bien y que tenga un límite solamente de 120 gigas de storage, entonces tú pones un límite y un máximo para que no salga de ese auto provisionamiento. Debido a que existen algunos aplicativos o normalmente cuando se instalan en Windows las SQL pues se comen toda la memoria porque no se le pone este límite como tal, pero pues en RS no pasa así debido a que RDS es totalmente administrado, no está instalado dentro o no administras el sistema operativo como tal, sino simplemente gestionas la base de datos, los esquemas que viven dentro de ella. Después seleccionamos el motor, aquí tenemos varias compatible con las versionamientos, vamos a ocupar la 9.6.18, seleccionamos en este caso el de producción, puedes también tener uno para desarrollo o texting y vamos a poner el nombre del clúster, vamos a ponerlo como compucloud Test, en este caso ponen el Master User o el admin, más bien vamos a poner Comput Cloud Test pueden ustedes hacer que Amazon o aquí en la configuración ustedes pueden tener un password autogenerado o pueden poner su mismo password, en este caso vamos a poner un password pues propio, después del password seleccionan la familia. Les comento un dato importante que pues como las autoprovisionadas no te mencionan con cuánto storage empiezan, el storage es fácil de sacar en Amazon Aurora, este dato es siempre la cantidad de memoria RAM es el doble de memoria RAM tu storage base, entonces Si ponemos una R Large de 16 GB de RAM, tu storage base va a ser de 32 GB, ponemos en este caso Multi AZ es para la alta disponibilidad y si ustedes quieren añadir una se crea la red réplica y obviamente tiene una escritura de lectura. Seleccionamos la VPC, en este caso ya tenemos configurado una VPC en el cual pues esta VPC va a vivir esta RDS y va a tener salida a Internet, la ponemos con acceso público, aquí un dato muy importante, si ustedes quieren tener esta base de datos simplemente del lado del aplicativo internamente pueden ponerlo sin acceso público debido a que esta conectaría ya en la nube de forma interna, la EC, el servidor con la RDS, en caso de que la quieran pública, que tal vez necesiten hacer una consulta de un aplicativo que está on premise o fuera de la nube, pues la dejamos como pública. La VPC, los Security Groups son reglas, ya sea reglas TCP o UDP en el cual ustedes establecen desde donde quieren consultarla, si tienen alguna IP específica que solamente pueda llegar esta base de datos, OK, la ponen aquí para mayor seguridad o en caso de que pues por cuestiones no tengan alguna VPN o simplemente no tengan una IP estática, pues la pueden dejar abierta al mundo. Estas reglas se configuran en los Security Groups y la pueden dejar abierta al mundo. Y para autentificarnos en la base de datos pues tenemos lo que es Password Authentication, también tenemos otro tipo de password que es a través de la autentificación también de Liam que tomaría las credenciales de Liam para que ustedes puedan poder loguearse, obviamente hay adicionales configuraciones, les comento, las bases de datos aunque sean totalmente administradas por AWS, AWS les da la oportunidad o más bien les da esta configuración extra que son los Parameters Groups, los Parameter Groups ustedes los pueden ocupar ya sea para definir qué tipo de paquetes pueden llegar a consultar esta base de datos, el tamaño de paquetes que va a permitir su base de datos o inclusive el timeout de cada base de datos, ustedes pueden configurarlo en el Parameter Group que ya no se encuentra dentro de RDS sino lo encuentran fuera en las configuraciones extras. Posteriormente dan lo que es Create Database y en unos momentos se estará creando como ven se crea el clúster y se crea por default dos bases de datos. Bueno al principio ustedes van a ver tal vez que los dos se llaman Reader, no se preocupen, no entren en pánico, cuando se cree la primera, la primera se va a llamar de escritura y la segunda se va a quedar como de lectura, cada que se crea pues pasa eso, que las dos se vuelven lectura pero después asigna la escritura a la primera base de datos. ¿Entonces aquí vamos a hacer un ejercicio, en mi caso yo ya tengo instalado pgadmin, vamos a hacer el ejercicio con una de estas bases, vamos a agarrar en este caso una que ya creamos, cuando ya esté creada la base de datos les va a dar dos endpoints, estos son los endpoints que vendrían siendo en este caso el host o cuando normalmente se conectan ustedes a una base de datos vendría siendo la IP, la dirección IP entonces yo copio el primer endpoint de escritura y para conectarme a esta base de datos le doy, bueno como tengo pgadmin le vamos a poner comput cloud reader de escritura y en conexión aquí pide el host name o la dirección vamos a poner lo que es la dirección de Comput Cloud Test 1 el usuario que en su momento perdón dimos de alta en comput cloud test 2 aquí es comput cloud test y pues el password que dimos de alta al realizar la otra base de datos le damos save y como ven se conectó a mi base de datos de escritura y obviamente pues viene pues aquí una por default y aquí pues como dijo mi compañera Zadia nos vamos a preocupar simplemente por el esquema de nuestras tablas en el cual se va a administrar y OK, un dato aquí importante como les mencioné puedes tener una base de datos de solo lectura y otra de solo escritura para pues obviamente si ustedes tienen en la base de datos aquí guardan cosas de ventas pero ciertos programas nada más necesitan que lean esas tablas o sea que absorban información pueden poner la segunda base de datos que solo lectura que aquí la tenemos igual no? ¿Copian el endpoint y entran, hacen la conexión este pero que vamos a ponerle reader y en conexión pues hacemos esta conexión igual la misma en este caso el username o el master name viene siendo el mismo para las dos entonces ponemos comput cloud test y ponemos la contraseña, damos save y listo aquí un dato curioso, no curioso sino un dato muy importante es que en las tablas como pueden ver si ustedes crean una en la de, en la escritura no se crean una tabla llamada userTest OK aquí la creo no? UserTes userter 2 y aquí simplemente dan un refresh la de lectura rápidamente va a tener las dos tablas usertes user pero si ustedes intentan escribir algo en esa tabla les va a mandar un error, este error les va a decir que solamente se puede leer transacciones o sea solamente se puede leer las tablas no puedes escribir absolutamente nada en esta base de datos que es de solo lectura así que no te puedes preocupar o vas a tener la paz mental de que si tú por alguna algún, algún despiste o tal vez te equivocaste y pusiste en apuntaste para estar escribiendo en las tablas a la base de datos de lectura y pues digan, no, pues es que esa es de lectura. Se va a sobrecargar la base de datos de solo lectura, la va a rebotar en automático porque le va a decir que solamente esa base de datos va a ser de lectura. Entonces te va a dar oportunidad de que tú pues cambies el target, no alteres el CPU o el performance de la base de solo lectura. Entonces ustedes al tener separada estas dos bases de datos, van a tener la confianza de que una sola base de datos va a ser solo lectura y la segunda la pueden ocupar para solo lectura. Entonces van a tener dos performances óptimos y no solamente se va a estar sobrecargando una base de datos como viene siendo en una base de datos normal de RDC, que solamente en la misma base de datos hace la escritura lectura y pues se sobrecarga de demanda. Las RDCs normales también tienen la opción de red réplica, de poder hacer una escritura y una de lectura. Pero lo que pasa es que ustedes RDC normal hacer la red réplica, no lo maneja en cluster, lo maneja como dos bases de datos totalmente separadas. Y en el caso de Amazon Aurora te las manejas en un clúster, dentro de un clúster hay dos bases de datos y te da más óptima eficiencia en tus request. Ahora, mi compañera también mencionó lo que era un monitoreo. En este caso para las bases de datos contamos con el monitoreo propio de CloudWatch, que donde nos permite ver las conexiones, CPU de utilización, memoria utilizada de RAM, en este caso está utilizando 2 gigas, no tiene nada. Pero también RS nos nos ofrece lo que es Performance Insight. Performance Insight es un monitoreo en el cual nosotros aquí podemos ver las transacciones, inclusive si tuviéramos un aplicativo totalmente pesado, nos mostraría lo que es los queries que, perdón, que query están consumiendo más VCPUs, que queries están demasiado largos y nos permite tener la oportunidad de nosotros ir mejorando estos queries con tal de que aparte de que ya de por sí Aurora nos ofrece tener un performance alto y una eficiencia operacional, también nos permite la ventaja de que nosotros podemos optimizar nuestro aplicativo para tener que menos pesados queries, más sencillos, más fluidos, nos da esa visibilidad para también no tanto mejor hacia la base de datos, sino también de mejora interna y nosotros podemos mejorar el aplicativo que ya Tenemos. Estos son los beneficios o las noblezas que nos da Amazon RDS. Este sería la demo como tal, ver uno de los puntos característicos de Amazon. Sí estoy en sesión, dime qué pasó. OK, Amazon demono como tal. A continuación, pues mi compañero Jorge dará las cuestiones de promoción.
Muchas gracias, Ismael Saya. Bueno, tenemos unas promociones para los asistentes al webinar. Para los clientes que ya son de CompuCloud, estaremos dándole la asesoría gratuita en temas de RDS y adicional, podemos apoyarlos también con una prueba de concepto para aprobar las instancias de RDS. Solamente, por favor, pónganse en contacto con su ejecutivo de cuenta y estaremos apoyándolos con esta promoción. Para clientes nuevos o prospectos, tenemos un cupón de 200 dólares de descuento en implementación para RDS. Entonces, por favor, vamos a hacerles llegar este cupón durante el día de hoy para que lo tengan en su correo, pero si lo requieren lo más pronto posible, más adelantito, después de las de la sesión de preguntas y respuestas, les vamos a dar lo que son los datos de los ejecutivos de cuenta de las zonas de acuerdo en donde ustedes estén para que los contacten.
More from Paulina
Todo sobre la Nueva Región de AWS en México | Beneficios, Infraestructura y Migración
DEMO: De VMware a AWS. Administración de ambientes dentro de la consola de AWS.