Ancien cours d'analyse des correspondances : données et modèle d'indépendance (partie 1/5)
This video introduces the first part of a five‑lecture series on correspondence analysis (CA) by Jérôme Pagès. It begins by defining the data structure used in CA – a contingency table that cross‑classifies two qualitative variables – and presents diverse examples (literary vocabularies, perfume‑word associations, ecological species counts). The lecture then uses a historic 1974 CREDOC survey of 1 724 French women (questions on ideal family and mother’s activity) to illustrate how margins, joint and marginal probabilities are derived from the table. The independence model for two categorical variables is explained, together with the chi‑square test for significance and the Φ² statistic that measures the intensity of association independent of sample size. The core of CA is presented as a comparison of row (or column) profiles – conditional probability distributions – with the overall marginal profile, highlighting the multidimensional nature of the deviation from independence. Finally, the geometric perspective is introduced: rows and columns are represented as points in a cloud, projected onto low‑dimensional factor planes using factorial analysis, with discussion of inertia, barycentric properties, and interpretative aids such as contributions and representation quality. The video ends by previewing the next session on visualising these deviations.
Chapters
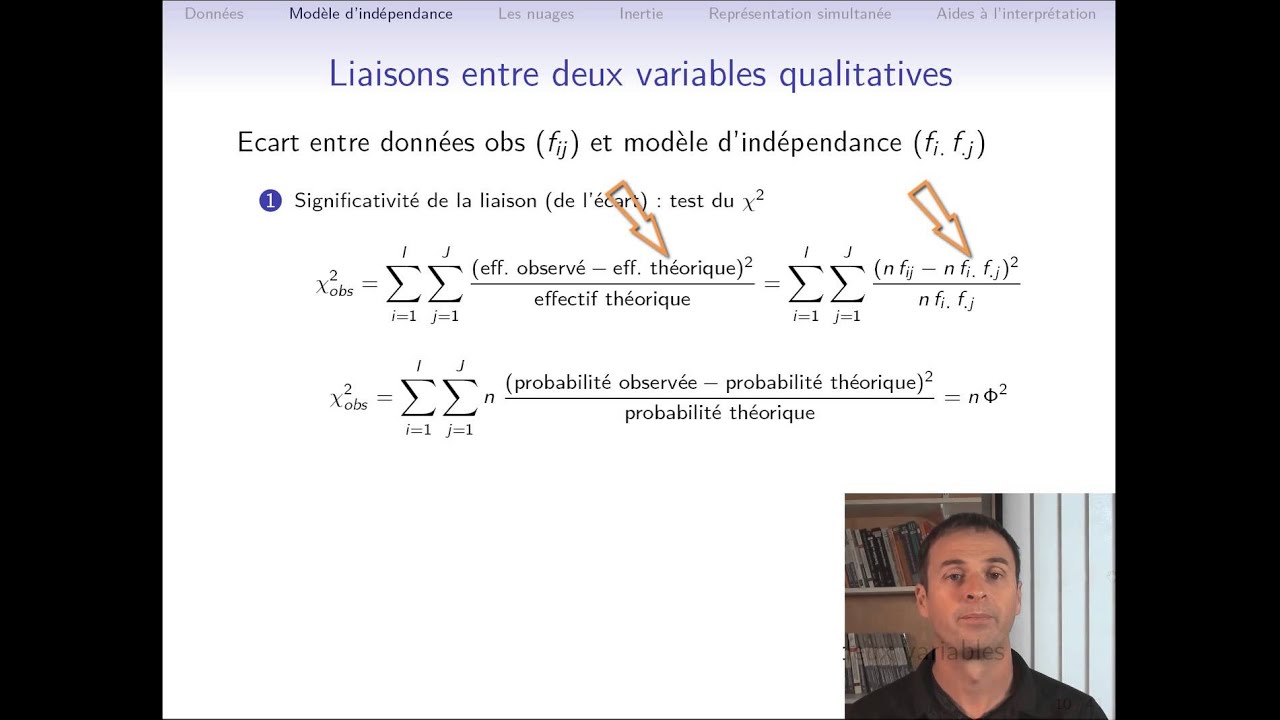
Cette semaine, nous vous présentons 5 vidéos de cours sur l'analyse factorielle des correspondances. C'est un cours conçu par Jérôme Pagès. L'ensemble des vidéos aborde les points suivants: nous commencerons par décrire les données, préciserons quelques notations et les questions que l'on se pose lorsque l'on met en œuvre une analyse des correspondances. Nous verrons que la notion cruciale en analyse des correspondances est celle de la liaison entre 2 variables qualitatives et qu'étudier la liaison entre 2 variables qualitatives, c'est examiner l'écart entre les données et une situation d'indépendance. Nous verrons ainsi comment l'analyse appréhende l'écart à l'indépendance. Nous raisonnerons de façon essentiellement géométrique en construisant un nuage des lignes et un nuage des colonnes, nuages que nous représenterons par analyse factorielle, c'est-à-dire en projetant sur des plans en pratique. Nous donnerons quelques indications sur les pourcentages d'inertie De ce point de vue, l'analyse des correspondances ne se distingue pas d'autres méthodes d'analyse factorielle comme l'analyse en composantes principales. Nous indiquerons également quelques résultats techniques concernant les inerties et là il s'agit de résultats qui sont tout à fait particuliers en analyse des correspondances. De même, en analyse des correspondances, la représentation simultanée des lignes et des colonnes est assez particulière et elle bénéficie des propriétés dites barycentriques. Nous décrirons enfin quelques aides à l'interprétation: contribution et qualité de représentation. De ce point de vue, l'analyse des correspondances n'est pas particulière par rapport à l'analyse en composantes principales par exemple. Commençons donc par décrire les données. Les données sur lesquelles on travaille sont constituées par N individus pour lesquels on dispose de 2 variables qualitatives. Ces données sont regroupées dans un tableau dit de contingence dans lequel on trouve en ligne les modalités de la variable V1, en colonne les modalités de la variable V2 et à l'intersection de la ligne i avec la colonne j on trouve Xij, le nombre d'individus ayant choisi ou possédant à la fois la modalité i de V1 et la modalité j de V2. Ce tableau de contingence est aussi appelé tableau croisé dans la terminologie des enquêtes. Donnons quelques exemples de tableaux de contingence. Un premier exemple, historique parce que c'est sans doute une des premières applications de l'analyse des correspondances, est l'étude du vocabulaire des personnages de la pièce de théâtre Phèdre. On place les personnages en lignes, les mots utilisés par les personnages en colonnes et en xij le nombre de fois que le personnage i a utilisé le mot j. Deuxième exemple, on s'intéresse à la perception de parfums de luxe. Pour cela, on a demandé à des dégustateurs d'associer des mots à chacun des parfums. On place les parfums en lignes, les mots en colonnes et en xij le nombre de fois où le parfum i a été décrit par le mot j. Enfin, en écologie, on s'intéresse à la diversité écologique de plusieurs milieux. On place en lignes les milieux, en colonnes les espèces de plantes ou d'animaux et en xij le nombre de plantes j trouvées dans le milieu i. De telles données sont nombreuses et pour ceux qui connaissent le test du chi² d'indépendance, il s'agit des mêmes tableaux de données. Les données qui vont nous servir à illustrer notre présentation de l'analyse des correspondances sont en quelque sorte des données historiques. Il s'agit d'une ancienne enquête réalisée dans le cadre du CREDOC par Nicole Tabard et publiée en 1974. Voici une reproduction du tableau croisé tel qu'il a été publié par Nicole Tabard en 1974. Dans cette enquête, 1724 femmes ont été interrogées et nous avons sélectionné dans le questionnaire 2 questions relatives à leur attitude à l'égard du travail féminin. Première question: quelle est pour vous la famille idéale? Avec 3 modalités de réponse: les 2 conjoints travaillent également, le mari a un métier plus absorbant que celui de sa femme et seul le mari travaille. Deuxième question: quelle est, toujours selon vous, l'activité qui convient le mieux à une mère de famille quand les enfants vont à l'école? Ici encore, 3 modalités de réponse: rester au foyer, travailler à mi-temps et travailler à plein temps. Alors ce tableau croisé a été complété par ce que l'on appelle les marges. Ici on a ce qu'on appelle la marge colonne. Marge colonne parce qu'elle se présente comme une colonne. Mais chacun de ces termes, par exemple 261, est une somme qui est faite en ligne. 261 est bien la somme de 13+ 142+ 106. Il y a aussi une marge ligne. Cette marge ligne s'appelle marge ligne parce qu'elle se présente comme une ligne. Mais pour l'obtenir on fait la somme des termes en colonne. Ainsi 284 est bien la somme de 13+ 30+ 241. Si l'on regarde les résultats bruts, on s'aperçoit qu'il y a 261 personnes qui ont choisi pour la première question les 2 conjoints travaillent également mais 908 qui ont choisi seul le mari travaille. On peut dire que, à l'aune de cette question, à cette époque-là, une majorité des femmes était hostile au travail féminin. Regardons maintenant les résultats à la deuxième question. Travailler à mi-temps a obtenu 1123 suffrages. C'est donc une réponse largement majoritaire. Si l'on regarde cette question, on peut avoir l'impression qu'à cette époque-là, les femmes étaient favorables au travail féminin. Pas à un travail à temps plein certes, mais favorables tout de même. Ces deux questions semblent donc apporter des réponses un peu contradictoires. Donc se pose la question suivante: mais quel lien y a-t-il entre ces deux questions? Un tableau de contingence est généralement obtenu à partir du croisement de 2 variables. Donc initialement, les données sur lesquelles on travaille sont constituées par n individus pour lesquels on dispose de 2 variables qualitatives. Dans le tableau de données que l'on voit ici, l'individu l possède la modalité i de la variable V1 et la modalité j de la variable V2. On construit alors un tableau de contingence ou tableau croisé en mettant en regard les modalités de la première variable V1 en en ligne par exemple, et les modalités de la seconde variable V2, ici en colonne. À l'intersection de la ligne i et de la colonne j, on trouve Xij, le nombre de personnes ayant choisi ou possédant la modalité i de V1 et la modalité j de V2. Si l'on calcule la somme de tous les termes de ce tableau, on trouve N. Ce tableau contient donc la distribution des N individus. Dans notre cas, ce sont les N personnes qui ont été interrogées dans les i× j cases du tableau. À partir de ce tableau de contingence, on va calculer le tableau de probabilités correspondant. Et l'analyse des correspondances va en fait travailler sur le tableau des probabilités. Pour obtenir une probabilité, par exemple fij, on divise simplement l'effectif xij par l'effectif total n. On obtient bien ainsi la probabilité conjointe de posséder à la fois la modalité i de V1 et la modalité j de V2. C'est ce terme que l'on met dans le tableau. Quand on fait la somme de tous ces termes, on obtient 1, ce qui est bien la marque d'une distribution de probabilités. Ce tableau va être complété par sa marge colonne. On va noter fi. la somme des termes de la ligne i. De même, on va compléter ce tableau par une marge ligne dont le terme général f.j est obtenu en faisant la somme des termes de la colonne j. Notre problème est de regarder la liaison entre V1 et V2. C'est-à-dire l'écart entre les données observées et une situation d'indépendance. Donnons quelques précisions sur l'indépendance entre 2 variables qualitatives et comment l'analyse des correspondances appréhende l'écart à l'indépendance. Commençons par rappeler le modèle d'indépendance pour 2 événements. 2 événements sont indépendants si la probabilité de A et B est égale au produit des probabilités: probabilité de A fois probabilité de B. Pour 2 variables qualitatives, on va avoir fij, probabilité de i et de j, est égale à fi, probabilité de i, multipliée par fj, probabilité de j. Mais ceci doit être vrai, bien sûr, quel que soit i et quel que soit j. On dit que la probabilité conjointe est le produit des probabilités marginales. Il y a une autre écriture de ce modèle d'indépendance que l'on voit ici: fij sur fi point est égal à f point j. Dans ce cas, on dit que la probabilité conditionnelle est égale à la probabilité marginale. Ceci peut paraître un peu formel mais finalement cette écriture est plus proche de l'intuition d'indépendance. La probabilité conditionnelle ici c'est la probabilité d'être J sachant que l'on est I. Et donc s'il y a indépendance, cette probabilité est égale à la probabilité d'être J même si l'on ne dispose d'aucune information quant à l'autre variable, c'est-à-dire I. Il y a enfin l'écriture symétrique dans laquelle on divise fij par f.j. Et selon le modèle d'indépendance, cette nouvelle probabilité conditionnelle, c'est-à-dire la probabilité cette fois d'être i sachant que l'on est j, est bien égale à la probabilité marginale d'être i. La liaison entre 2 variables qualitatives, c'est l'écart entre les données observées d'une part, c'est-à-dire fij, et le modèle d'indépendance d'autre part, c'est-à-dire fi. que multiplie f.j. Quand on étudie la liaison entre 2 variables qualitatives, on réalise généralement en premier lieu un test de significativité de la liaison en mettant en œuvre un test du chi². On rappelle ici la forme du test du chi² dans lequel on confronte les effectifs observés avec les effectifs théoriques. L'effectif théorique est tout simplement la probabilité selon le modèle d'indépendance, c'est-à-dire fi.f.j multiplié par l'effectif total n. Dans cette quantité du chi², on peut mettre N en facteur et faire apparaître la quantité N phi carré. Le phi carré, lui, confronte les probabilités observées et les probabilités théoriques. C'est donc un indicateur d'intensité de la liaison. C'est l'écart entre probabilités observées et probabilités théoriques. Pourquoi intensité de la liaison? Parce que ce terme ne dépend pas de l'effectif mais uniquement des probabilités. Il y a enfin un 3ème point qui est la nature de la liaison, c'est-à-dire comment les modalités des 2 variables s'associent entre elles. L'analyse des correspondances travaille sur le tableau des probabilités, elle ne dit donc rien sur la significativité. Son objectif essentiel est de visualiser la nature de la liaison entre les 2 variables. Donc petit récapitulatif sur ces 3 points concernant l'étude d'une liaison. Distinguons bien la significativité de l'intensité. Pour l'intensité par exemple, on a réalisé une petite enquête et on vous dit que, à l'issue de cette enquête, toutes les personnes qui ont les yeux bleus portent des lunettes. On ne peut pas imaginer de liaison plus forte puisque systématiquement, pour la variable couleur des yeux, si l'on sait que l'on a les yeux bleus alors on porte des lunettes. L'intensité de la liaison est très grande. Mais maintenant si je vous dis, en fait cette enquête a porté sur 4 personnes, alors évidemment On imagine bien, sans même réaliser le test du chi², que ceci n'est pas significatif. Comment l'analyse des correspondances appréhende-t-elle l'écart à l'indépendance? On va d'abord adopter le point de vue d'une analyse par ligne. Dans cette analyse, on se réfère au modèle d'indépendance suivant: la probabilité conditionnelle sachant i est égale à la probabilité marginale. Pour cela, dans le tableau, on va diviser chaque élément d'une ligne par sa marge. On obtient ainsi ce qu'on appelle un profil ligne i qui n'est rien d'autre qu'une distribution conditionnelle. Dans cette ligne, on a la distribution des réponses pour la variable V2 sachant que l'on possède la modalité i de la variable V1. Ce profil ligne, on va le comparer au profil ligne moyen qui est donc la distribution marginale de la variable V2. Alors pour comparer la distribution conditionnelle à la distribution marginale, l'analyse des correspondances va comparer les profils lignes au profil moyen. Il s'agit bien d'une approche multidimensionnelle de l'écart à l'indépendance parce que l'on considère simultanément l'ensemble des profils. Donc la question c'est bien de comparer la probabilité conditionnelle fij sur fi. et la probabilité marginale f.j mais ceci pour l'ensemble des j. Tout ceci est un peu formel, illustrons dans l'exemple ce que signifie comparer un profil au profil moyen. Construisons pour chaque profil ligne un graphe en barres empilées afin de visualiser les profils. Examinons la ligne seul le mari travaille. Il s'agit de la distribution des réponses à la question activité concernant une mère de famille pour les femmes qui ont déjà répondu seul le mari travaille. Plus concrètement, parmi les femmes qui ont répondu seul le mari travaille, 26,54% ont répondu rester au foyer. Alors pour apprécier ce pourcentage, il faut le comparer à celui correspondant dans la population totale qui est 16,47%. Donc ce pourcentage est plus important. Ainsi la comparaison du profil ligne seul le mari travaille au profil moyen correspond à la question suivante: les femmes qui ont répondu seul le mari travaille répondent-elles de façon particulière à la question sur l'activité d'une mère de famille? Nous allons maintenant étudier ce même tableau mais en procédant par colonne. Alors lorsqu'on réalise une analyse par colonne, on se réfère au modèle d'indépendance suivant: fij sur f.j égal fi point. Précisons: on construit le tableau suivant des profils colonnes. Examinons la colonne j. fij sur f.j, c'est la probabilité conditionnelle de répondre i sachant que l'on a déjà répondu j. La somme des termes de cette colonne vaut 1, il s'agit bien d'une distribution de probabilités. De même que l'on a construit le profil colonne j, on va construire le profil colonne moyen. Ce profil colonne moyen a pour terme général fi. qui est la probabilité de répondre i. L'idée de l'analyse des correspondances est de comparer les profils colonnes au profil moyen. Il s'agit là encore d'une approche multidimensionnelle de l'écart à l'indépendance. Multidimensionnel parce que l'on va considérer dans l'ensemble tous les termes d'une colonne que l'on va comparer à tous les termes correspondants de la colonne du profil moyen. Examinons dans l'exemple ce que signifie comparer un profil colonne au profil moyen. Construisons pour chaque profil colonne un graphe en barres empilées afin de visualiser les profils. Examinons par exemple la colonne travailler à mi-temps. 12,64 est le pourcentage de femmes ayant répondu les 2 conjoints travaillent également parmi celles qui ont répondu travailler à mi-temps. Ce pourcentage doit être comparé au pourcentage correspondant dans la population totale qui est de 15,14%. La différence n'est pas très importante donc quand on compare ce profil colonne au profil moyen, on répond à la question suivante: les femmes qui ont répondu travailler à mi-temps répondent-elles de façon particulière à la question sur la famille idéale? Nous avons vu sur quelles données travaille l'analyse des correspondances et que l'analyse des correspondances compare une situation à une situation d'indépendance. Nous verrons dans la prochaine vidéo comment visualiser les écarts à l'indépendance en construisant un nuage des lignes et un nuage des colonnes.
More from Yamossoun











Algorithme de calcule de la racine carrée par dichotomie #dichotomy #squareroot #algorithm