In this French‑language lecture, the instructor explains how to characterize the groups (classes) obtained after a partitioning/clustering of individuals. The session begins by introducing the concept of a paragon—the real individual closest to a class’s centroid—and shows how to display these representatives on a factorial map. It then moves to global variable selection: for each quantitative variable an ANOVA/Fisher test is performed with class membership as the explanatory factor, retaining variables with p‑values below 5 % and ranking them by significance. The lecture stresses that variables used to build the partition (active variables) must be interpreted cautiously. Next, the speaker details a class‑specific quantitative test based on the Central Limit Theorem. By comparing the class mean to the overall mean, a standardized statistic is computed; values beyond ±1.96 indicate that the variable characterizes that class. The method is illustrated with temperature data for French cities, showing which months best distinguish each class. The lecture then covers qualitative variables: a chi‑square test links each categorical variable to the class variable, and for each modality a hypergeometric test evaluates over‑ or under‑representation within a class. The resulting p‑values (or their normal‑score equivalents) are used to rank modalities. Factorial axes, produced by a prior factor analysis, are treated as quantitative variables and subjected to the same CLT‑based test, allowing classes to be described in terms of their positions on the axes. The instructor distinguishes between active variables (used to compute distances) and illustrative variables (not used in the clustering) and explains how both can be employed in interpretation. Finally, the lecture recaps the whole workflow—from hierarchical clustering and tree cutting to partitioning, then to class characterization using both quantitative and qualitative variables—and points to the FactoMineR package for practical implementation, encouraging learners to complete quizzes and exercises.
Chapters
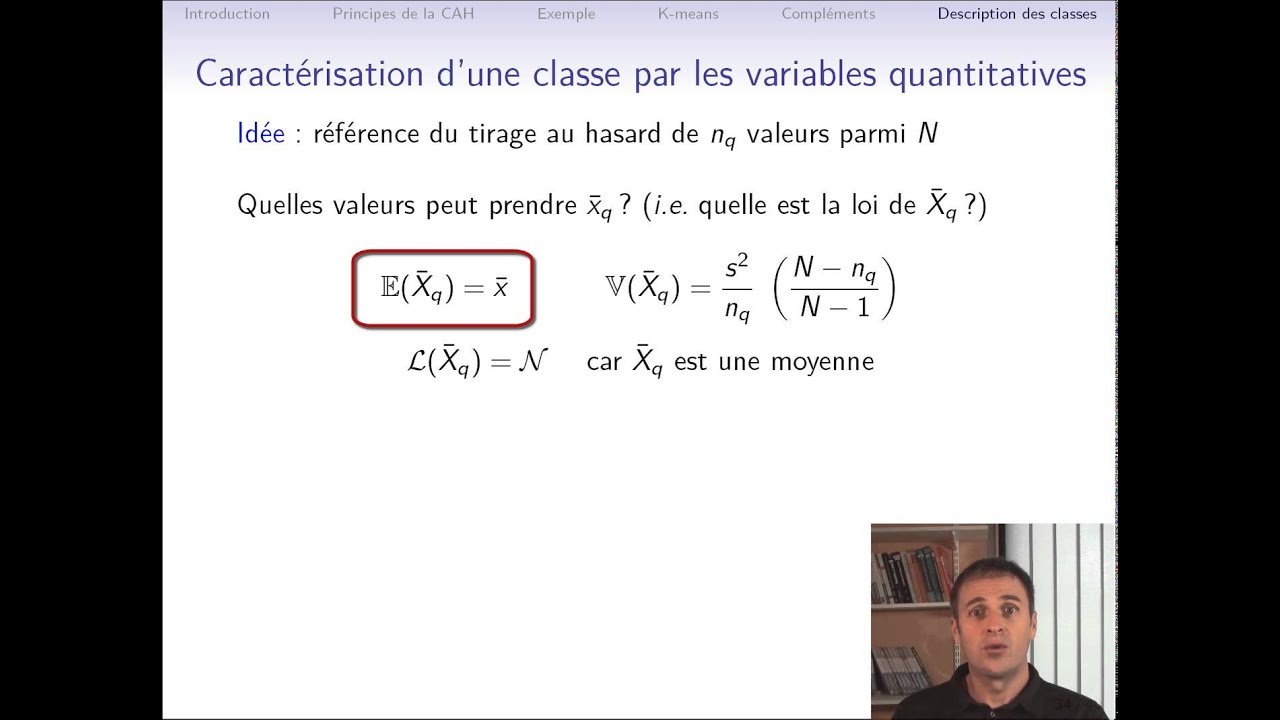
Maintenant que nous avons vu comment constituer des classes, quels étaient les individus de chaque classe, intéressons-nous à la caractérisation de classes d'individus. On peut tout d'abord donner le parent rond de chaque classe, c'est-à-dire l'individu le plus proche du centre de la classe. Pourquoi utiliser l'individu le plus proche du centre de la classe? Parce que le centre de gravité d'une classe est un individu moyen fictif et il est préférable d'utiliser un vrai individu pour comprendre comment se comporte la moyenne d'une classe. Donc par exemple ici on voit que dans la classe 1 c'est Montpellier qui est le plus proche du centre de la classe. Il est à une distance de 0.42 du centre de gravité de la classe. Et donc si on veut interpréter comment se comporte la moyenne de la classe, on peut regarder l'individu Montpellier. Pour la classe 2 c'est Rennes qui est le plus proche du centre de la classe et pour la classe 3 c'est Vichy. Les parangons sont assez utiles pour ceux qui connaissent bien les données. On peut représenter ces parangons sur le plan factoriel. On a ici le centre de gravité de la classe 2 et le parangon de cette classe qui est Rennes. Cette caractérisation des classes par l'individu le plus proche du centre de la classe ne suffit pas. Nous aimerions aussi caractériser les classes par les variables. L'objectif est alors de trouver les variables qui caractérisent le mieux la partition dans son ensemble ou qui caractérisent le mieux une classe d'individus. Donc les questions sont: quelles sont les variables qui caractérisent le mieux la partition? Comment caractériser les individus de la classe 1? Quelles variables les caractérisent le mieux? La partition, c'est-à-dire l'appartenance des individus aux différentes classes, peut être considérée comme une variable qualitative à autant de modalités qu'il y a de classes. Donc chercher les variables qui caractérisent le mieux une partition revient à chercher les variables qui caractérisent le mieux une variable qualitative. Pour chaque variable quantitative, on va construire un modèle d'analyse de variance entre la variable quantitative, qui aura le rôle de la variable réponse, en fonction de la variable de classe qui aura le rôle de la variable explicative. Donc on fait une analyse de variance de la variable quantitative en fonction de la variable de classe. Et on construit un test de Fisher pour voir s'il y a un effet de la variable de classe sur la variable quantitative. On peut conserver les variables ayant une probabilité critique inférieure à 5% et trier ces variables par probabilité croissante. On voit dans l'exemple que la variable qui caractérise le mieux les classes est la variable octobre qui a la probabilité critique la plus petite et qui permet donc de bien séparer les classes. Notons que, Comme pour la description des dimensions en analyse factorielle, il faut utiliser ces tests avec prudence puisque la variable octobre a joué un rôle actif dans la construction des axes puisqu'elle a participé au calcul des distances entre individus. Donc seules les probabilités critiques associées aux variables supplémentaires latitude et longitude peuvent être réellement interprétées comme usuellement. Les probabilités critiques des variables actives restent utiles même si elles ne peuvent pas être utilisées comme des tests classiques. Le critère du test de Fisher permet de trouver les variables qui caractérisent globalement la partition. Maintenant si on veut comprendre chacune des classes, comment caractériser chaque classe par les variables? Cette représentation permet de visualiser les données. Chaque ligne correspond à une variable, chaque point correspond à une ville. Les points en vert représentent les villes Lyon, Paris, Grenoble, Clairmont, Vichy, Strasbourg, Lille. En bleu les villes de Nantes, Rennes et Brest et en rouge les villes de Nice, Marseille, Montpellier, Toulouse, Bordeaux. Et on cherche à voir s'il y a des variables qui permettent de bien caractériser une classe. Donc est-ce que les valeurs d'une variable sont extrêmes, particulières pour les individus d'une classe? On a l'impression par exemple que pour la variable janvier, les villes en vert ont des valeurs plus faibles que toutes les autres. Et donc que la variable janvier caractérise les villes de la classe verte. Évidemment, il n'est pas question de passer chaque classe et chaque variable une par une à partir d'un tel graphe. On a besoin de procédures automatiques. L'idée pour savoir si une variable caractérise une classe est la suivante: si les valeurs d'une variable quantitative X pour les individus de la classe q semblent tirées complètement au hasard parmi toutes les valeurs de X, alors la variable X ne caractérise pas la classe car les individus de la classe Q ne prennent pas de valeurs particulières sur X. Au contraire, si les valeurs de X semblent très particulières pour les individus de la classe Q, alors l'hypothèse d'un tirage au hasard est douteuse et on dira que la variable X caractérise la classe. Ici sont représentées les valeurs de 2 variables, une variable avec des données au hasard et la variable du mois d'août. On voit que pour la variable au hasard, on a des points bleus, verts et rouges qui sont répartis un peu n'importe comment alors qu'on a l'impression que les points sont plus structurés pour le mois d'août. Le mois d'août semble caractériser la classe rouge par exemple qui a des points assez extrêmes. L'idée est assez intuitive, essayons de construire un test. L'idée générale est de se comparer à un tirage au hasard de n q valeurs parmi N. On a n q valeurs dans la classe q, est-ce que ces valeurs sont choisies au hasard parmi les N valeurs de la population? Ou alors est-ce qu'on remet en question le fait que ces valeurs soient choisies au hasard dans la population? Pour le savoir, il nous faut déterminer quelle valeur peut prendre X barre q, la moyenne d'une classe. Autrement dit, il nous faut déterminer la loi de X barre q. L'espérance de X barre q sous l'hypothèse d'un tirage au hasard C'est la moyenne de toute la population, c'est-à-dire X-barre. Pour calculer la variance de X-barre Q, on doit considérer qu'on tire, sans remise, NQ valeurs dans une population de taille finie grand N. C'est donc la variance de la population, ici S carré, divisé par le nombre d'individus tirés NQ, mais comme on est dans une population de taille finie, il y a le terme correctif / . Quant à la loi de X barre Q, comme X barre Q est une moyenne, on peut considérer que sa loi est normale grâce au théorème central limite. On peut alors calculer ce qu'on appelle une valeur centrée-réduite X barre Q moins X barre sur l'écart-type de X barre Q, c'est-à-dire la racine carrée de la variance de X barre Q. Cette quantité, sous l'hypothèse d'un tirage au hasard, va suivre une loi normale centrée-réduite. Si la valeur-test est comprise entre -1,96 et 1,96, elle peut provenir d'une loi normale centrée-réduite et donc elle n'est pas particulière. Si maintenant la valeur absolue de la valeur-test est supérieure à 1,96, alors cette valeur-test est particulière et il est peu probable qu'elle provienne d'une loi normale centrée-réduite. On remettra alors en cause l'hypothèse d'un tirage au hasard des N q-valeurs parmi les N. C'est-à-dire que les valeurs de X pour la classe q semblent particulières et donc ça veut dire que la variable X caractérise la classe q. Et plus l'hypothèse d'un tirage au hasard est douteuse, plus la valeur-test sera grande et plus la variable X caractérisera la classe. Il est alors possible de trier les variables par valeur-test décroissante. On a les résultats suivants pour la classe 1: la valeur-test la plus grande est pour la variable septembre, ce qui signifie que la variable septembre est la variable qui caractérise le mieux la classe 1. La moyenne des individus pour septembre est de 19,30°C alors que la moyenne générale pour tous les individus, y compris ceux de la classe 1, est égale à 17°C. On a ensuite l'écart-type dans la catégorie, 0,755, et l'écart-type de la population totale, 1,79. La dernière colonne donne la probabilité critique associée au test que la valeur-test suive une loi normale. Cette première classe est caractérisée par beaucoup de variables. Toutes les valeurs-tests sont positives, ce qui signifie que les valeurs prises sont plus grandes pour les individus de la classe 1 que pour les individus en général. Cette classe correspond aux villes où il fait chaud tous les mois de l'année. Pour la classe 2, les valeurs-tests sont négatives. La valeur-test la plus extrême est donc la dernière, à savoir celle de l'amplitude thermique annuelle. La valeur-test étant négative, la moyenne de la classe 12,40 est inférieure à la moyenne générale qui est de 15,90. Et pour la classe 3, là encore on a les valeurs-tests négatives et il faut lire le tableau en partant du bas. La variable qui caractérise le plus la classe 3 est la variable de janvier qui a la valeur-test la plus extrême, -3,36. Et effectivement la moyenne dans la classe est de 2,11°C contre 3,97°C pour la moyenne générale. Peut-on caractériser les classes par des variables qualitatives? Pour ce faire, il faut à nouveau considérer que la partition est une variable qualitative et on cherche alors le lien entre 2 variables qualitatives. On peut alors construire pour chaque variable qualitative un test du chi² entre une variable qualitative et la variable de classe. On peut ensuite trier les variables qualitatives par probabilité critique croissante. Dans l'exemple, il n'y avait qu'une seule variable qualitative, la variable région. Cette variable est liée à la partition des individus. Peut-on maintenant caractériser chaque classe en fonction des modalités? Prenons l'exemple de la classe 3 et voyons si la modalité nord-est caractérise cette classe. L'idée est de comparer la proportion de nord-est dans la classe 3 par rapport à la proportion de nord-est dans la population globale. On peut donc construire un tableau réduit avec juste la modalité nord-est et toutes les autres modalités regroupées en une seule modalité qu'on appellera autres. De même, on a la classe 3 et toutes les autres classes qui sont regroupées. On peut construire un test pour comparer la proportion de nord-est dans la classe 3 et dans la population globale. L'hypothèse H0 est de considérer que ces 2 proportions sont égales. Contre l'hypothèse alternative, la modalité nord-est est surreprésentée dans la classe ou sous-représentée dans la classe. Sous l'hypothèse nulle H0, la variable aléatoire notée Nmc qui représente le nombre d'individus de la modalité m dans la classe c suit une loi hypergéométrique de paramètres n, Nm/N et Nc. On peut alors calculer la probabilité d'avoir une valeur encore plus extrême que celle observée, c'est-à-dire ici 3. On obtient alors le tableau suivant. En ligne, on a les modalités. Ici nous avons juste une seule ligne correspondant à la modalité nord-est. La première colonne du tableau donne la proportion de villes appartenant à la classe 3 parmi les villes du nord-est. Le calcul est donc Nmc sur Nm, soit ici 3 divisé par 3= 100%. La 2ème colonne donne le pourcentage de villes de la classe 3 qui prennent la modalité nord-est. Ici 3 villes parmi les 7 de la classe 3 sont du nord-est, soit 42,86%. La colonne globale donne la proportion de villes du nord-est dans la population globale, soit ici Nm sur N et 3 divisé par 15 soit 20%. La 4ème colonne donne la probabilité critique du test nous indiquant si la modalité caractérise significativement ou non la classe. Ici la probabilité critique est de 0,07, ce qui est légèrement supérieur à 5%, donc on aura tendance à accepter l'hypothèse H0 et donc à considérer que la modalité nord-est n'est pas caractéristique pour la classe, elle n'est ni sous-représentée ni sur-représentée dans la classe 3. On s'attachera donc à commenter la probabilité critique et à comparer les proportions dans la classe et dans la population pour voir si la modalité est sur ou sous-représentée. La valeur-test, qui est ici juste une conversion de la probabilité critique en quantile de loi normale, donne ces 2 informations: si sa valeur absolue est supérieure à 1.96, alors la modalité caractérise la classe de façon significative. Et si le signe est négatif, la modalité est sous-représentée, si le signe est positif, la modalité est sur-représentée. Finalement, comme pour les variables quantitatives, toutes les modalités des variables qualitatives caractérisantes peuvent être triées par probabilité critique croissante. Il est également possible de caractériser les classes par les axes factoriels. Ces axes factoriels sont des variables quantitatives et on peut donc utiliser exactement la même méthodologie que celles que nous venons d'utiliser pour les variables quantitatives. On voit que la classe 1 est caractérisée par le premier axe factoriel. La valeur-test étant positive, les individus de cette classe ont des coordonnées particulièrement extrêmes et positives sur la première dimension factorielle. La moyenne dans la classe est de 3.97 alors que la moyenne générale est de 0. Pour les dimensions factorielles, la moyenne de toutes les coordonnées est toujours égale à 0 puisque les coordonnées factorielles sont centrées. Les individus de la classe 2 prennent des valeurs plus extrêmes sur la dimension 2 et les individus de la classe 3 ont des valeurs plus extrêmes sur les dimensions 1 et 2, ils prennent des valeurs négatives sur ces 2 dimensions. Pour conclure, rappelons tout ce que nous avons vu. Les méthodes de classification s'appliquent sur des tableaux individus× variables quantitatives mais si les variables sont qualitatives on peut utiliser l'ACM pour transformer les variables qualitatives en dimensions factorielles qui sont des variables quantitatives. La classification ascendante hiérarchique fournit un arbre hiérarchique qui montre les distances entre individus et entre groupes d'individus et qui donne également une idée du nombre de classes dans le jeu de données. On peut alors utiliser une méthode de partitionnement pour consolider les classes obtenues en coupant l'arbre hiérarchique. Les classes sont alors plus stables mais on perd la hiérarchie entre les classes. Ces méthodes de partitionnement peuvent aussi à être utilisé comme prétraitement quand les données sont de grandes dimensions. Enfin, pour terminer, on peut caractériser les classes par des variables quantitatives et des variables qualitatives. Ces variables peuvent avoir servi à calculer les distances entre individus ou non. En d'autres termes, elles peuvent être actives ou illustratives. Vous avez vu toutes les vidéos sur la classification. Vous pouvez maintenant voir la vidéo sur FactoMineR pour voir comment mettre en œuvre la classification sous FactoMineR et comment caractériser des classes d'individus avec FactoMineR. N'oubliez pas non plus de faire les quiz et les exercices.