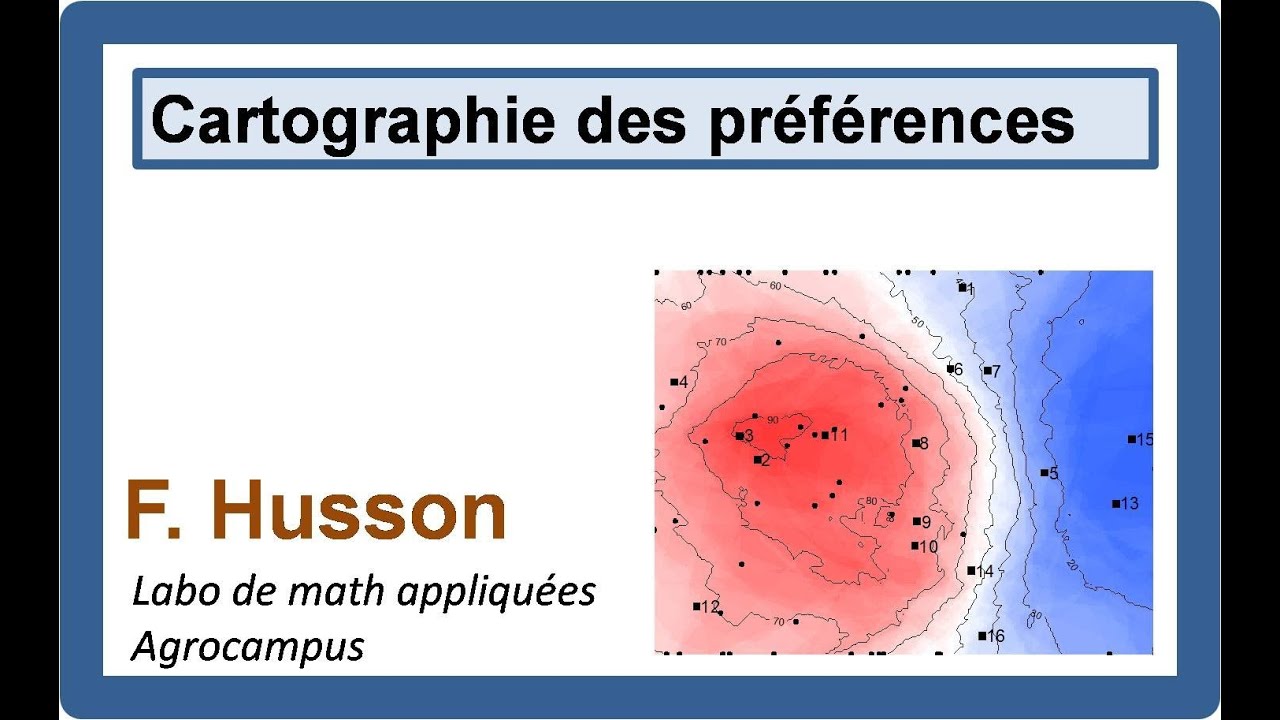
Cette présentation détaille les approches de cartographie des préférences consommateurs, visant à relier les jugements hédoniques aux caractéristiques sensorielles et physico‑chimiques des produits. Deux types de cartographies sont distingués : interne (construction d’une carte produit à partir des préférences, puis projection des descripteurs) et externe (construction de la carte à partir des descripteurs, puis superposition des préférences). L’auteur montre comment appliquer une ACP sur les données consommateurs ou sur les descripteurs, comment interpréter les axes (ex. sucré vs acide), et comment segmenter les consommateurs via classification hiérarchique. Il décrit ensuite la construction de modèles de régression individuels (linéaires puis incluant termes quadratiques et interactions) pour prédire la préférence en fonction des coordonnées factorielles, la génération de surfaces de préférence sur une grille du plan factoriel, et l’agrégation de ces surfaces pour obtenir des zones de préférence collectives. Les fonctions Sensominer « CartoConsumer » et la visualisation des zones (rouge/bleu, lignes de niveau) sont illustrées avec des cocktails de fruits. Enfin, les avantages (visualisation intuitive, prise en compte de non‑linéarités) et les limites (instabilité des jugements, effet du premier produit, nombre limité de produits, sur‑paramétrisation) de la méthode sont discutées.
Chapters
Donc on va passer maintenant à l'analyse des préférences des consommateurs, donc essayer de relier les préférences à la description sensorielle des produits. Donc la question, c'est la question que je vous avais posée tout à l'heure, elle est très simple, c'est: est-ce que les consommateurs aiment les produits? Pourquoi est-ce qu'ils aiment certains produits et n'aiment pas d'autres produits? Donc essayer de comprendre l'appréciation et après Question subsidiaire, c'est: est-ce qu'on peut trouver un nouveau produit à fabriquer qui serait apprécié par un très grand nombre de consommateurs? Pour éventuellement avoir un produit qui plaise à une cible de consommateurs suffisante pour que le produit soit viable. On va relier les préférences des consommateurs aux caractéristiques des produits. Alors ça peut être les caractéristiques sensorielles, ça pourrait être aussi les caractéristiques physico-chimiques. On pourrait relier les données de préférences aux données physico-chimiques ou relier les données de préférences à la fois données physico-chimiques et données sensorielles. Et ce qu'on va essayer de faire, c'est de trouver une façon pour visualiser les liaisons entre les préférences et les descriptions des produits qui soit assez facile à lire sur une carte sensorielle. Alors pour la cartographie des préférences, on va distinguer 2 types de cartographie: cartographie qu'on appelle interne et cartographie externe. Alors dans la cartographie interne, on se focalise sur les préférences des consommateurs, donc les différences entre produits, on les voit à travers les préférences des consommateurs. Construire une carte des produits en se basant sur les préférences des consommateurs. Et puis après, on va essayer de mettre en relation les données sensorielles ou les données physico-chimiques par rapport aux différences qu'on a vues sur les préférences. Et la cartographie externe, c'est l'inverse: on construit d'abord une carte des produits à partir de la description sensorielle ou physico-chimique et après seulement on relie les données de préférence. Alors je vais commencer par vous détailler la cartographie interne et puis après on passera un peu plus de temps sur la cartographie externe qui est sûrement la plus intéressante. Donc bien là, on va construire le même tableau que précédemment, à savoir en ligne des produits, en colonne les consommateurs. Donc un consommateur correspond à une variable, et puis on rajoute à la suite de ce tableau l'autre tableau avec les produits en ligne et les descripteurs sensoriels en colonne. Ou les descripteurs physico-chimiques aussi. Donc le premier tableau avec les consommateurs, on a en général beaucoup de variables. Si on a interrogé 100 consommateurs, on a une centaine de variables ici, et puis après un tableau avec 10 ou 12 descripteurs sensoriels. Comme on veut construire une carte des produits qui dépend des préférences des consommateurs, eh bien on va construire une ACP en mettant en actif les préférences des consommateurs. Donc là, on va bien avoir 2 consommateurs qui sont proches s'ils ont à peu près les mêmes préférences, s'ils apprécient peu les mêmes produits et qu'ils apprécient beaucoup les mêmes produits. Et puis après, eh bien, on reliera les données sensorielles et physico-chimiques sur cette carte en projetant en supplémentaire les descripteurs sensoriels et les variables physico-chimiques. Voici les résultats de l'ACP sur cette analyse. En haut, vous avez le graphe des individus. Alors, les individus sont les produits ici, et les produits, c'était des cocktails de fruits avec, je vous ai dit, un mélange de jus de banane, jus d'orange, jus de mangue et jus de citron. Donc les libellés des individus ici, vous avez des O, B, M et C. Donc vous avez un M, enfin vous avez une lettre majuscule quand le dosage de l'ingrédient est à une dose très forte, vous avez un m minuscule quand le dosage est moyen et vous avez pas la lettre quand le dosage est faible. Donc par exemple le cocktail ici en bas là, B.O., c'est avec beaucoup de jus de banane et et un taux de jus d'orange qui est moyen. Et puis MCB*, tout en haut, c'est beaucoup de jus de mangue, beaucoup de jus de citron et un taux de jus de banane moyen et un taux de jus d'orange qui est faible. Il y a des petites étoiles de temps en temps parce qu'il y avait certains produits dans lesquels on avait rajouté un colorant qui était sans saveur, sans odeur. D'accord, donc ça c'est le graphe des individus. Ensuite vous avez le graphe des variables, donc le graphe des consommateurs. Chaque flèche correspond à un consommateur. Alors comme il y a beaucoup de variables, j'ai enlevé le libellé des variables. De toute façon j'avais les numéros des consommateurs, c'est pas très informatif, donc j'ai juste laissé les flèches. Alors qu'est-ce qu'on voit sur ce graphe? Qu'est-ce que vous diriez à partir de ce graphe? Voilà, l'appréciation des consommateurs est assez homogène. Tout le monde apprécie les produits qui sont plutôt vers la droite, donc notamment beaucoup de mangue et un taux de banane moyen, jus d'orange, orange, banane, mangue avec un taux moyen. Et les gens rejettent les cocktails avec beaucoup il y a beaucoup de citron. Tous les cocktails qui sont sur la gauche ici ont un C majuscule et donc c'est des cocktails avec beaucoup de citron. Et effectivement, le dosage fort de citron était vraiment fort et donc ça attaquait, c'était vraiment trop fort. Et donc là, on voit qu'il y a un rejet assez important de ces cocktails. Alors ça, c'est juste quand je suis sur l'appréciation. Maintenant je peux essayer de comprendre pourquoi les gens aiment et pourquoi les gens n'aiment pas. Les gens aiment parce que c'est sucré. La variable sucré est corrélée positivement à l'axe, comme beaucoup d'appréciations. Et puis la variable acide, intensité d'attaque, est corrélée négativement. Ces 2 variables acide et intensité d'attaque sont corrélées négativement, donc les gens n'apprécient pas quand c'est trop acide et quand il y a une trop forte intensité d'attaque. Donc là, c'est vrai qu'on arrive à comprendre pourquoi les gens apprécient un produit et pourquoi les gens n'aiment pas le produit. Alors sur ces données, ce qu'on peut faire aussi, puisqu'on est focalisé sur les préférences des consommateurs, c'est construire des groupes de consommateurs, faire de la segmentation de consommateurs pour voir s'il y a des appréciations qui sont différentes selon les différents segments de consommateurs. Alors pour ce faire, eh bien on va construire le tableau avec en ligne les consommateurs et en colonne les produits. Les consommateurs vont être les individus et les produits vont jouer le rôle des variables. Donc on transpose le jeu de données produits-consommateurs, et sur ce tableau on va faire une classification. Donc 2 lignes, 2 consommateurs seront proches s'ils prennent des valeurs proches sur l'ensemble des produits. Alors ce qu'on peut faire éventuellement sur ce tableau de données, c'est d'abord centrer les données par consommateur pour qu'il n'y ait pas un effet d'utilisation de l'échelle de notation. Et donc, bien, à droite vous avez l'arbre hiérarchique. Alors l'intérêt de l'arbre hiérarchique, c'est que ça va nous suggérer un découpage en classes, un nombre de classes, et de se dire, bien, par exemple dans cette analyse, ça peut être intéressant de découper les consommateurs en 3 classes, et après, bien, on va essayer de caractériser chacune de ces classes. Donc l'arbre sert principalement à ça, parce qu'après vous avez énormément d'individus et vous n'avez pas tellement d'autres informations à tirer de cet arbre. Et après, ce qui est surtout intéressant, c'est de caractériser les classes. Donc je peux décrire les classes par les variables de mon analyse, et donc ici les variables ce sont les produits. Et donc j'ai pour chaque classe les produits qui sont plus appréciés par les individus de la classe par rapport aux individus des autres classes et les produits qui sont moins appréciés. Donc vous voyez par exemple dans la classe 1, c'est une classe dans laquelle les produits BO et MB sont plus appréciés que dans les autres classes. Et puis au contraire, les produits OCM, OCB sont des produits qui sont très peu appréciés, qui sont vraiment très fortement rejetés par cette classe de consommateurs. La classe 2, il n'y a pas vraiment, il n'y a pas de produits qui caractérisent cette classe en positif. C'est une classe qui va rejeter les produits MB, BMC, OBMC, mais il n'y a pas de produits qui sont très appréciés par cette classe, plus que dans les autres classes en tout cas. Ici dans cet exemple, la caractérisation des classes n'est pas très informative. Ce qui est intéressant dans la caractérisation des classes, c'est d'ajouter des informations sur les consommateurs et de considérer l'âge des consommateurs, le sexe, etc., et de caractériser les classes de consommateurs par ces variables-là pour dire, eh bien, les individus de la classe 1 apprécient fortement les produits BO et MB et ce sont principalement des jeunes, des femmes, des gens qui travaillent, des gens qui, etc., etc. C'est cette information-là qui va être la plus intéressante plutôt que d'avoir juste les produits qui sont appréciés. Il faut qu'on puisse relier ça à des consommateurs, à des types de consommateurs. C'est important si vous recueillez de l'information sur les préférences d'avoir aussi l'information sur les consommateurs. Est-ce qu'ils ont l'habitude de manger ou de boire le produit? Comment est-ce qu'ils le servent? Etc. Et donc pour les classes, eh bien je peux aussi projeter la note moyenne par classe. Donc je calcule pour chaque produit la note moyenne des individus de la classe, des individus de la classe 1. Donc je fais ça pour chaque produit, donc ça me crée un vecteur de moyenne pour la classe 1, un vecteur de moyenne pour la classe 2, un vecteur de moyenne pour la classe 3. Et ces 3 variables, je peux les projeter sur le plan de l'ACP. Donc ce que je vois ici, c'est que j'ai constitué 3 classes, mais ces classes sont assez proches dans le plan. Classe 1 et 2 sont très proches, classe 3 est aussi assez proche. Elles sont toutes très liées à la première dimension, c'est vraiment parce qu'il y a des préférences assez homogènes parmi les consommateurs. Alors on va passer maintenant à la cartographie externe, donc où cette fois les préférences des consommateurs arrivent a posteriori, les différences entre produits sont construites par d'autres variables. Donc cartographie interne, c'est à partir des préférences qu'on construit les distances entre produits, on construit la carte des produits. Cartographie externe, on construit cette carte des produits à partir de données sensorielles ou de données physico-chimiques. Et les préférences, on les rajoute après. Donc le tableau qui est construit, c'est le même, mais cette fois en actif, on va mettre descripteurs sensoriels et physico-chimiques. Et la question, eh bien, c'est comment construire la carte des produits. Donc par une ACP, on l'a vu. Alors on va voir qu'on peut construire plusieurs types de cartographies externes. Et donc dans le tableau ici, ce que je fais, c'est que je calcule je récupère les composantes principales de l'ACP. Donc je fais l'ACP sur le tableau produits descripteurs sensoriels et je récupère les composantes principales, c'est-à-dire je récupère les coordonnées des produits sur l'axe 1, c'est ce que j'appelle F1, je récupère les coordonnées des produits sur l'axe 2, c'est ce que j'appelle F2. Ces 2 variables-là, ce sont juste les coordonnées des produits sur le plan factoriel. Et je vais voir comment relier préférences des consommateurs avec justement ces composantes principales qui sont un résumé des descripteurs sensoriels. Alors l'idée, ça va être d'essayer d'expliquer la préférence des consommateurs en fonction des composantes principales. Alors ça répond un peu au problème que j'évoquais tout à l'heure quand tu proposais de construire un modèle de régression en fonction des descripteurs sensoriels. Je disais que c'était peut-être difficile parce qu'on avait beaucoup de descripteurs sensoriels et trop de paramètres à estimer par rapport au nombre de produits. Eh bien là, en fait, je résume tous mes descripteurs sensoriels par seulement 2 composantes et donc ça va être plus facile cette fois de relier préférence des consommateurs à la description sensorielle, la description sensorielle ayant été résumée grâce à l'ACP. Alors l'idée, ça va être bien de travailler consommateur par consommateur. Pour chaque consommateur, je vais construire un modèle de régression. Alors pourquoi je fais ça? Parce qu'il y a toujours l'idée que tous les consommateurs n'ont pas la même préférence, et donc travailler sur la moyenne des notes des consommateurs, c'est pas forcément informatif. Donc on va travailler consommateur par consommateur. Et je vais construire un modèle de régression de la préférence. Donc ma variable Y, c'est la préférence d'un consommateur. Je vais l'expliquer en fonction des 2 composantes principales. Alors je peux utiliser un modèle tout simple: le consommateur j, c'est— il met comme note une note moyenne m plus a fois la coordonnée du produit sur le l'axe des abscisses, plus b fois la coordonnée des produits sur l'axe des ordonnées. Et on voit que quand j'écris ce modèle-là, je suis en train de relier la préférence des consommateurs à la position des produits sur le plan puisque j'utilise f1 et f2 qui permettent d'avoir l'information sur la position des produits sur le plan. Donc je vais bien relier préférence des consommateurs à la position des produits et donc à la description sensorielle. Alors si je construis un modèle avec juste la moyenne plus a fois la coordonnée sur le facteur 1 plus b fois la coordonnée sur le facteur 2, ça revient à faire une ACP et à projeter en supplémentaire les appréciations. Donc là je suis passé par un modèle, mais en fait ça revient juste à faire l'ACP. Je suis pas passé par un modèle juste pour le plaisir de passer par un modèle, c'est parce qu'après On va modifier un petit peu ce modèle, le compléter, l'enrichir, mais dans le cadre de ce modèle simple, projeter en supplémentaire les appréciations, ça répond à la question de faire la régression en fonction de la position des produits. Donc vous avez en haut le graphe des produits. Alors c'est pas exactement le même graphe que tout à l'heure puisque là c'est sur les descriptions sensorielles. Donc vous voyez à droite, vous avez les produits qui sont acides, amers, avec une forte intensité d'attaque, et à gauche les produits qui sont avec un arôme de banane, sucrés, pulpeux, épais. Et donc les appréciations sont toujours vers ces produits qui sont avec une forte saveur sucrée, un arôme de banane, et sont du côté opposé des descripteurs d'acidité et d'amertume. Donc on voit ici clairement que les consommateurs apprécient surtout les produits sucrés, bananes, et rejettent les produits acides et amers. Donc ça, cette ACP est intéressante. Maintenant, la critique qu'on peut faire, c'est que le modèle que j'ai construit, je dis, je relie la préférence des consommateurs en fonction de la coordonnée des produits sur l'axe. Et si le a est positif, Ça signifie que plus le produit aura une coordonnée positive et élevée sur l'axe 1, plus la préférence du consommateur sera élevée. Et donc on aura envie d'avoir le produit le plus extrême possible. Le problème, c'est que ça se passe pas vraiment comme ça dans les préférences. Les préférences sont pas forcément linéaires. Donc je vous donne un exemple avec un petit graphe qui montre en ordonnée la préférence, en abscisse une note de saveur sucrée. Si les produits sont pas assez sucrés, ils sont pas très appréciés. Et puis plus on met de sucre, plus on apprécie. Mais il y a un moment, on n'a pas envie de boire du sucre. Donc si on met trop de sucre, on commence à moins apprécier. Donc il y a un seuil optimal de sucre. S'il n'y en a pas assez, on n'apprécie pas. Plus on en met, Un peu plus, on apprécie plus, et puis après on commence à en mettre de trop et on apprécie moins. Et avec le modèle que j'ai construit moi, je veux quelque chose de linéaire. Je peux pas l'avoir. Je peux pas modéliser une préférence qui est non linéaire par rapport à la saveur sucrée. Et donc plutôt que de construire un modèle de régression multiple simple, qu'on peut appeler modèle vectoriel, qui revient à faire l'ACP, eh bien je peux prendre un modèle qui va utiliser des termes quadratiques. Donc j'utilise les coordonnées F1 au carré, coordonnées F2 au carré et éventuellement une interaction entre F1 et F2. Donc là j'ai un modèle plus complet qui va permettre de prendre en compte des non-linéarités et donc l'appréciation ne sera pas pour les produits les plus extrêmes, soit avec des coordonnées positives, soit avec des coordonnées négatives, on pourra avoir un produit qui est très apprécié et qui se retrouve à l'intérieur du graphe. Alors très bien, je vais pouvoir construire un modèle de régression pour chaque consommateur. Je me retrouve avec, si j'ai 100 consommateurs, 100 modèles de régression qui sont construits. Alors qu'est-ce que je peux faire de cette information? C'est pas très simple de synthétiser toute cette information. Alors une idée qui était proposée par Marc Danzard, c'était de synthétiser les préférences des consommateurs de la façon suivante: on prend le plan de l'ACP et on le discrétise en prenant plein de points sur ce plan. Donc on fait une grille sur le plan de l'ACP. Et pour un consommateur, on va prédire la préférence du consommateur en chaque point de ce plan. Donc j'avais quelques produits, une dizaine de produits, À partir de ces 10 produits, je construis un modèle de régression. Une fois que j'ai un modèle de régression, je peux prédire la préférence en tout point. J'ai l'information, je peux prédire en tout point. Donc pour chaque consommateur, je prédis en chaque point du plan sa préférence. Et après, je pourrais cumuler les préférences des consommateurs. Alors en fait, si on cumule les préférences des consommateurs, les préférences prédites des consommateurs, Ça marche pas très bien. Donc l'idée, ça a été de se dire, pour chaque consommateur, je vais couper le plan en 2 parties: les parties du plan qui sont avec une appréciation élevée et les parties du plan avec une appréciation faible. Alors le seuil appréciation élevée, appréciation faible, l'idée ça a été de prendre la moyenne des notes mises par le consommateur. Donc en fait, Pour chaque consommateur, je construis un modèle de régression, je prédis en chaque point du plan, et en chaque point du plan, je regarde si la prédiction est supérieure à la moyenne des notes mises par le consommateur. Si c'est supérieur à la moyenne des notes, je colorie le point en rouge, d'accord, par exemple. Et si c'est inférieur, je colorie pas le point. Donc je vais avoir pour chaque consommateur une grille avec certains points qui sont en rouge, ce qui matérialise une zone de préférence, et des points qui ne sont pas coloriés, donc une zone qui n'est pas très appréciée par le consommateur. Et donc pour chacun des consommateurs, j'ai ce type de grille, et après, eh bien, je vais cumuler ces grilles, je vais sommer ces grilles pour définir la zone de préférence. Pour sommer, c'est simple, en chaque point du plan, je vais comptabiliser le nombre de fois ou c'était dans une zone de préférence. Si je reviens sur le transparent précédent, j'avais 2 cartes ici, et si je cumule ces 2 cartes, eh bien là où les 2 cartes ont des points rouges, ça me met maintenant un point bleu, et puis sinon là où il y a un point rouge, ça veut dire que c'est une zone de préférence pour une des 2 cartes seulement, et là où il n'y a pas de point, c'est pas une zone d'appréciation pour les 2 consommateurs. Et donc on va faire ça en sommant sur l'ensemble des consommateurs. Et donc en chaque point du plan, on aura le nombre de consommateurs pour qui c'est dans sa zone de préférence. L'autre chose que je peux faire, c'est pour chaque consommateur, j'ai construit une surface de préférence, d'accord? J'ai construit un modèle de régression, et dans ce modèle de régression, bien j'ai calculé la préférence en chaque point du plan. Je peux chercher l'optimum pour chaque consommateur, c'est-à-dire le produit qui serait préféré par le consommateur. J'ai presque envie de dire le produit idéal, mais il y a une autre définition maintenant sensorielle sur le produit idéal, produit idéal pouvant être en dehors de la zone de préférence. Mais là, c'est donc le produit le plus apprécié dans la zone de l'espace produit qu'on a travaillé. Alors voici la carte des préférences. Donc en rouge, c'est une zone de préférence forte, et en bleu, une zone plutôt de rejet. Alors bien entendu, on a toujours un peu la même information. Le modèle de régression est construit à partir des 10-12 produits qu'on a. Mais après, tu as construit un modèle de régression, et après tu peux prédire la préférence pour n'importe quelle coordonnée F1 et n'importe quelle coordonnée F2. Donc en chaque point du plan. Alors en chaque point du plan, sauf qu'il y a une infinité de points dans le plan. Donc nous, c'est pour ça qu'on a construit une grille en balayant cette grille pour avoir une grille assez fine et une prévision à peu près à tous les endroits. Mais l'idée, c'est d'utiliser un modèle de prévision justement pour essayer de comprendre la préférence des consommateurs partout dans le plan et pas seulement là où il y a des produits. D'accord? Donc je disais qu'on retrouve un peu la même information avec les produits qui sont rejetés, qui sont les produits O, C, M, et puis les produits qui sont plus appréciés, qui sont des produits avec de la banane ou de la mangue. Vous voyez sur ce graphe qu'il y a des petites lignes de niveau. En fait, c'est exactement comme une carte topographique où on voit des petites montagnes de préférence qui apparaissent. Et vous avez ici une ligne de niveau avec 80, ce qui signifie que sur cette ligne, il y a 80% des consommateurs pour qui le point est dans sa zone de préférence. Donc il y a 80% des consommateurs pour lesquels les produits OBM, MB, BCM sont dans la zone de préférence. Donc c'est des produits qui sont très appréciés. Et ici, vous avez la zone la ligne de niveau avec 20% seulement des gens qui apprécient les produits qui sont par ici. C'est un produit qui est assez peu apprécié. Alors l'intérêt ici de la cartographie, c'est qu'on voit que c'est pas quand on va le plus à gauche avec des coordonnées très faibles sur le plan factoriel qu'on a les appréciations les plus importantes. On voit que le produit BMC ici, c'est pas le produit le plus apprécié, il n'est pas dans la zone de préférence. Et ça, c'est une information qu'on n'avait pas du tout avec le modèle vectoriel avec une flèche par consommateur. On avait l'impression que les produits à gauche étaient très appréciés et c'était impossible de savoir quels étaient les produits qui étaient plus appréciés et ceux qui étaient moins appréciés. Là, on voit que la zone de préférence s'arrête après BCM et l'autre produit est un peu moins apprécié. On prend bien en compte des non-linéarités dans l'appréciation. Donc il y a un intérêt à la cartographie même si on retrouve que ce sont ces 3 produits-là qui sont les plus appréciés. Et donc cette fonction carto va permettre de construire les cartes de préférences dans Sensominer. Alors ce que vous voyez aussi c'est des points noirs. Chaque point noir c'est le produit préféré par un consommateur. Le produit préféré, la prévision la plus élevée pour chacun des consommateurs. Alors pour construire ces cartes il faut qu'il y ait quand même pas mal de consommateurs parce que si vous n'avez que 20 consommateurs que vous superposez les cartes de préférence, vous allez avoir des cartes qui sont pas du tout continues, quoi, pas lisses. Donc il faut qu'il y ait quand même pas mal de consommateurs pour construire les cartes. Une autre fonction qui est disponible dans Sensominer, c'est CartoConsumer. Alors cette fonction permet dans un premier temps de faire une segmentation des consommateurs, donc on construit des classes de consommateurs, donc ici 3 classes de consommateurs. Et une fois qu'on a construit ces 3 classes de consommateurs, dans chaque classe on construit la carte de préférence. Alors la ligne verte correspond à une zone de préférence pour la classe verte et cette classe verte ça correspond à 41% des consommateurs. Donc 41% des consommateurs ont une zone de préférence qui est à l'intérieur de cette ligne verte. Alors la zone de préférence, je me rappelle plus comment elle est définie, il faut aller chercher dans l'aide. Je pense que c'est avec une zone de 80% de préférence ou plus. Donc vous avez une zone de préférence pour la classe verte qui contient 41% des individus. Il y a la classe rouge qui contient 22% des individus, qui a une zone de préférence un peu plus grande. Et la classe noire qui contient le reste, donc 37% des individus. Et vous voyez que pour ces 3 classes, il y a une zone de préférence qui est commune, qui reste là où il y a les produits OBM, BCM et MB. Alors, avantages de la cartographie des préférences: on voit bien les zones de préférence, il n'y a pas besoin d'avoir fait beaucoup de statistiques pour comprendre la carte. Alors que si on a un modèle compliqué, chercher les coefficients qui expliquent bien la préférence, c'est beaucoup plus difficile à lire. Là, la carte restitue bien les résultats. Donc ça, c'est un avantage. Je vous ai déjà signalé cet avantage-là. Il faut toujours restituer les résultats d'une façon qui soit compréhensible par le maximum de personnes. La cartographie des préférences a cet avantage-là. Alors, les désavantages que je vois sont assez nombreux. La stabilité des jugements hédoniques est peu évidente. Un même individu, vous lui faites déguster les produits un jour, il va mettre des notes d'appréciation. Le lendemain, il va mettre des notes très différentes. Il y a aussi le problème du premier produit qui est dégusté. Le premier produit qui est dégusté, souvent, il est plus apprécié que les suivants. Là, pour les cocktails, si vous avez un cocktail avec du citron, le premier vous vous dites bon c'est pas mauvais, mais au bout du 5e ou 6e avec du citron, vous en pouvez plus de l'amertume et de l'acidité et vous mettez une note très faible. Donc il y a un effet du premier produit qui est important. Et bien là, on construit le modèle par consommateur. Donc le premier produit, s'il a tendance à avoir une note plus élevée que les autres, Eh bien, ça apparaît ça dans le modèle, ça change la note, ça va donc changer les estimations des coefficients du modèle et changer les prévisions et donc la surface de réponse. Donc une stabilité qui est peu évidente, ça c'est un désavantage. C'est clair que les jugements individuels sont pas stables, mais en fait, comme on a une centaine de consommateurs, on s'aperçoit que les cartes finalement qu'on obtient sont relativement stables. Chaque individu dit des choses un peu différentes d'une fois sur l'autre, mais dans l'ensemble, le jury va ressortir les mêmes tendances si on fait 2 séances de dégustation. Alors, autre des avantages, c'est que quand on fait l'ACP sur la description sensorielle, on a récupéré les axes 1 et 2 de l'ACP pour relier aux préférences et c'est pas forcément les axes 1 et 2 qui sont les plus liés aux préférences. Ça peut être par exemple l'axe 3 qui est très lié aux préférences. Et dans ce cas-là, évidemment, si l'axe 3 est très lié aux préférences, on n'arrivera pas avec la carte à comprendre les préférences, puisque si la préférence est très liée à l'axe 3, si les préférences sont très liées à l'axe 3, par construction c'est qu'elles sont, c'est que les préférences sont indépendantes aux axes 1 et 2, et donc on va construire une carte, une carte des produits qui sera indépendante des préférences, et donc il n'y aura aucun intérêt à la carte. Donc là, dans ce cas-là, ça signifie qu'il ne faut pas forcément utiliser les axes 1 et 2, mais on peut construire une carte avec les axes 1-3 ou 2-3. Et l'autre inconvénient, alors là qui est à mon avis vraiment le plus important, c'est que le nombre de produits est assez faible. Quand on fait une dégustation sensorielle. Donc on a 8, 10, 12 produits qu'on va évaluer et quand on construit le modèle de régression, on a finalement pas mal de paramètres à estimer. On a la moyenne m plus le coefficient pour les coordonnées sur l'axe 1, les coordonnées sur l'axe 2, les coordonnées sur l'axe 1 élevées au carré, sur l'axe 2 élevées au carré et l'interaction 1-2. Donc on a 6 paramètres à estimer sachant qu'on a 8, 10, 12 données. Donc évidemment, estimer 6 paramètres à partir de 10, 12 données, on a une forte instabilité du modèle. Et donc ça, ça c'est vraiment embêtant. Ça veut dire que si le modèle est très instable, on peut avoir une surface de réponse et puis un petit écart dans une des notes et on aurait une surface de réponse très différente. C'est ça que ça signifie, une instabilité du modèle. Donc ça, c'est là encore, c'est un désavantage. Alors il y a des façons de faire pour garder une estimation des effets quadratiques tout en estimant un petit peu moins de paramètres. C'est ce qui est programmé dans la fonction, mais l'idée c'est quand même d'avoir un modèle de régression prenant en compte des termes quadratiques. Est-ce que vous avez des questions là sur la cartographie des préférences?
More from Yamossoun











Algorithme de calcule de la racine carrée par dichotomie #dichotomy #squareroot #algorithm