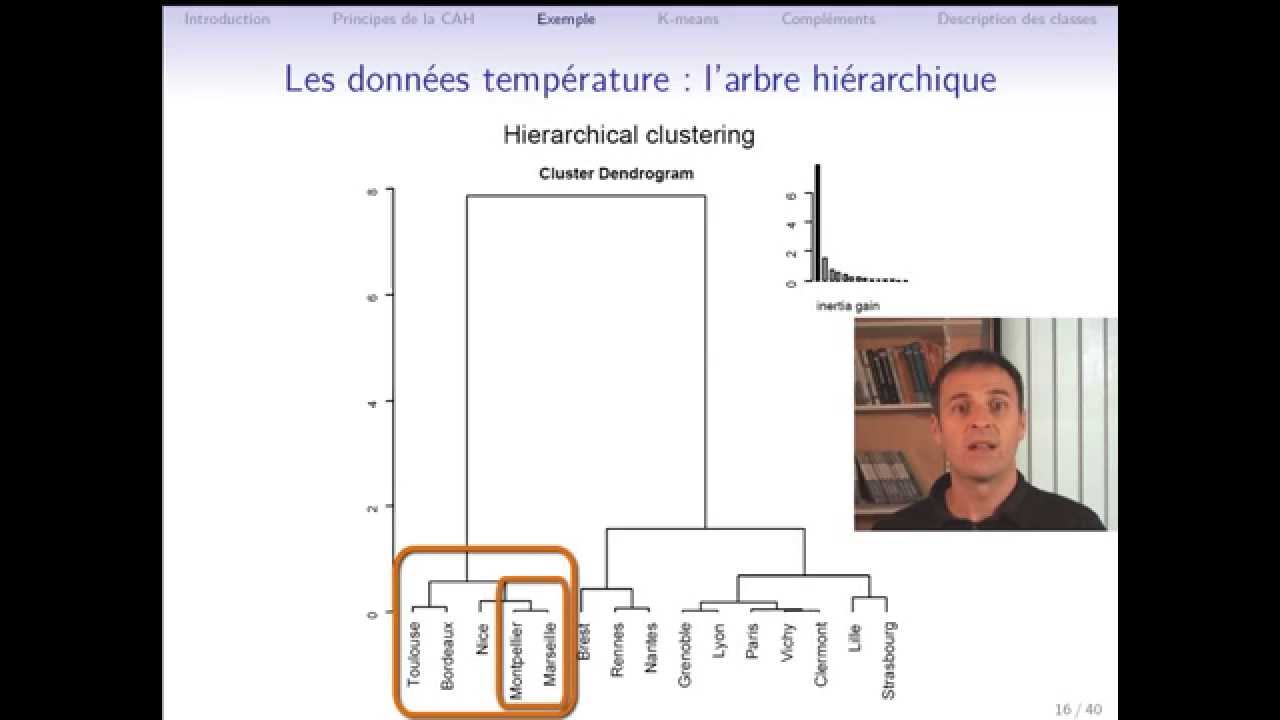
Dans cette vidéo, le conférencier applique la classification ascendante hiérarchique (CAH) à un jeu de données contenant les températures mensuelles moyennes de 15 villes françaises (12 variables) afin d’illustrer le processus de construction d’un arbre hiérarchique, l’interprétation du dendrogramme et du diagramme des pertes d’inertie, et la détermination du nombre optimal de classes. Il décrit le jeu de données, explique l’utilisation de la distance euclidienne et du critère de Ward, analyse les regroupements observés (ex. Rennes‑Nantes, groupe sud‑ouest), détaille le calcul des pertes d’inertie inter et leur somme totale (12, correspondant à la variance totale des variables standardisées). Il montre comment le pourcentage d’inertie inter récupéré (66 % pour 2 classes, 79 % pour 3 classes) se compare aux pourcentages d’explication du premier et du deuxième axe de l’ACP. Le conférencier discute ensuite des critères pratiques pour choisir le nombre de classes : longueurs de branches dans l’arbre, sauts d’inertie, taille de l’échantillon, hétérogénéité des individus et, surtout, l’interprétabilité des classes. Il conclut en annonçant la prochaine vidéo qui présentera une méthode de partitionnement une fois le nombre de classes fixé.
Chapters
Nous avons vu la dernière fois comment construire un arbre hiérarchique. Nous allons cette fois l'appliquer sur un exemple. Alors prenons un exemple pour illustrer la classification. C'est un exemple que nous avons déjà utilisé dans une vidéo sur l'ACP. Voici le tableau de données: on a 15 villes de France en lignes et 12 variables qui correspondent aux températures mensuelles moyennes mesurées sur 30 ans. On a de plus 2 variables, la latitude et la longitude, qui ne vont pas être utilisées pour construire les classes mais qui pourront servir éventuellement lors de la caractérisation des classes. On va donc construire la classification sur la base des données de températures uniquement. En construisant une classification, on va chercher à regrouper des villes qui ont des profils météo similaires et dans une 2ème étape on cherchera à caractériser les différents groupes de villes. Voici l'arbre hiérarchique construit avec la distance euclidienne et le critère de Ward. On voit par exemple que les villes de Rennes et Nantes ont des profils météo très proches. Les températures de ces 2 villes se ressemblent tous les mois de l'année. On voit également un groupe Toulouse, Bordeaux, Nice, Montpellier, Marseille assez homogène. Plus dans le détail, on voit que Montpellier et Marseille dans ce groupe sont les plus proches. On peut voir ainsi les proximités entre villes et entre groupes de villes. Dans le diagramme en haut à droite, on voit l'évolution de l'inertie pour différentes partitions. Examinons ce diagramme de plus près. Ce diagramme montre les pertes d'inertie inter lors d'un regroupement de 2 classes. Plus précisément, il donne la perte d'inertie lors du passage de 15 classes en 14 classes, de 14 classes en 13 classes, etc. et de 2 classes en 1 classe. Si on somme les pertes d'inertie, on trouve la valeur de 12. 12 correspond à la somme des variances des variables du jeu de données car ici on a 12 variables et les variables ont été centrées-réduites. Donc en faisant la somme des pertes d'inertie inter, on retrouve bien l'inertie totale qui est égale à 12. Examinons maintenant l'information apportée par chaque barre de ce diagramme. La première barre ici en bas, la plus grande, donne la perte d'inertie inter lorsqu'on regroupe 2 classes d'individus en une seule classe. La perte d'inertie inter est de 7.88, ce qui est très important. Cela veut dire que ce regroupement agrège des individus très différents. On n'a donc pas envie de regrouper ces 2 classes. La barre rouge montre la perte d'inertie lorsqu'on passe de 3 classes en 2 classes. Cette perte d'inertie inter est de 1.56. Cette quantité est relativement importante également et on peut se demander s'il faut ou non faire ce regroupement pour passer de 3 classes à 2 classes. Et le diagramme montre toutes les pertes d'inertie inter. Les passages de 15 à 14 classes, 14 à 13, etc., du début conduisent à de très faibles pertes d'inertie inter et donc les regroupements sont naturels. La question est alors de savoir jusqu'à quand peut-on regrouper les classes et quand faut-il s'arrêter de regrouper. Cette question peut simplement se traduire par combien de classes faut-il faire? Dans notre exemple, combien doit-on faire de groupes? Faut-il en faire 2, 3, 4? On peut se poser la question. Si on choisit un niveau de coupure ici en orange, on a un découpage en 2 groupes. L'inertie inter, on l'a vu, vaut 7.88 et l'inertie totale 12, ce qui donne un ratio inertie inter sur inertie totale égal à 66%. C'est-à-dire qu'en séparant les villes en 2 groupes, les villes en rouge, Toulouse, Bordeaux, Nice, Montpellier, Marseille, et les villes en bleu, Brest, Rennes, Nantes, Grenoble, etc. jusqu'à Strasbourg, Avec cette séparation des villes en 2 groupes, on récupère 66% de l'information qui est contenue dans le tableau de données. Ce découpage en 2 classes résume assez grossièrement les ressemblances entre individus du tableau de données. Alors à quoi comparer ce pourcentage de 66%? En fait, on peut comparer ces 66% au pourcentage de variabilité expliqué par le premier axe de l'ACP. Le premier axe de l'ACP récupère environ 80% de l'information du jeu de données. Avec la classification, en séparant juste les villes rouges des villes bleues, on récupère 66% d'information, donc un peu moins d'information qu'avec le premier axe de l'ACP. En effet, le premier axe de l'ACP donne une information plus fine. Il sépare Nice de Toulouse ou Bordeaux en donnant une coordonnée plus extrême à Nice. De même, Lille est plus extrême que Nantes. Avec la classification, ces 2 villes sont dans la même classe. Et avec les regroupements on récupère 66% d'information. Donc on a un résumé plus grossier avec la classification qu'avec l'ACP. Alors maintenant si on sépare les villes froides Brest, Rennes, Nantes, Grenoble, Lyon jusqu'à Strasbourg en 2 groupes, on est en train de faire une classification en 3 groupes. Le passage en 3 classes permet de ne pas perdre l'inertie perdue lors du passage de 2 classes à 3 classes. On récupère une inertie inter de 1.56 soit 13% de l'information. Et ces 13%, je peux les comparer au 2ème axe de l'ACP ici puisque effectivement le 2ème axe de l'ACP sépare les villes froides en 2 groupes: les villes en bleu et les villes en vert. Donc avec une classification en 3 classes, on récupère 66+ 13, c'est-à-dire 79% de la variabilité des données. En constituant 3 classes, on récupère 79% de la variabilité totale. Et avec l'ACP et 2 axes, on récupère environ 99% de l'information. Le choix du nombre de classes est important car construire une partition avec trop peu de classes risque de conduire à des classes qui ne sont pas homogènes et au contraire construire une partition avec trop de classes risque de conduire à des classes qui ne se différencient pas suffisamment. Se pose alors la question cruciale du choix du nombre de classes. On peut déterminer un nombre de classes à partir de l'arbre. On aura tendance à couper l'arbre là où les branches sont assez longues. On peut aussi s'appuyer sur le diagramme des indices de niveau et choisir d'arrêter de regrouper des classes quand le saut est faible, ce qui indique qu'on récupère assez peu d'information et qu'il n'est plus vraiment utile de regrouper certaines classes. Le nombre de classes dépend également de l'enquête et du nombre d'individus. Si on a une enquête avec des milliers d'individus, il sera intéressant de constituer 5, 6 voire une dizaine de classes. Si maintenant on a beaucoup moins d'individus, on préfère avoir moins de classes. De même, si on classe des individus statistiques très différents, on va préférer constituer plus de classes. Un critère ultime lorsqu'on construit des classes est l'interprétabilité des classes. Peut-on comprendre et décrire les classes? Il est inutile de séparer une classe en 2 si on ne peut pas comprendre les 2 classes qu'on est en train de constituer. Dans cet exemple, nous avons vu que la classification ascendante hiérarchique suggère un nombre de classes. Nous verrons dans la vidéo suivante comment construire une méthode de partitionnement quand le nombre de classes est déterminé.