Séq 2 - Modèles d'analyse de variance en sensométrie
This content was created by Yamossoun Ayemou Bernard. This content was uploaded by Yamossoun Ayemou Bernard. This is a French-language lecture (YouTube video titled "Séq 2 - Modèles d'analyse de variance en sensométrie", created 2013-02-20) presenting ANOVA models in sensometrics. A single lecturer explains the ANOVA model notation (y_ijk), main effects (product, judge, session), interactions (product-judge, product-session, judge-session), the residual term and usual assumptions (normality, homoscedasticity, independence). The lecture covers fixed vs. random effects (notably judges), how that choice changes the F-test (comparing product variance to residual or to the product-judge interaction), interpretation of effects and interactions for sensory panels, and subsequent contrast tests (Student t) for identifying which products differ. Context: classroom / tutorial presentation for sensory analysis students; speaker addresses students rather than a multi‑speaker dialogue.
Chapters
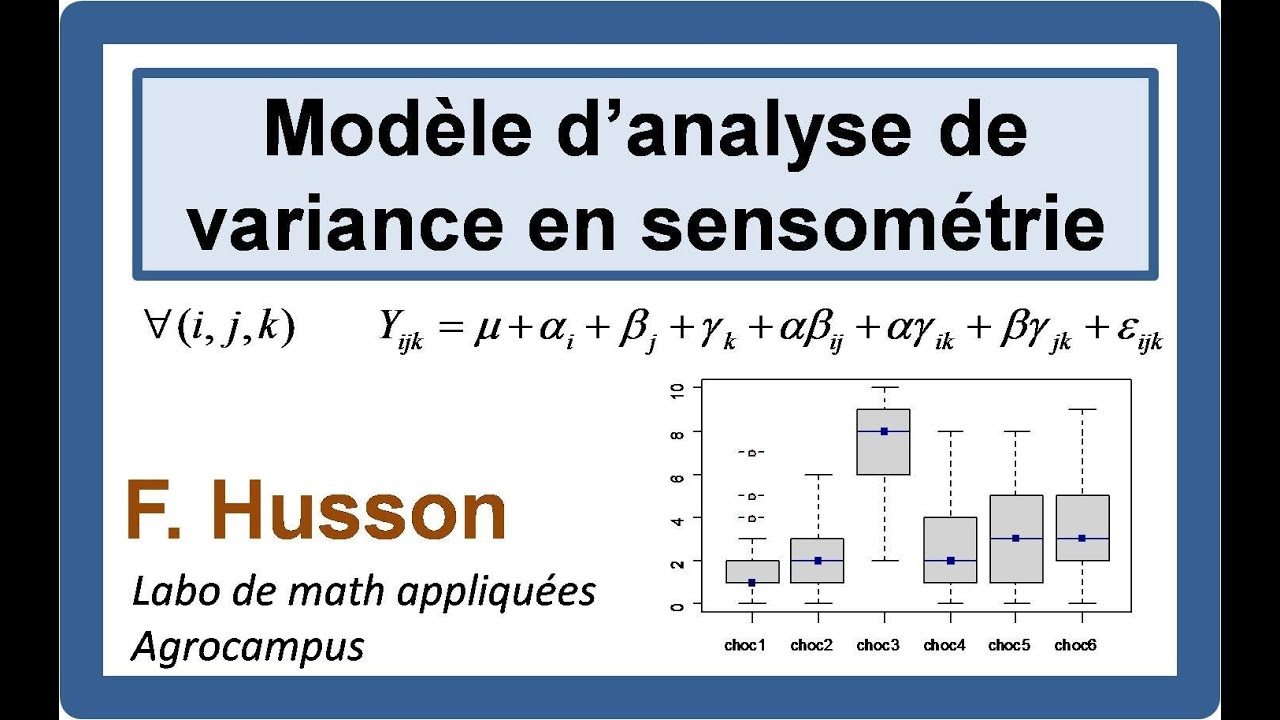
Et là on va vouloir savoir si les différences qu'on a vues sont significatives ou pas. Donc là pour ça, on va faire appel à des notions que vous avez déjà vues sur l'analyse de variance, et on va construire des modèles d'analyse de variance. Alors c'est des transparents qui sont plutôt des rappels sur l'analyse de variance. Donc je vous redonne l'écriture du modèle. Yijk, la note pour la saveur sucrée par exemple, la note du chocolat i évalué par le juge j lors de la séance k. D'accord? Donc les indices ijk correspondent au produit, au juge et à la séance. Donc yijk, c'est la note mise par le juge j sur le produit i à la séance k. Et ça, je dis que c'est égal à un effet moyen mu, donc en gros une note moyenne mu qui est valable pour tous les juges, tous les produits, à toutes les séances. Ensuite, il y a un coefficient alpha i ici qui correspond à l'effet du chocolat i. Donc le fait que le juge soit en train de déguster le chocolat i, eh bien, on va avoir tendance à mettre, il va avoir tendance à mettre des notes supérieur à la moyenne si le coefficient est positif, ou inférieur à la moyenne si le coefficient est négatif. Donc l'effet alpha_i signifie que ce chocolat est différent de la moyenne. Si alpha_i est égal à 0, il est noté, évalué comme la moyenne de tous les chocolats, et s'il est positif, il est avec une plus forte saveur sucrée, s'il est négatif, avec une plus faible saveur sucrée. Le coefficient bêta_j, ça c'est l'effet du juge. Donc ça c'est l'effet du juge j. Le juge j a peut-être tendance à mettre des notes supérieures aux autres juges. Ça c'est très fréquent. On a beau entraîner les juges, il y en a toujours qui ont tendance à utiliser l'échelle de notation de façon un peu différente et à mettre des notes plutôt élevées. Donc à noter par exemple entre 4 et 10. Quand d'autres vont noter plutôt entre 2 et 8. Donc ça, c'est presque toujours le cas. Il y a toujours des différences d'utilisation de l'échelle de notes. Mais ils peuvent voir les produits exactement de la même façon, mais c'est juste une translation dans l'utilisation des notes. Ensuite, il y a le coefficient gamma_k. Donc ça, c'est l'effet de la séance k. Donc c'est juste s'il y a une différence de notes à la séance k. Alors là, ça veut dire tous produits confondus, tous juges confondus, les notes sont un peu plus élevées à la séance K que pour la moyenne. Normalement, on s'attend à ce qu'il n'y ait pas trop d'effet de la séance K. Il peut y en avoir, par exemple, si à une séance il fait très chaud et les chocolats sont un peu plus fondus. Eh bien, dans ce cas-là, ils seront un peu plus fondants. Donc il y aura des notes plus élevées pour le fondant. Ça, ce serait lié à quel que soit le chocolat, ils seraient tous un peu plus fondants et tous les juges les percevraient comme un peu plus fondants. Ça, ce serait un effet de la séance K. Alors normalement, ça, on devrait le maîtriser parce qu'il faut donner les chocolats à la même température. Mais si jamais c'est pas bien maîtrisé, il vaut mieux qu'on mette cet effet-là dans le modèle. Le fait de le mettre dans le modèle fait qu'on va éviter de confondre l'effet de la séance K avec un effet produit. Donc ça, ce sont les effets principaux: produit, juge, séance. Ensuite, il y a une interaction alpha bêta ij qui correspond à l'interaction entre le produit i et le juge j. Donc l'interaction produit i juge j, ça signifie que le juge j évalue le produit de façon différente par rapport aux autres juges. Alors s'il n'y a pas d'effet de l'interaction, tous les juges évaluent le produit i de la même façon. Ils ont tous tendance à lui mettre une note plus élevée par exemple si le alpha i est positif. Mais s'il y a un coefficient alpha bêta ij qui est différent de 0, ça veut dire que le juge j évalue un peu différemment, il met une note encore plus élevée que les autres ou moins élevée que les autres. Donc là c'est la façon de voir du produit par le juge j qui est différente par rapport à l'ensemble des juges. Il y a une autre interaction qui est l'interaction alpha gamma ik. Donc alpha gamma ik c'est l'interaction entre l'effet produit et l'effet séance. Est-ce que les produits sont perçus de la même façon à toutes les séances? Ça va permettre de répondre à cette question. Donc s'il n'y a pas d'interaction, si tous les alpha gamma ik sont égaux à zéro, ça signifie que les produits sont vus exactement de la même façon à chaque séance. S'il y a un alpha gamma ik qui est différent de zéro, ça signifie que ce produit-là est perçu de façon un peu différente à la séance k. Il a une note supérieure à la séance k ou inférieure à la séance k par rapport aux autres séances. Donc là, ça veut dire que le jury n'est pas complètement répétable d'une séance à l'autre. Certaines fois, il va décrire le produit d'une certaine façon, et puis à la séance suivante, à la séance k, il va décrire le produit de façon un peu différente. Donc ça, ce serait une interaction qui est un peu problématique. Ça veut dire que le jury n'est pas parfaitement répétable, son évaluation n'est pas stable dans le temps, d'une séance à l'autre. Et puis la dernière interaction, bêta gamma jk, c'est une interaction entre l'effet juge et l'effet séance. Donc là, ça veut dire qu'il y a certains juges qui ne vont pas utiliser l'échelle de notation exactement de la même façon séance 1 et séance 2. Par exemple, un juge va avoir tendance à mettre des notes utiliser l'échelle de notes plutôt basse à la séance 1 et plutôt élevée à la séance 2. Donc la séance 1, il note les produits de 2 à 8 et à la séance 2 de 4 à 10. Donc ça c'est une interaction juge-séance. Donc on a beaucoup de choses pour essayer de décrire la note et puis bien comme d'habitude il y a des choses qu'on n'arrive pas à expliquer donc ça c'est la résiduelle epsilon ijk. Alors sur cette résiduelle justement, on est amené à faire des hypothèses. Donc les hypothèses classiques qu'on retrouve en régression, qu'on retrouve en analyse de variance, à savoir que les résidus suivent une loi normale, sont tous de même variance sigma carré et ils sont indépendants 2 à 2. Alors pourquoi on fait ces hypothèses-là? Parce que si on fait ces hypothèses-là, on sait construire les tests statistiques derrière. Alors, est-ce que ces hypothèses-là sont fortes? Elles sont assez fortes, mais elles sont le plus souvent vérifiées quand on fait les dégustations sensorielles. Notamment, elles sont vérifiées parce qu'on a des box et les jugements sont indépendants. Si les gens étaient en train de discuter et puis après de mettre des notes sur les produits, eh bien là, il n'y aurait plus des notes qui seraient indépendantes. Alors, quels sont les effets D'accord, dans tous les effets qu'on a vus, quels sont les effets qui sont importants à regarder? Eh bien, l'effet produit est très important à regarder. Est-ce qu'il y a un effet produit sur la note? Donc est-ce que les alpha_i sont tous égaux à 0 ou est-ce qu'il y en a au moins un qui est différent de 0? Ça, c'est une question cruciale quand on veut caractériser les produits. Si je veux caractériser les produits, je veux trouver des différences entre les produits. Donc je veux qu'il y ait un effet produit significatif. Donc en tout cas cet effet-là m'intéresse et j'ai envie de l'étudier. L'effet juge, donc là ce que je vous ai dit pour l'effet juge, c'est juste une utilisation de l'échelle de notation qui est un peu différente d'un juge à l'autre. S'ils décrivent les produits exactement de la même façon mais juste en translatant un petit peu les notes, d'accord, certains qui vont mettre pour le produit 1 par exemple il met une note de 2, le produit 2 une note de 4 et le produit 3 une note de 6, et qu'un autre met les notes 4, 6, 8, il y a juste une translation de 2 points, mais c'est pas grave, ils ont la même vision des produits les uns par rapport aux autres. Ils ont comme vision que le produit 1 est moins sucré, le produit 3 est plus sucré. Donc finalement, dans une caractérisation des produits, c'est pas très grave qu'il y ait un effet juge. Alors c'est pas très grave qu'il y ait un effet juge, mais c'est important quand même de le mettre dans le modèle. Alors pourquoi est-ce que je suis en train de vous dire l'effet produit est très important à mettre dans le modèle, donc je le mets dans le modèle, l'effet juge il n'est pas important à regarder mais je vais le mettre dans le modèle? Est-ce qu'il y a un paradoxe là entre dire c'est quelque chose qui m'intéresse pas, je vais pas discuter ça, mais je veux le mettre dans le modèle? Alors pas avec l'effet produit. La confusion effet juge, effet produit, c'est uniquement lié au plan d'expérience. D'accord? Si dans le plan d'expérience tous les juges n'évaluent pas tous les produits, là il y a une confusion. Mais après, l'effet juge ne se retrouve pas confondu avec l'effet produit. Voilà, l'effet juge, il est dans la résiduelle. Et donc il va gonfler fortement la résiduelle. Et vous vous rappelez que les tests qui sont faits, voir s'il y a un effet produit, on va comparer à la résiduelle. Et si on gonfle la résiduelle par l'effet juge, l'effet juge risque de masquer l'effet produit. C'est pas de se confondre avec l'effet produit mais de le masquer. Il y aura de telles différences de notes liées à l'effet juge qui se retrouvent dans la résiduelle que les petites différences de notes qu'il y a entre produits, on va pas réussir à les voir. Donc pour bien voir les différences entre produits, il faut absolument mettre l'effet juge dans le modèle. Même si je ne le discute pas. Alors l'effet séance, c'est exactement le même raisonnement. Qu'il y ait des différences de notation, tous juges, tous produits confondus, entre la séance 1 et la séance 2, c'est pas très grave si les produits sont perçus de la même façon en séance 1 et séance 2. Donc là encore, je le mets dans le modèle au cas où il y a un effet de la séance, mais je vais pas vraiment discuter cet effet séance. Donc pour les effets principaux, je vais finalement m'intéresser qu'à l'effet produit. Pour les interactions, alors l'interaction produit-séance, donc produit-séance, ça répond à la question: est-ce que tous les produits sont perçus de la même façon à la séance 1 et à la séance 2? Quand il y a 2 séances, ou sinon, est-ce que les produits sont perçus de la même façon à toutes les séances? Donc ça, c'est une question qui est évidemment très importante. J'ai envie, moi, que les effets produits soient perçus de la même façon à toutes les séances. Ça voudra dire que mon jury décrit les produits d'une certaine façon à la première séance et décrit les produits de la même façon à la deuxième séance. Donc le jugement est stable d'une séance à l'autre et donc j'ai confiance dans ce jugement. Donc l'interaction produit-séance, je la mets dans le modèle, je la regarde. J'aimerais bien, moi, faire un test et ne pas voir d'interaction. Ça signifiera que le jury est bien répétable dans le temps. Donc là, pour l'interaction produit-séance, c'est l'ensemble du jury qui évalue les produits de la même façon d'une séance à l'autre. L'interaction produit-juge, donc produit-juge, je suis en train de regarder si tous les juges évaluent tous les produits de la même façon. Et ça, c'est à toutes les séances. En gros, je regarde la moyenne des notes des juges pour chaque produit et j'aimerais que la moyenne des notes de tous les juges soit la même pour chaque produit. Alors s'il y a une interaction produit-juge, ça voudra dire que tous les juges n'évaluent pas les produits de la même façon. Il y en a certains qui vont considérer qu'il y a une grande différence. Je vais faire un schéma plutôt. Donc s'il y a une interaction produit-juge, ça signifie qu'il y a certains juges qui vont surnoter certains produits ou sous-noter certains produits par rapport à l'ensemble des juges. Tous les juges n'évaluent pas exactement de la même façon. Donc ça, c'est problématique. Alors il y a 2 types d'interactions en fait. Si je fais un schéma avec les juges 1, 2 et 3 par exemple ici, et puis 2 produits, voici les lignes brisées correspondent au produit 1, Un point correspond à la note moyenne mise par le juge 1 pour le produit 1, note moyenne mise par le juge 2 pour le produit 1, et la note moyenne mise par le juge 3 pour le produit 1. Et puis je construis une ligne brisée entre ces différentes notes. Il n'y a pas d'interaction si les lignes brisées sont parallèles. Produit 1, produit 2, là il y a le produit 1 qui a des notes supérieures au produit 2, tous les juges voient que le produit 1 a des notes supérieures au produit 2, mais il n'y a pas d'interaction. Les lignes brisées sont parallèles. Et maintenant si les lignes brisées ne sont pas parallèles, il y a des interactions. Alors ici il y a une interaction qui pose problème parce que les juges ne décrivent pas les produits de la même façon. Le juge 3 considère que le produit 1 a des notes beaucoup plus faibles plus faibles que la moyenne, alors que le juge 2 considère que le juge 3 a des notes supérieures à la moyenne. Donc ils n'ont pas la même vision des produits et ça c'est un peu problématique. Alors pourquoi c'est un peu problématique? Parce que normalement quand les juges caractérisent les produits avec des descripteurs d'acidité, d'amertume, etc., les juges se sont entraînés, ce sont des juges entraînés, et ils sont entraînés sur les saveurs et normalement un produit qui a une faible saveur amère Tous les juges doivent percevoir que la saveur amère est faible. Normalement, il doit y avoir un consensus. Donc si on est dans ce genre de situation, il y a une interaction et cette interaction est vraiment problématique. Parce que, eh bien, quel juge évalue correctement et quel juge n'évalue pas correctement? Alors il y a un autre cas de figure où il y a des interactions. Donc je refais les lignes brisées, produit 1 et pour le produit 2. Donc là il y a une interaction aussi parce que l'écart de notation entre les 2 produits n'est pas le même d'un juge à l'autre. Le juge 3 donne une plus grande différence de note entre le produit 1 et le produit 2. Mais dans la description des produits, on a à peu près quand même la même information, à savoir que le produit 1 est moins sucré que le produit 2, c'est vrai quel que soit le juge, et il y a juste l'écart de notation qui est un petit peu différent d'un juge à l'autre. Donc finalement, quand on a des interactions, ce sera important d'aller voir dans quel cas de figure est-ce qu'on se retrouve. Est-ce qu'on est dans le cas de figure où il y a vraiment une notation différente des juges? Dans ce cas-là, ça voudrait dire qu'il faut peut-être que les juges se réentraînent sur la saveur qu'ils sont en train d'évaluer parce qu'ils ne sont pas d'accord. Ou l'autre cas de figure, finalement les 2 juges donnent à peu près la même évaluation des produits et en tout cas l'ordre des saveurs évaluées sont les mêmes pour tous les juges. Et alors la dernière interaction, juge-séance, ça signifie que les juges n'utilise pas l'échelle de notation de la même façon d'une séance à l'autre. Ça, c'est pas très grave si la vision des produits est la même mais juste avec une translation de l'échelle de notation. C'est pas très grave qu'un même juge n'utilise pas l'échelle de notation de la même façon à chaque séance. Donc cette interaction, je la mets dans le modèle pour l'enlever de la résiduelle, mais je vais pas la commenter. Donc au final, dans tous les effets et interactions que j'ai à regarder, je vais être intéressé par l'effet produit, l'interaction produit-séance et l'interaction produit-juge. Et les autres effets et autres interactions, je les mets dans le modèle mais je vais pas les commenter. Alors finalement, je suis intéressé par tout ce qui concerne l'effet produit, produit et les interactions avec produit. Ce qui est normal puisque je suis en train d'essayer de caractériser un ensemble de produits ou de caractériser des produits. Alors pour les modèles d'analyse de variance, quand vous avez eu le cours sur l'analyse de variance, on vous a pas dit, mais ce que vous aviez construit comme modèle, c'était des modèles à effets fixes. Alors on vous l'a pas dit parce que vous aviez vu que ce type de modèle, donc c'était pas nécessaire de vous indiquer que c'était des modèles à effets fixes. Mais il existe d'autres types de modèles en analyse de variance qui sont les modèles à effets aléatoires. En fait, les modèles à effets aléatoires, en pratique, on les voit très souvent, notamment en analyse sensorielle. Alors je vais vous dire un petit peu quelle est la différence entre ce qu'on appelle un effet fixe et ce qu'on appelle un effet aléatoire. Donc un effet fixe, c'est quand l'effet du facteur qui nous intéresse est lié directement aux modalités de ce facteur. Donc par exemple, l'effet juge Si je le considère comme fixe, ça veut dire que je m'intéresse à chaque modalité de ce facteur. Donc ça veut dire que je m'intéresse aux résultats spécifiques de chacun de ces juges. Ça veut dire que les juges que j'ai choisis, c'est ceux-là qui m'intéressent et pas d'autres. Donc j'ai fait l'analyse avec certains juges, une analyse sensorielle avec certains juges, et les résultats que je veux commenter, c'est uniquement par rapport à ces juges. Si l'effet juge, je le considère comme aléatoire, ça veut dire que l'effet du facteur juge, mais il est pas directement lié au juge que j'ai choisi. Mais finalement, j'ai choisi quelques juges et je veux que ces juges soient représentatifs de n'importe quel autre juge que j'aurais choisi, d'accord? Donc dans un cas, j'ai des juges et c'est sur ces juges-là que je fais l'analyse. Dans Dans l'autre cas, j'ai choisi des juges qui sont représentatifs de ce qu'auraient pu dire des juges. Donc les juges sont là comme représentants d'un ensemble beaucoup plus vaste de juges. Alors dans le cas où l'effet est aléatoire, on cherche à comprendre ce que disent les juges en général, d'accord, et pas seulement notre échantillon de juges, et pas seulement les juges choisis. Un effet juge en En général, il est aléatoire, quasiment tout le temps. On va le considérer comme fixe si on a des juges qui sont des très grands experts, par exemple, et on va vouloir comparer ce que disent ces très grands experts sur une expérimentation. Donc là, on peut s'intéresser aux résultats de chacun. Mais le plus souvent, les juges sont là comme représentants d'un ensemble plus vaste de juges. Alors, dans un cas, je dis je m'intéresse à ces juges bien particulier. Et dans l'autre cas, je dis, je m'intéresse à ces juges qui sont des représentants d'un ensemble plus vaste. Donc en fait, je suis en train de dire, je m'intéresse à un échantillon de juges et ce que je veux, c'est décrire ce qui se passe sur l'ensemble, sur une population de juges. Donc je suis dans un cadre d'inférence où j'ai vu ce qui se passait sur quelques juges et à partir de cette information sur quelques juges, je veux comprendre ce qui se passe sur un ensemble plus vaste. Donc pour l'effet juge aléatoire, j'ai quelques juges et je veux prendre une décision sur une population de juges. Et dans le cadre fixe, j'ai ma population de juges et je regarde directement ce qui se passe. Donc vous voyez que c'est pas tout à fait la même analyse qu'on va faire parce que dans un cas, comme on fait de l'inférence, on sera moins sûr de ce qu'on va dire parce que j'ai vu que quelques juges et avec ça je veux dire ce que je pourrais voir sur toute une population de juges. Cette inférence, on va voir comment elle se traduit dans les tests. Alors un transparent pour vous rappeler comment on construit le test de l'effet produit quand l'effet juge est fixe. Alors vous voyez dans ma phrase, je suis en train de dire comment on teste l'effet produit quand l'effet juge est fixe. Donc c'est en fait l'effet produit qui m'intéresse et selon la nature de l'effet juge, le test de l'effet produit sera pas le même. Les grandes étapes du test, donc le test de l'effet produit, H0, l'hypothèse que je conserve a priori, c'est il n'y a pas d'effet produit, ce qui va se traduire mathématiquement par tous les alpha i sont égaux à 0. Si tous les alpha i sont égaux à 0, j'ai pas du tout d'effet produit. Tous les produits ont des valeurs autour de l'effet moyen mu. Et puis l'hypothèse alternative, c'est: il y a un effet produit, il y a au moins un produit pour lequel les notes sont significativement différentes de la moyenne, des notes significativement supérieures à la moyenne ou significativement inférieures à la moyenne. Ça, ça va être alpha_i qui est significativement différent de 0. Alors comment on construit le test? Le test va consister à regarder la variabilité due à l'effet produit. Donc les notes bougent parce qu'on prend des produits différents. Donc ça c'est le numérateur, la variabilité de l'effet produit ici, que je compare à la variabilité résiduelle. Donc en fait, quand je veux savoir si la variabilité de l'effet produit est grande ou petite, comme comparaison j'utilise la variabilité résiduelle. Donc la variabilité résiduelle, c'est ce que je peux pas expliquer, la variabilité que je peux pas expliquer. Et ce que je me dis, c'est si la variabilité de l'effet produit est du même ordre de grandeur que la variabilité résiduelle, alors l'effet produit explique pas plus de choses que ce que j'arrive pas à expliquer. Et donc dans ce cas-là, je me dis bien il explique pas grand-chose. Et au contraire, si la variabilité de l'effet produit est bien supérieure à la variabilité résiduelle, eh bien là je vais tout de suite dire qu'il y a des différences entre produits qui sont importantes, sont significatives. Donc la statistique de test, c'est un F de Fisher qu'on va calculer ici. Donc F observé qui est variabilité produit sur la variabilité résiduelle. Et si l'hypothèse H0 est vérifiée, donc s'il n'y a pas d'effet produit, alors cette quantité suit une loi de Fisher. Et pour la loi de Fisher, eh bien il y a 2 degrés de liberté: degré de liberté du numérateur et degré de liberté du dénominateur. Donc degré de liberté de l'effet produit et degré de liberté de la résiduelle. D'accord, donc ça c'est du rappel, je vais assez vite. Je remets ce transparent pour que vous voyiez bien la différence entre le test quand on est avec l'effet juge fixe et le test quand l'effet juge est aléatoire. Donc maintenant l'effet juge est aléatoire, donc les hypothèses que je vais tester c'est exactement les mêmes. Ce qui m'intéresse, moi, c'est de répondre à la question: est-ce qu'il y a des différences entre les produits? Donc les hypothèses, je teste les mêmes. H0: il n'y a pas d'effet produit, donc tous les alpha_i sont égaux à 0. Et H1: il y a un effet produit, il y a au moins un alpha_i qui est différent de 0. Alors la statistique de test, c'est là que les différences apparaissent. Ce que je veux voir, moi, c'est s'il y a un effet produit qui est fort. Donc je suis obligé de regarder, je vais être obligé de m'intéresser à la variabilité de l'effet produit. Donc le numérateur va être exactement le même. C'est la variabilité du produit. Et cette variabilité du produit, je vais plus la comparer à la variabilité résiduelle, mais je vais la comparer à la variabilité de l'interaction produit-juge. Pourquoi comparer à la variabilité de l'interaction produit-juge? Parce que ce qu'on veut voir, c'est est-ce que les différences entre produits sont importantes par rapport aux différences de notation qu'il peut y avoir d'un juge à un autre. Juge à l'autre. S'il y a une interaction produit-juge, ça veut dire que les juges n'évaluent pas les produits exactement de la même façon, qu'il y a des écarts de notation. Et ce qu'on veut voir ici, c'est est-ce que ces écarts de notation sont plus petits que les différences qu'il peut y avoir entre les produits. Quand je fais le test par rapport à l'interaction produit-juge, je veux m'assurer que les différences de notes entre produits sont supérieures aux petites différences de notation qu'il peut y avoir entre les juges. Dans le test, je compare le numérateur est le même, c'est la variabilité expliquée par l'effet produit. Le dénominateur par contre change puisque ça va être l'interaction produit-juge plutôt que la résiduelle. Et l'interaction produit-juge, en général, explique plus de choses que la résiduelle. Dans le pire des cas, elle explique comme la résiduelle, elle n'explique rien. Puis si jamais il y a des différences de notation d'un juge à l'autre, ça peut être un peu plus grand que la résiduelle. Donc le dénominateur ici est généralement plus grand que, en espérance en tout cas, il est plus grand que le dénominateur quand on utilise la résiduelle. Et donc comme le dénominateur est plus grand, eh bien le F est plus petit. Ça signifie qu'on aura plus de mal à mettre en évidence des différences entre produits. On a plus de mal à mettre en évidence des différences entre produits. C'est pas surprenant parce que ici je veux dire les différences entre produits, je les vois sur mon échantillon, mais elles sont telles sur cet échantillon que je peux affirmer qu'il y a des différences entre produits sur une population de juges quelconque. Donc je suis en train de faire une inférence et forcément pour faire de l'inférence, j'ai besoin de plus d'informations. C'est plus difficile pour moi de de faire de l'inférence. Et donc ça se traduit par la statistique de test est plus petite et on va avoir plus de mal à dépasser la valeur de 1 de façon significative. La loi de la statistique de test, c'est une loi de Fisher évidemment, avec degré de liberté du numérateur et degré de liberté de l'effet produit, et puis degré de liberté du dénominateur, donc degré de liberté de l'interaction produit-juge. Donc le test, c'est les mêmes hypothèses, mais c'est un test par rapport à l'interaction plutôt que par rapport à la résiduelle. Alors pour l'effet juge, en fait, les tests sont différents sur les hypothèses. Mathématiquement, les hypothèses se traduisent de façon différente, mais si j'explicite l'hypothèse, je vais toujours dire il n'y a pas d'effet juge. Et il n'y a pas d'effet juge, Quand c'est un effet aléatoire, eh bien je m'intéresse pas à chacun des bêta j mais je m'intéresse à la variance de l'effet juge. Donc je vais dire la variance de cette variable aléatoire c'est sigma carré de juge par exemple, la variance de l'effet juge qui est égale à zéro, donc ça veut dire qu'il n'y a pas d'effet juge contre la variance est différente de zéro. Donc l'hypothèse change un petit peu dans sa formulation mathématique, mais on est en train de tester la même chose: est-ce qu'il y a un effet juge ou est-ce qu'il n'y a pas d'effet juge? Et le test est construit de la même façon que l'effet juge soit fixe ou aléatoire. Que l'effet juge soit fixe ou que l'effet juge soit aléatoire, le test de l'effet juge est exactement le même. Je teste par rapport à la résiduelle. Ce qui change en fait, c'est juste le test de l'effet produit. Même chose si je teste une interaction produit-juge, produit-séance, etc. Je vais construire le test exactement de la même manière que l'effet juge soit fixe ou aléatoire. Donc le seul test qui change, c'est le test de l'effet produit, ou éventuellement aussi le test de l'effet séance, mais le test de l'effet séance, comme je ne le commande pas, c'est pas très grave. Donc le test de l'effet produit change, et puis le test de l'interaction produit-juge, c'est exactement le même. De l'interaction produit-séance, c'est exactement le même. Donc c'est les mêmes hypothèses: tous les alpha_ij sont égaux à 0 contre il y en a au moins un qui est différent de 0. Et les statistiques de test: je teste par rapport à la résiduelle. Alors ensuite, si on a vu qu'il y avait un effet produit significatif, on a envie de savoir quels sont les produits qui sont différents. Dès que je rejette l'hypothèse toutes les notes sont égales à 0, tous les alpha_i sont égaux à 0, Dès que je rejette cette hypothèse-là, ça veut dire qu'il y en a au moins un qui est différent de 0, et là je veux savoir lequel ou lesquels sont différents de 0. On va construire le test de conformité qui nous dit, est-ce que ce alpha_i particulier est égal à 0 ou pas? Donc H0, c'est le coefficient est égal à 0, et H1, le coefficient est différent de 0. C'est une statistique de Student, c'est une loi de Student avec des degrés de liberté, les degrés de liberté de la résiduelle.
More from Yamossoun











Algorithme de calcule de la racine carrée par dichotomie #dichotomy #squareroot #algorithm