The lecture explains how to use mixed‑effects analysis of variance (ANOVA) to characterize food products, illustrated with six chocolates evaluated on multiple sensory descriptors. It begins by emphasizing that most ANOVA models in practice include random effects such as blocks, animals, judges, or sessions. The presenter builds a simple ANOVA model with product, judge, and session effects (no interactions) and shows how the global Fisher F‑test confirms a significant product effect for the descriptor “cacao aroma”. He then conducts product‑specific Student t‑tests, interpreting the estimated product coefficients (α̂), their p‑values, and adjusted means (μ̂ + α̂) to identify which chocolates differ from the overall mean and whether they are above or below it. Because repeating this procedure for every descriptor is tedious, he introduces the R package sensominer and its `dcat` function, which automates the series of ANOVAs, ranks descriptors by discriminative power (critical p‑value), and formats the results. The output includes (i) a table of descriptors sorted by significance, (ii) per‑product tables of significant descriptors with adjusted means, and (iii) a comprehensive matrix of adjusted means colour‑coded (blue = significantly above, pink = significantly below, white = not significant). To make the matrix more interpretable, the presenter applies a principal component analysis (PCA) on the adjusted means, sorting rows (products) and columns (descriptors) by their coordinates on the first principal component, thereby grouping similar products and descriptors. Finally, he shows an alternative visualization: a bar chart of the observed t‑statistics for a single product, where bars exceeding ±2 indicate descriptors that characterise that product. Throughout, the lecture combines statistical theory with practical R implementation to provide a reproducible workflow for product sensometrics.
Chapters
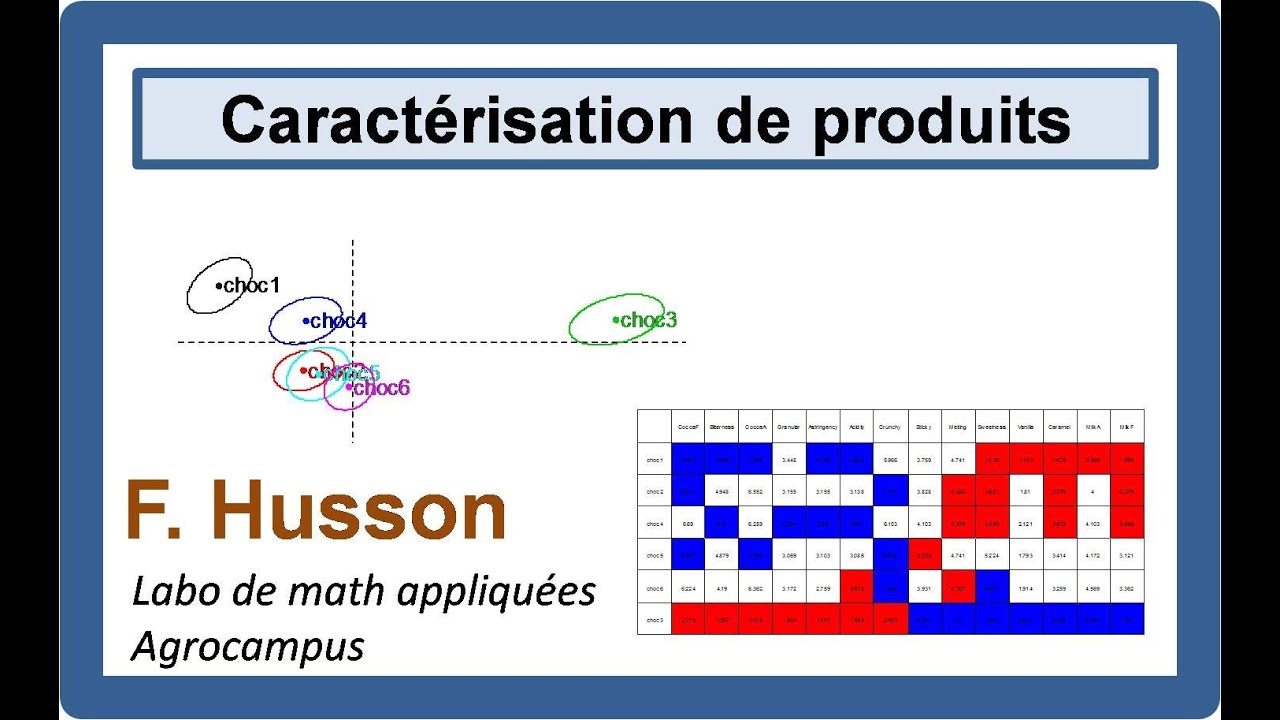
En agronomie, quand vous faites des essais en champ, on va souvent prendre des effets blocs, et l'effet bloc, c'est un effet aléatoire. On va faire des expérimentations sur des animaux, les animaux, c'est un effet aléatoire. Donc dans presque toutes les situations où on utilise des modèles d'analyse de variance, il un des effets est aléatoire. On a assez peu d'exemples en fait où tous les effets sont fixes. C'est souvent les modèles à effets fixes qui sont enseignés, mais en pratique on a assez peu d'exemples avec des modèles à effets fixes. Très souvent, il y a des effets qui sont aléatoires: l'effet animal, l'effet bloc, un effet individuel comme l'effet juge. Je vais revenir maintenant à de l'analyse sensorielle, à de la sensométrie. Donc utiliser les modèles d'analyse de variance pour caractériser les produits. Donc caractérisation des produits, l'objectif, eh bien, ça va être de caractériser mon ensemble de produits avec mes descripteurs, avec des variables quantitatives. Je vais essayer aussi de classer les descripteurs de celui qui permet le plus facilement de décrire l'ensemble des produits à celui qui n'arrive pas à décrire un ensemble de produits. Donc ça, c'est des objectifs sur les variables. On peut aussi se poser des questions sur comment caractériser un chocolat particulier. Je m'intéresse à ce chocolat. En quoi est-ce que ce chocolat est différent de l'ensemble des autres chocolats? Je peux répondre à cette question et pour ça, je vais utiliser l'analyse de variance et donc le test global F et les tests t pour décrire un produit particulier. Donc on va essayer de caractériser les produits. Alors j'ai construit des modèles d'analyse de variance. Dans mon exemple, je me suis intéressé à un modèle d'analyse de variance très simple où j'ai juste la note expliquée par un effet produit, un effet juge et un effet séance. Donc j'ai pas d'interaction Alors j'ai pas mis d'interaction pour avoir les tableaux entiers ici. Sur le premier tableau, vous avez les résultats du test de Fisher. On répond à la question: est-ce qu'il y a un effet produit ou est-ce qu'il n'y a pas d'effet produit pour l'effet juge et l'effet séance? Donc si on s'intéresse à l'effet produit, eh bien on a une probabilité critique ici qui vaut 7,61× 10⁻¹³, donc qui est très inférieure à 5%, et donc on rejette sans hésiter le fait qu'il y ait un effet produit. Et donc les juges arrivent à trouver des différences entre les produits pour le descripteur qui nous intéressait ici, c'est-à-dire l'arôme de cacao. Donc il y a des différences significatives dans l'arôme de cacao. Et donc s'il y a des différences significatives, j'ai envie d'aller regarder quelles sont les évaluations, quels sont les chocolats qui sont différents. Donc je construis les tests de Student, les tests t, chocolat par chocolat. Est-ce que le chocolat 1 donne des notes significativement différentes de la moyenne ou pas? Donc on voit que le alpha i chapeau est égal à 0,8 à peu près, 0,799, et ce coefficient de 0,8 est significativement différent de 0. La probabilité critique 9,71× 10⁻⁵ est très inférieure à 5%, donc je rejette l'hypothèse Et donc il y a un effet chocolat 1 significatif. Le chocolat 1 donne des notes différentes de la moyenne et supérieures même à la moyenne puisque le coefficient alpha i chapeau est positif. Donc on peut dire que le chocolat 1 a un arôme de cacao plus fort que la moyenne des 6 chocolats. Le chocolat 2, la probabilité critique est de 1,9210⁻¹. 10⁻¹, donc 0,19, c'est supérieur à 0,05, donc je vais considérer que le chocolat 2 donne des notes en gros dans la moyenne, c'est pas significativement différent de la moyenne. Le coefficient de 0,26, c'est pas significativement différent de 0. Le chocolat 3, il y a une probabilité critique qui est très inférieure à 5%, 2,74× 10⁻¹⁴, et un coefficient qui est négatif, -1,61, donc je vais considérer que ce chocolat a un arôme de cacao beaucoup plus faible que la moyenne. En moyenne, 1,6 point en dessous de la moyenne. Ça me permet de revenir sur la moyenne. La moyenne était de 6,29. Tous chocolats confondus, l'arôme de cacao était évalué à 6,29. Et puis, eh bien, le chocolat 3 a des notes de -1,61 par rapport à cette moyenne. Le chocolat 4 donne des notes dans la moyenne, pas significativement différentes de 0, et le chocolat 5 donne des notes supérieures à la moyenne, c'est significatif, 0,012, et le chocolat 6 donne des notes dans la moyenne. Donc voilà le genre d'analyse qu'on peut réaliser, et donc je peux réaliser ces analyses pour chacun des descripteurs. Donc je peux répéter ces analyses de variance pour chaque descripteur. Alors c'est assez fastidieux et donc on a créé dans le package sensominer une fonction qui s'appelle dcat qui va permettre de faire toutes ces analyses de variance, faire une boucle et répéter toutes ces analyses de variance et ensuite trier les résultats pour les mettre un petit peu en forme. La fonction ne fait que répéter des analyses de variance telles que je vous je vous l'ai présenté ici, et mettre en forme les résultats. Donc le premier résultat qui est fourni, c'est un tableau dans lequel on a les descripteurs qui sont triés en fonction de leur probabilité critique. Donc le descripteur saveur de lait a la probabilité critique la plus faible, c'est-à-dire que c'est le descripteur qui est le plus discriminant pour cet ensemble de produits. Qui permet de mettre en évidence un effet produit le plus facilement, donc avec une probabilité critique de 10⁻⁶¹. Et ensuite, les probabilités sont croissantes et donc tous les descripteurs ici sont significatifs. Toutes les probabilités critiques sont inférieures à 5% et grâce à tous les descripteurs, ici on a les 14 descripteurs, on a réussi à mettre en évidence un effet produit. Donc le jury était assez performant puisque il y a l'effet produit qui a été mis en évidence à chaque fois. Alors vous voyez qu'on retrouve le 7,61× 10⁻¹³, la probabilité critique de mon analyse de variance précédente, je la retrouve ici dans les probabilités critiques. Donc les descripteurs les plus faciles, c'est les descripteurs de saveur, saveur de lait et de cacao qui sont les plus faciles. Alors ensuite, je peux récupérer les données qui correspondent aux tests sur chaque chocolat. Alors ici j'ai une description d'un chocolat, le chocolat 1, et ce que j'ai récupéré, eh bien ce sont les coefficients des analyses de variance, donc le alpha 1 chapeau. J'ai récupéré le alpha 1 chapeau. Adjusted mean, c'est la moyenne ajustée, c'est-à-dire que c'est le mu chapeau plus alpha 1 chapeau. Et ensuite j'ai la probabilité critique qui est inférieure à 5%. Alors la v-test, j'en parle pas. C'est pas très intéressant. Alors dans ce tableau, on retrouve pour l'arôme de cacao la valeur de 0,799 qu'on avait eue dans l'analyse de variance. 0,799 et 9,78× 10⁻⁵ qui correspond à la probabilité critique. Et 7,09 qui va correspondre à Ω̂, donc c'était 6,29. +0,799. Comment sont mis les descripteurs ici? Les descripteurs sont rangés avec en haut du tableau les descripteurs qui caractérisent en positif le chocolat 1. Donc le chocolat 1 a des notes significativement supérieures à la moyenne pour les descripteurs d'amertume, saveur de cacao, astringence, acidité et arôme de cacao, et des valeurs négatives pour les autres. Alors vous voyez qu'ici il n'y a pas les 14 descripteurs parce que parfois le chocolat 1 était considéré comme ayant une note moyenne pour certains descripteurs. Donc dans le tableau n'apparaissent que les descripteurs significatifs, les autres sont oubliés du tableau. Et puis donc le tableau est trié, les descripteurs qui caractérisent en positif sont triés par probabilité critique croissante. Donc le descripteur le plus caractérisant en positif, c'est l'amertume. C'est un chocolat qui est considéré comme plus amer que les autres. C'est significatif, il est plus amer, plus amer que la moyenne. Ce qui le caractérise en deuxième, c'est quoi? On regarde les probabilités critiques, c'est tout en bas ici, d'accord? C'est la saveur de lait qui est plus faible que les autres. Saveur de lait de -1,89 avec une probabilité critique de 3× 10⁻¹⁸. Donc c'est la deuxième caractéristique de ce produit. Et ensuite, eh bien, on regarde, ça va être l'arôme de cacao qui est plus fort que pour la moyenne des autres chocolats. De 10⁻¹⁷. Donc on a les descripteurs les plus caractérisants pour ce produit, en positif, en négatif. Et donc on peut construire ces tableaux pour chaque produit. Donc si je construis les tableaux pour les chocolats 2 et chocolat 5, alors vous voyez que le chocolat 5 par exemple n'est caractérisé que par 4 descripteurs. Il n'y a que 4 descripteurs qui le caractérisent: donc l'arôme de cacao, le croquant, la saveur de cacao et le collant. Le chocolat 3, lui, est très particulier parce qu'il est caractérisé par les 14 descripteurs. Alors c'est ce que je vous avais dit, c'est le chocolat mi-doux qui était dans la gamme des chocolats noirs mais dans lequel il y avait un peu plus de lait. Eh bien là, c'est ce qu'on voit, c'est qu'il y a des aspects saveur de lait, caramel, sucré, vanille caractérisent ce chocolat avec des notes supérieures à la moyenne et assez supérieures. Un coefficient de 4,25, ça veut dire que Il y a 4 points de plus en gros pour ce chocolat par rapport à la moyenne des autres chocolats. Et au contraire, une saveur de cacao qui est plus faible, de 3 points en dessous de la moyenne des chocolats, peu croquant, peu amer, peu astringent. Donc là, on a un tableau par chocolat. Alors ici, les chocolats 4 et 6, un peu moins de descripteurs sont significatifs. Je vais pas décrire en détail ces chocolats, mais si Si on s'intéresse à un espace produit et à des produits en particulier, ces tableaux-là sont très intéressants. Alors il y a un tableau qui est aussi assez intéressant, qui récapitule en fait tout ça. Alors dans ce tableau, vous avez en ligne les produits, donc les 6 chocolats, et vous avez en colonne tous les descripteurs. Dans une case, vous avez ce qu'on appelle la moyenne ajustée, c'est-à-dire le μ chapeau plus α i chapeau. Donc pour l'arôme de cacao, Et le chocolat 1, on a la moyenne, le mu chapeau, 6,29, plus le coefficient alpha 1 chapeau, ce qui me donne 7,086. D'accord? Donc dans chaque case, j'ai ces moyennes ajustées. Alors certaines cases sont colorées. Quand les cases sont blanches, ça signifie que la note n'est pas significativement différente de la moyenne. Donc par exemple, pour le chocolat 1 et le croquant, On a une note, une moyenne ajustée de 5,966 et le chocolat 1 a une note de croquant qui n'est pas significativement différente de la moyenne des notes de tous les autres chocolats. Donc il n'est pas particulier, le chocolat 1, au niveau du croquant. Il est dans la moyenne. Et ensuite les cases sont coloriées si le chocolat est caractérisé par le descripteur. Et donc il y a 2 couleurs, en bleu, en rose. Le bleu, c'est que les valeurs sont supérieures à la moyenne, significativement supérieures à la moyenne. Donc par exemple, pour l'arôme de cacao, ce qu'on avait vu, c'est que le coefficient était de +0,799. Donc le chocolat est caractérisé par le descripteur arôme de cacao et il prend des notes supérieures à la moyenne. Et le chocolat et les cases roses signifient que les valeurs sont significativement significativement inférieure à la moyenne. Donc le chocolat 1, toujours, est caractérisé pour le, prenons le caramel, il y a une moyenne ajustée de 1,67 qui est significativement inférieure à la moyenne. Donc ce chocolat, je peux le caractériser aussi comme ayant une faible saveur de caramel. Alors ça, c'est un tableau récapitulatif qui est très intéressant parce qu'on a toute l'information sur quels sont les chocolats qui sont caractérisés par quel descripteurs. On voit par exemple que le chocolat 3 est très particulier. Toutes les cases qui correspondent au chocolat 3 sont coloriées. On voit qu'il y a des chocolats qui sont— le chocolat 5 par exemple est beaucoup plus moyen. Autre chose dans ce tableau, ce tableau est un peu trié. Les lignes sont pas dans l'ordre des numéros des chocolats. On n'a pas 1, 2, 3, 4, 5, 6, mais 1, 2, 4, 5, 6, 3. Donc en fait là, les lignes sont triées, les colonnes sont triées. Notre objectif, ça a été de trouver une façon de trier ces colonnes pour que les chocolats qui se ressemblent soient proches dans le tableau, et même chose, les descripteurs qui se ressemblent soient proches. Alors comment est-ce qu'on a pu faire à votre avis? Vous voyez que le chocolat 1 a des cases bleues sur les descripteurs de gauche, des cases roses sur les descripteurs de droite. Le chocolat 2, le chocolat 4, c'est à peu près les mêmes choses. Et le chocolat 3 en bas, C'est exactement l'inverse. Est-ce que vous avez une idée sur comment est-ce qu'on peut trier le tableau pour que les produits qui ont à peu près les mêmes valeurs pour tous les descripteurs soient proches? Nous, ce qu'on veut, c'est une procédure automatique. Quelle est la méthode statistique que vous connaissez tous qui permet de mettre dans un paquet des produits qui se ressemblent du point de vue de plein de descripteurs? Oui? Une ACP. Une ACP, c'est ça, c'est essayer de visualiser un ensemble d'individus selon beaucoup de descripteurs et de mettre proches des individus qui se ressemblent du point de vue de l'ensemble des descripteurs. Donc là, en fait, on a réalisé une ACP sur le tableau et trié les lignes, donc trié les produits en fonction de leurs coordonnées sur le premier axe de l'ACP. Alors pourquoi le premier axe? Parce que le premier axe C'est l'axe sur lequel il y a le plus d'informations, c'est l'axe qui discrimine le plus les produits. Donc on trie les produits par rapport au premier axe et on voit que c'est pas trop mal. Ce que ça donne, c'est que les produits 1, 2, 4, on voit qu'ils se ressemblent et qu'ils sont très différents du produit 3. Même chose pour les descripteurs, on prend les variables donc, on les trie par rapport à leurs coordonnées sur le premier axe. Donc on voit qu'il y a une sorte d'opposition entre les variables saveur de cacao, amertume, arôme de cacao, granuleux, astringence, acidité, croquant, et opposées au reste. Les couleurs sont vraiment différentes. Il y a des liaisons positives dans chacun des 2 blocs, mais d'un bloc à l'autre, les corrélations entre variables sont négatives. Voilà, donc ce tableau-là résume très bien l'information qu'on peut avoir pour caractériser les produits. Une autre façon de visualiser cette information, donc là je suis sur la même information en fait, mais sur des restitutions un peu différentes de cette information. Donc un tableau récapitulatif avec des couleurs. Une autre façon de le voir, c'est de construire des diagrammes en barres. Alors ça, ça va être plus intéressant si on veut s'intéresser uniquement à un produit donné. Donc je veux par exemple caractériser juste Le chocolat 1, eh bien, je vais focaliser uniquement sur ce diagramme en barres. Et comme ça, je peux fournir à la personne qui est intéressée par ce chocolat uniquement ce diagramme en barres. Je ne suis pas obligé de lui donner l'ensemble du tableau parce que si la personne n'est pas intéressée par les autres produits, ça ne sert à rien. Et donc sur ce diagramme en barres, eh bien, on a une barre par descripteur et la hauteur de la barre correspond à la statistique t de Student, le t observé. Alors pourquoi le t observé? Parce qu'on sait que, en gros, les valeurs sont comprises entre -2 et 2 s'il n'y a pas d'effet. Alors je dis entre -2 et 2, ça dépend un peu du nombre de degrés de liberté qu'il y a, mais pour les lois de Student, en général, on est autour de -2, 2. Donc si la barre est de hauteur plus petite que 2, le descripteur ne caractérise pas le produit, et si la barre est plus grande que 2, le descripteur caractérise le produit. Donc on voit tout de suite quels sont les descripteurs qui sont caractéristiques pour chacun des chocolats. Ce qu'on voit aussi, c'est qu'il y a des chocolats qui sont plus caractéristiques que d'autres, plus particuliers. Le chocolat 3, on voit bien qu'il est très particulier parce qu'il a beaucoup de barres qui sont très grandes comparé au chocolat 6 par exemple, ou au chocolat 5. C'est la même information que précédemment mais mise en forme différemment.