Dans cette vidéo tutorielle, les intervenants expliquent comment réaliser une imputation multiple dans le cadre d’une Analyse en Composantes Principales (ACP) lorsqu’il existe des données manquantes, en utilisant le package R missMDA. Ils décrivent d’abord la nécessité d’estimer le nombre optimal de composantes (ncp) via la fonction `estim_ncpPCA`, en testant entre 0 et 5 composantes et en sélectionnant 2. Ensuite, ils montrent comment appliquer la fonction `mipca` sur le jeu de données « orange » avec une ACP centrée‑réduite (scale = TRUE) et deux composantes, générant trois objets : `res.imputePCA` (tableau de données imputées), `res.mi` (tableau 3‑D contenant les 100 imputations) et `col` (paramétrage). Ils illustrent la visualisation des résultats : chaque variable apparaît sous forme d’un nuage de points (100 points = 100 imputations) dont la dispersion reflète la quantité de données manquantes, et chaque individu est représenté avec une ellipse de confiance indiquant l’incertitude de sa position. Les individus sans données manquantes se projettent exactement comme dans le jeu de données complet, tandis que ceux avec des manques montrent une variabilité plus importante. Enfin, ils notent que les dimensions principales restent globalement cohérentes à travers les imputations, avec seulement de légères rotations, ce qui confirme la stabilité de l’ACP malgré l’imputation multiple.
Chapters
Nous allons voir comment faire de l'imputation multiple en ACP. Pour ce faire, nous allons utiliser la librairie missMDA. Cette librairie contient plusieurs fonctions. Certaines permettent de faire de l'imputation avant de faire une ACP, d'autres permettent de faire de l'imputation en analyse des correspondances multiples et une autre permet de faire de l'imputation multiple en ACP. Donc nous allons voir comment faire l'imputation multiple en ACP. Avant cela, il est nécessaire d'estimer le nombre de composantes qui seront utilisées pour faire l'imputation. Pour ce faire, nous allons utiliser la fonction estim_ncppca. Nous précisons que le nombre minimum de composantes testées sera 0, le nombre maximum de composantes testées sera 5 et nous mettons les résultats dans l'objet nb. Cette étape est assez longue et ici nous avons estimé le nombre de composantes par 2. Nous pouvons maintenant réaliser l'imputation multiple. Donc calculer les tableaux de données imputées. Nous utilisons alors la fonction mipca sur le jeu de données orange. Nous précisons que nous souhaitons faire de l'ACP centrée-réduite scale=true et nous précisons que nous utilisons 2 composantes pour faire l'imputation. Nous avons alors 3 objets: un objet res.imputePCA qui correspond au tableau de données imputées, un autre objet res.mi qui correspond à un tableau en 3 dimensions Chaque tableau correspond à un tableau imputé et nous avons par défaut 100 imputations. Et enfin un objet col qui reprend l'ensemble du paramétrage. Nous pouvons maintenant représenter les tableaux de données imputées sur les graphes de l'ACP.
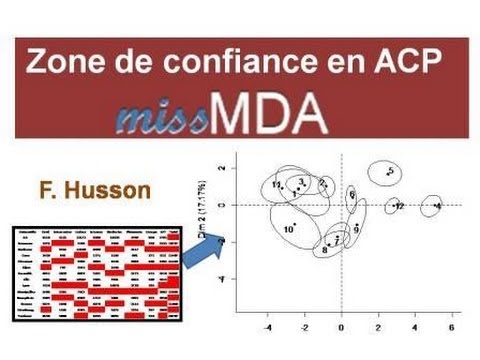
Nous obtenons donc un graphe avec la variabilité des variables qui est matérialisée par les points. Pour chaque variable nous avons 100 points qui correspondent au nombre de tableaux imputés. Pour certaines variables il n'y a aucune variabilité car il n'y a aucune donnée manquante, pour la variable typicité par exemple. Pour d'autres variables, il doit y avoir une seule donnée manquante, l'intensité de l'odeur, et pour certaines variables comme pour la variable sweet, il y a plusieurs données manquantes et donc un nuage de points avec une variabilité de la position de la variable. De même pour les individus, nous avons une incertitude sur la position de l'individu 5 avec une aire qui est matérialisée par une ellipse de confiance. L'individu 12 n'a aucune donnée manquante et donc il n'y a aucune variabilité sur la position de ce point car ici on s'intéresse à la projection de la variabilité en tant qu'élément supplémentaire. Donc l'ACP est réalisée sur le tableau de données complété et les tableaux imputés sont projetés en supplémentaire. Donc si un individu n'a aucune donnée manquante, il est projeté exactement au même endroit que l'individu du tableau de données initial. Nous avons également des ACP qui sont réalisées sur chacun des des tableaux imputés et nous projetons ici les dimensions de chacune des ACP. Nous voyons qu'il y a une légère rotation des dimensions de l'ACP mais que globalement la 1ère dimension est commune à toutes les représentations de l'ACP de chaque tableau imputé et la 2ème dimension également est commune. Pour les individus, nous avons ici une incertitude sur la position de chaque individu. Cette incertitude est également sur l'individu 12 car la position de cet individu dépend de la position des autres individus qui ont bougé et donc l'individu 12 va bouger. Il bougera moins que certains individus qui ont des données manquantes comme par exemple l'individu 1 qui a une ellipse qui est assez grande.