인간을 위한 인공지능 스터디 #1: 공정한 기계학습 모델 만들기
Jin Young Kim leads a study group on fairness in machine learning, examining real cases like Amazon's biased hiring algorithm and face-recognition errors. The group uses a loan-approval model to show how different thresholds create disparate impact across demographic groups, and compares fairness criteria like Demographic Parity and Equal Opportunity against profit-maximizing baselines.
Chapters
제가 사실 원래 유머리얼데이 한주 전에 시작하려고 그랬는데 여러가지 이유로 제가 시작 시간이 많이 늦었는데 어쨌든 사실 Human Factors in AI라는 그룹으로 처음 시작하는 미디엄 그룹이고요. 여기에 탑백이 사실 표현 리스트 말고도 뭔가 데이터 프라이버스도 있고 뭐 Interpretability도 있고 여러가지 기타 등등 다양한 Topic이 있는데 우선 Fairness가 좋은 엔트리 포인트인 것 같아요. 그래서 일단 제가 제일 관심있는 것이기도 하고 그래서 이걸로 시작을 해봤습니다. 우선 사실은 이게 그렇게 생각보다 간단한 주제가 아닌데 모티베이션을 좀 하고요. 일단 뭔가 좀 이건 사실 좀 컨트로버셜한 좀 탑이인 것 같아요. 뭔가 테크니컬한, 테크니컬한 심플한 옵티뮤지션 프로그램을 푸는게 아니라 뭐 이게 이게 옳은, 저게 옳은지, 뭐 이런 그런 가치판단 문제도 많아서 조금 임프렉티브하게 좀 제가 질문도 좀 드리고 진행을 하도록 하겠습니다. 우선은 어 뭐 첫번째 이게 모티베이징, 이게 사실 이거 적다가 그 마무리를 못했는데 모티베이징 이즈엠플이 뭐 그 책에 되게 많이 나와요. fairml.org에 있는 그 책에 많이 나오는데 우선은 그 아마존이 그 one hour delivery 그 서비스를 하는데 이제 요거를 처음에 다 안하고 미국 전역 다 안하고 이제 특정 지역으로 했는데 이거를 이제 결과적으로 보니까 이 서비스한 지역들이 다 white male dominated 그런 지역인 거예요. 그래서 그게 뭐 사실은 나중에 이제 발표가 돼 가지고 큰 이제 나중에 이슈가 됐는데 뭐 회사에선 당연히 우리는 어 그 레이스 가지고 이거 그 결정 안 했다 이렇게 얘기를 했죠 근데 이제 그럼 이게 뭐 문제가 없는 거냐 그러면 이게 사실은 예 뭐 문제가 있다고 볼 수도 있고 없다고 볼 수도 있는데 뭐 이런 이런 그 저기 그런 게 굉장히 좀 이슈가 되는 것 같고 어 그 다음에 뭐 구글에서 그 흑인 이름을 검색을 하면은 굉장히 좀 바이오런스나 뭐 그런 사건 사고 이런게 많이 나오고 white person name 검색을 하면은 무슨 뭐 예술이나 아니면 뭐 좀 더 좋은게 나온다는 거죠. 이제 이런 그것도 사실은 두가지가 굉장히 다른 건데 첫번째 아마존 example은 이거는 어찌 보면은 그 race 라는게 어떤 기회를 제공받는 혹은 제공받지 못하는 그런 기준이 되는 거구요. 회사가 의도하지 않았다고 해도 그렇게 되는 거고, 그 다음에 이제 두번째 웹서치 문제 같은 경우에는 그 이름을 사람들이 검색을 했을 때 약간 스테레오 타이핑이 될 수 있는 거죠. 그 black dominated name이 이제 약간 association이 되는게 이제 좀 negative한거랑 association이 되고 이제 vice versa가 되는건데 이게 두가지가 좀 다른거에요. 두번째는 약간 스테레오 타입을 강화시키는 그런 종이의 fairness 문제고 첫번째는 이제 그 어떤 선택을 제공 받느냐 못 받느냐 이제 그런거 있는건데 두가지가 다 중요한 문제인데 여기서는 일단 제가 먼저 이 책에서 주로 다루는 건 첫 번째 거라서 첫 번째 거 위주로 얘기를 할 거고요. 혹시 다른 페어리스 이슈 같은 거 아시는 분 있나요? 다들 주무시나?
원래 페이스 레코리션에서도 되게 페어리스한 게 있어서 흑인 여성은 얼굴이라고 인식이 안 되고 백인 남성만 인식이 되는 문제거든요.
고릴라, 고릴라.
아, 고릴라는... 고릴라는 아주 충격적인...
고릴라 그거 혹시 은영 님이 하신 거 아니에요?
제가 하는 게... 그 픽스 되게 좀... 픽스할 수... 아직 제대로 못했죠.
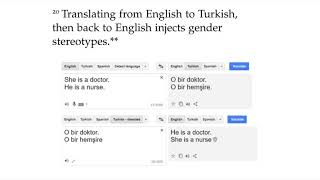
아, 고릴라. 고릴라, 사실 그것도 생각이 나네요. 뭐 하나 더 있어요. 이거는 이제 트랜슬레이션 문제인데 이걸 이제 이건 젠더 스티어 타이핑에 대한 건데 잉글리쉬를 터키시로 번역을 했다가 터키시를 다시 잉글리쉬로 번역을 했대요. 왜 이렇게 했는지 참 그 참 특이한 사람인데 그랬더니 이제 젠더가 바뀐 거에요. she is doctor, he is nurse 이렇게 시작을 했는데 터키시 갔다가 다시 잉글리쉬 갔더니 이게 바뀐 거에요. 이게 사실은 뭐 그것도 이제 사례를 찾자면 굉장히 많을텐데 이해는 가죠. 구글 트랜슬레이션이 스태티스티컬 트랜슬레이션이기 때문에 뭔가 터키시 이게 정확히 어디서 문제가 생긴지 터키시를 좀 알아야지 해결이 될 것 같은데 이 부분은 털키시의 히와 쉬의 구분이 없어서 생긴거죠. 없는 것 같죠. 그쵸? 네 맞아요. 없는 것 같아요. 그래서 없어서 여기 보면 똑같은데 닥털 뭐 널스 같고 요거를 다시 했더니 그냥 그 구글에서 뭔가 그럴듯한 걸로 만들어 준다고 한게 이게 젠더바이오스가 들어간 그런 문장이 된 거죠. 네 근데 이거를 어 이해는 가는데 이것도 이제 사실은 뭐...
근데 좀 궁금한 게 사실은 이게 어떤 사람의 특정인 인풋이 들어간 게 아니고 그냥 사실은 이 컴퓨터가 그냥 자연스럽게 트레이닝으로 통해서 배운 거잖아요. 근데 지금 문제가 트레이닝 데이터가 문제가 있을 수도 있지만 사실은 현실 세계에 남자가 의사인 확률이 더 많아서 이렇게 배울 수도 있는 거잖아요.
네 맞아요. 그거 자체도 이제 문제가 될 수 있다. 네.
근데 문제가 되는데 워낙 데이터가 그렇게 많으니까 기계가 하다보니까 너무 자연스럽게 그게 돼서 이런 문제가 나오는 건지.
내가 그거는 맞아요.
문제는 이제 문제가 두 가지 레이언데 하나는 이제 이런 ML에서 어디가 먼저냐를 따진 것보다 예를 들어서 기본적으로 데이터 디스트리뷰션을 가지고 ML모델을 만들었을 때 그 ML모델의 아웃풋이 다시 원래 디스트리뷰션을 리인포스 하는 경우가 많이 생긴다는 거죠. 그게 퍼스트 룩이 가장 우려되는 거죠. 예를 들어서 맨 처음에 이런 타입의 학생이 공부를 못하는데 그걸로 트레이닝 됐으니까 앞으로도 그런 타입의 학생이 크리티컬한 문제고 두 번째 이제 그러면 어디서 이거를 필터 하는 게 좋느냐 그 실질적인 문제가 있는데 그거는 이제 맨 처음에 데이터 밸리데이션 데이터 밸리데이션하는 모델로 데이터가 들어가기 전에 그 전에 파이플라인에서 이제 여러 군데 이제 필터 아웃해야 되는 부분이 있는 거죠. 두 가지 레이어가 있는 것 같아요.
병원님이 그냥 다 요약해 주셔서 저는 그냥 여기서 끝내도 될 것 같은데 좀 어렵다고
생각되는 게 사실 그런 통계적인 게 어떻게 보면 Q가 될 수 있는 거잖아요. 어떤 ML에서 결정을 내릴 때 데이터에서 나오는 통계적인 게 사실은 정답이라고 생각해요.
근데 생각해보니까 간단한 방법들이 있어요. 예를 들어서 트레이셜 베이스로 간단하니까 되게 간단하게 생각할 수 있어요. 예를 들어서 우리가 베이스 예를 들어서 은혁님 말대로 맨 처음에 데이터가 현실세계 데이터 디스트리뷰션이 바이어스되어 있어서 맨 처음에는 예를 들어서 남자 닥터가 꼭 그렇지 않지만 남자 닥터가 60% 데이터가 있고 여자 닥터가 40% 있다고 맨 처음에 베이스 모델은 그렇게 트레이닝을 할 수 있지만 지금 모던 ML 파이플라인은 대부분 그 다음에 계속 스트림된 데이터를 가지고 계속 업데이트를 하니까 그 업데이트 할 때는 데이터 밸리데이션을 할 때 그래서 최소 오늘 닥터들 들어온 것 중에서 50 50가 되는지를 봐서 남자가 이미 50 됐으면 더 이상 남자는 스트레인 하지 않고 해 줄 수 있는 그런 간단한 방법들이 그런 건 뭐 그렇게 어렵지 않아요 생각보다 이제 그렇게 훈련을 보면 되죠.
트레이닝 데이터에서 사람이 그러니까 인위적으로 PBT를 맞춰서 해 줄 수는 있을 것 같은데 사실은 그냥 실제 어떤 정보를 인식할 때는 현실 세계를 예쁘게 매칭하는 건 아닐 수가 있잖아요. 그러니까 데이터가 약간 언베어 하기 때문에 그 페어리스트가 어떤 쪽이 알고리즘 하는 게 사실은 그게 있는 거를 캡치를 못할 수도 있죠.
그렇죠. 그러니까 제가 그 잠깐 정리를 하면은 근데
뭐 사실 그냥 되게 어려운 문제 같아가지고
어려운 문제라고 이제 그러니까 여기 여기서 이제 얘기하는 거는 저도 이제 조금 책을 읽으면서 좀 왔다 갔던 구절이 그 당연히 이제 바이오스를 넣어서 이제 트레이닝 하는 거잖아요. 바이오스를 넣어야지 이제 인덕티브 바이오스가 있어야지 이제 ML이 작동을 하는 건데 여기서 얘기하는 건 이제 그 ML 알고리즘은 어떤 바이오스가 그 한풀한 거고 어떤 바이오스가 한풀하지 않은지 모른다는 거예요. 제가 이따가 정리를 할 텐데 그러면 무작정 다 넣으면 되지 않냐 이렇게 생각할 수도 있는데 아까 병황님 말씀하신 대로 문제가 뭐냐면 여기서 트랜슬레이션이 나오면 이게 끝나는 게 아니에요. 왜냐하면 트랜슬레이션이 나오면 이게 리얼월드에 들어가면 사람들이 이걸 쓰기 시작하면 이게 계속 reinforcement positive feedback loop를 만든다는 거죠. 지금 예를 들어서 이런 종류의 인스턴스가 10 out of 3가 나오면 나중에 positive reinforcement가 되면 10 out of 10이 나올 수 있다는 거죠. 그래서 이제 이게 좀 위험한 거고 사람들이 문제를 삼는 것 같아요. 예를 들어서 아까 제가 말씀드린 아마존 딜리버리 같은 경우도 이거 우리가 아마존이 젠더 확보 안했다. 그리고 사실 누가 아마존이 젠더 확보 했다고 믿겠어요? 근데 이제 문제가 되는 거는 소사이티가 이렇게 컴퍼니들 이렇게 이렇게 하기 시작하면은 좋은 지역에는 사실 좀 더 사실 여기 팝플레이션이라고 웨이스가 들어가겠지만 사실은 뭐 소득수준이나 이런게 사실 크겠죠 아마존이 다무리도 좀 더 수익이 나올 때를 먼저 했을 테니까 이제 그러면은 계속 이게 그 편리시셜이 다 모인다는 거죠 좋은 좋은 지역에 그러면 이제 계속 계속 이것도 피드백 루프기 때문에 그런 이유 때문에 이게 좀 더 그런 일들 때문에 이게 좀 더 문제가 되는 것 같아요.
근데 약간 제가 조금 약간 스텝백해서 이런 바이오스 이슈 자체가 이제 ML의 유니크한 이슈인지 아니면 많은 다른 디스터플린에도 다 어플라이 되는 이슈인지 좀 생각해 볼 필요가 있을 것 같아요. 물론 이제 ML이 이제 되게 지금 이제 되게 그런 프레셔를 받고 있는데 그래서 대부분 환자들 패션 샘플들이 상당히 유러피언 컨트리로 바이어스가 되어있거든요. 대부분 리터리더라던가 환자들에 대한 스터디 패션 스터디 자체가 다 대부분 유러피언 컨트리로 바이어스가 내 사람들의 그걸 되어있거든요. 다 데이터가 되어있어요. 거기서 많은 결론이 되어있고 그러니까 그런 다른 나라의 임상 결과는 상당히 마이너 거의 없다고 그냥 거의 없다고 보는 게 더 맞는 그런 경우가 많아요. 그러니까 우리가 이제 지금까지는 사실은 이제 다른 그런 도메인이나 다른 그런 필드에서는 그런 것들에 공격을 잘 받지 않았는데 생각해보면 되게 바이어스가 많다는 걸 많이 느낄 수 있을 거에요. 근데 이제 ML은 워낙 데이터 드리븐이니까 좀 더 거기에 요구하는 목소리가 더 커지는 것 같아요.
여기서도...
Education도 똑같아요.
학생들이
어떤 학생들이 어떤 수입, 어떤 배경, 집안의 부모님이 어떤 직업이라든가, 어떤 교육 수준이라든가, 어떤 수입, 어떤 배경, 집안의 부모님이 직업이라든가, 교육 수준이라든가, 수입, 어떤 배경, 집안의 부모님이 어떤 근데 직업이라든가, 어떤 교육 수준이라든가, 그게 꼭 아닐 수도 있잖아요. 근데 하여간 그런 것들이 바이어스가 엄청 많죠.
여기서도 얘기하는 게, 이런 얘기 할 수 있잖아요. 사람이 ML 가지고 지금 뭐라고 하는데, 사람이 하면 문제가 없냐? 사람이 해도 문제가 당연히 있구요. 그 다음에 사람이 하는 게 더 나으냐, 머신이 하는 게 나으냐. 머신을 잘 만들면, ML을 잘 만들면 사람이 하는 것보다 나을 수가 있다. 여기서는 이런 아귀멘트 하는 것 같아요. 적어도 이제 여기서 얘기하는 거는 적어도 이제 이 전체 사이클이 지금 여기 Problem Setting, 이 책에서 얘기하는 Problem Setting인데 처음에 어떤 세상의 어떤 상태에서 출발해서 데이터화하는, 코딩하는 과정이 Measurement고 데이터에서 모델을 만드는 게 이제 러닝 하는 거고 그 와중에 이벨루션 들어가고 그 다음에 이 모델이 이제 다시 그 인디비주얼을 그 인터랙트 한다는 거죠. 액션하고 피드백 받고 이 전체가 이제 그 홀 룩인데 그 다음에 이게 당연히 다시 이 state of the world에 피드백 되고 이제 이 전체가 사람이 이걸 하면은 이게 눈에 보이지 않게 한다는 거죠. 근데 이제 적어도 이 데이터 모델 이 부분이 다 인튜티블리 처리가 되면은 근데 이제 그 머신 ML은 이제 적어도 요 부분을 익스포즈 해가지고 정말 익스플리셋하게 그 바이오스를 측정할 수 있는 가능성이 더 많이 열립니다. 물론 뭐 사람이 해도 이제 그걸 다 기록에 남기면 할 수는 있겠지만은 그래서 뭐 그 예 최근 약간 더 이제 머신 러닝이 좀 잘 됐을 때 그 바이오스를 줄일 수도 있다 이렇게 믿는 쪽인 것 같아요. 음 그래서 예 제가 좀 뭐 좀 재밌는 얘기 나오면 적으면서 할게요 보이시죠 슬라이드는 다 이렇게 해도 그래서 이제 처음에 사실은 요 스텝 바이 스텝 다 이제 그 바이어스가 들어갈 수 있는 아니면 강화될 수 있는 그런 여지가 있어서 있다는 걸 이 책에서 이제 보여주는데 처음에 이제 매조먼트 하는 그 단계에서 어 보통 생각하면 이제 뭐 이제 문제가 되는게 주로 문제가 되는게 카테고리컬 베리어블인데 레이스라고 생각하면 보통 레이스는 뭐 사실 레이스는 레이스지 이게 뭐 바이오스틱에 들어갈 수 있어 약간 이렇게 생각할 수 있는데 사실 레이스 자체도 바이어스가 아니라 이제 어떤 에러든 아니면 어떤 뭐 그 매저먼트 이슈가 발생할 수가 있다고 생각하는게 이것도 이제 그때 그 시대에 따라 굉장히 카테고리가 어떤 사람이 메일이냐 어떤 사람이 YS냐 어떤 사람이 블랙이냐 요게 다 시대에 따라서 많이 달라졌다고 그러더라구요 그리고 이제 여기 이 책에서 얘기하는 것도 그 레이스가 이제 최근에 생긴 카테고리가 믹스트 카테고리가 생겼대요 그래서 혼혈 약간 이런 카테고리가 최근에 생겼는데 그것도 이제 사실은 어 카테고리화 되지 않았던 게 생기는 약간 그런 식으로 뭔가 계속 변화를 우리가 생각하는 레이스는 되게 스테이블한 것 같지만 이것도 역시 계속 시대에 따라 바뀌고 그렇다는 얘기고 그러면 이제 제일 문제가 되는 게 사실은 이 그 ML에 타겟 베리어벌 보통 이제 그 클래시파이어에 이제 레이블이 되는 이런 게 사실은 사람들이 자기적으로 정의하는 경우도 많고 그래서 당연히 이게 타겟 베리어블이 아웃컴에 직접적인 영향을 주기 때문에 바이어스가 거기에 있으면 문제가 된다는 건데 그래서 보통 이제 생각하는 어떤 사람한테 로운을 줄 수 있을 것인가 안 것인가 이제 그런 크레딧 월드니스 요거를 이제 디파인하고 이제 레이블링 하는 그 과정 자체가 굉장히 바이어스 프론하다 그런 얘기를 여기서 하고요 그 다음에 이제 그러면 이거를 이제 무시하고 그 하면 어떨까 무시하고 하면 안되냐 이렇게 생각할 수 사실 사실 보통 바쁘면 보통 무시하고 하죠 이거를 그리고 이제 뭐 아까 뭐 고릴라 고릴라 얘기는 나왔지만 이미 뭐 이미지 레이블이 뭐 뭐 헌데 따오즌드 밀리언 이면은 사실은 다 보긴 어렵죠 근데 이제 어 이거를 무시했을 경우에 이제 문제가 바이 그 모델이 이제 여기서 좀 더 이제 매트매티클리 프리사이스 한 그런 그 얘기가 나오지만은 좀 더 러프하게는 데이터에 있는 바이오스는 그대로 모델에 반영이 된다. 그런 거죠. 그래서 무시했을 때 결과에 바이오스가 나오고 이걸 모르고 그냥 나중에 모델을 리얼월드 디플로이 하면 이런 문제가 생긴다는 거죠. 그래서 매저먼트 스테이지부터 사실 바이어스 굉장히 많이 들어갈 여지가 있고 그럼 이제 그 모델을 만드는 그 단계에서 어떤 일이 생길 수 있느냐 뭐 데이터에 바이어스가 있으면 당연히 여기에 이제 이게 그 이 단계도 영향을 받는 거지만 바이어스가 없다고 해도 사실은 이제 그 그 샘플 사이즈가 그 우리가 생각하는 이제 그 타겟 그러니까 센시티브한 어떤 그룹이 있잖아요. 예를 들어 젠더, 레이스, 지역이 될 수도 있고 병황님이 말씀하신 유럽 쪽에 메디컬 데이터가 많다. 이게 약간 여기에 관련된 건데 데이터가 예를 들어 이제 머저리티 카테고리에 속하는 사람들의 데이터만 있을 때 그러면 이제 그 그러면 모델링 과정이 이제 사실은 그 majority 카테고리에 거의 이제 위주로 돌아간다는 거죠. 그래서 거기 majority 카테고리에 포함해서 발견된 패턴이 모델에 인코딩이 되고 그게 결과로 나오고 그래서 이제 여기서 그래서 얘기하는게 by default, models will reflect disparities found in input data. 그러니까 여러가지 패턴이 모델에 들어가는데 이제 이게 이 중에 뭐가 문제가 사실 모든 모델의 옵티미제이션 크라이테리가 대부분은 이제 그 어떤 특정한 보통은 뭐 로스 펑션 정의해서 이제 그걸 미니마이즈 하는 경우가 많기 때문에 그거에 도움이 되는 모든 패턴을 다 사용을 하겠죠. 이제 뭐가 좋은지 뭐가 뭐가 프라블루미틱한지를 모른다는 거고 모델 자체는 그래서 이제 아마존이 이제 예를 들어서 이제 아까 아마존의 엑셈플로 돌아가서 아마존에서 이제 그 레이스를 이제 그 서비스 디플로이 결정할 때 이제 베리어블을 안 썼을 수도 있지만 그렇다고 이제 문제가 해결되는 거 아니라는 거죠. 그걸 안 써도 데모그래픽 베리어블 그러니까 레이스 젠더 이런 게 사실 다른 그 베리어블이랑 굉장히 많이 콜레이 된다는 거죠. 그래서 이제 그런 거 여기서는 프록시 베리어블이라고 하는데 결국에 내가 조심해서 센시티브 베리어블을 모델링해서 빼도 결과는 이제 바이오스가 되게 나올 수 있다는 거죠. 그리고 그것도 아까 말씀드린 그런 이유로 그 파시티브 피드백 이런 이유로 이제 문제가 될 수 있기 때문에 그런 걸 이따가 이제 좀 더 어떻게 해결하는지 얘기가 나오는데 일단은 그런 걸 빼는 거는 베리어블 빼는 거는 이제 해결책이 아니다 그런 얘기구요 음 그리고 이제 샘플 사이즈 문제가 이제 그룹별 샘플 사이즈가 달랐을 때 문제가 생길 수 있다는 거니까 꼭 explicit한 바이어스가 있어야 되는 게 아니라 샘플 사이즈가 그룹별로 달라도 문제가 생길 수 있고 그러면 이제 보통 evaluation을 이제 overall accuracy를 많이 하는데 그런 경우에 이제 이게 문제가 있어도 모른다는 거죠. 예를 들어 90%를 차지하는 카테고리에 대해서 Accuracy가 90%다. 그러면 나머지 10%에서 다 망쳐도 크게 안 떨어지죠. 그러니까 이제 이런 경우에는 사실 Metric이 도움을 줄 수도 있는 게 만약에 Per Group Accuracy 같은 걸 계산을 하면 한 그룹을 완전 스크롭하는 것을 적어도 이제 인식할 수 있다는 거죠. 그래서 이 단계에서는 사실 요거는 조금 그 되게 할 얘기가 많은 분야인 것 같긴 한데 네 이정도 일단 지금 모티베이션 하는 부분 이니까 네 이정도로 하고요 근데 이제 그 그러면 그 아까 아까 이제 병원님이 잠깐 이제 이 문제를 어떻게 해결하느냐, 처음에 Measurement에서 해결하느냐, Running에서 해결하느냐, 이제 이 부분은 아직 얘기를 안 했지만 이제 다음 단계에서 해결하느냐, 이제 문제 생각을 할 수 있는데 그 한 가지 고려사항은 Measurement 단계에서 만약에 해결을 하면은 좋은 측면은 이제 그 해결 방법이 이 Learning 알고리즘에 약간 Agnostic하다는 거죠. 그러니까 그 데이터를 Clean up 하면은 이거를 어떤 ML 알고리즘을 넣어도 그 혜택을 받을 수 있다는 장점이 있고 반대로 러닝 알고리즘 러닝 할 때 그 문제를 해결하려고 하면 러닝 알고리즘 특정한 어떤 컨스트레이트에 좌우되는 그런 한계가 있다는 거죠. 그런 고려사항이 있는 것 같아요. 어느 단계에서 문제를 해결할 거냐. 그런 결정을 할 때 음 그 다음에 마지막 이제 단계가 ML 알고리즘이 이제 디플로이드에서 끝나는 게 아니라 이제 세상에 나가면 이제 그게 사람들이 의사결정에 영향을 미치고 그럼 이제 그게 또 세컨드 오더 이펙트를 만들 수 있다는 건데 여기서 이제 얘기하는 그 첫 번째로 얘기하는 게 이제 그 traffic congestion prediction을 했을 때 그거를 보고 사람들이 이제 그 길로 안 가면 이제 그 outcome이 invalidate 된다는 거죠. 그런 얘기를 하고 이거는 약간 negative feedback이 되는 거죠. 내가 prediction 했을 때 그 결과가 이제 반대로 실제로 실제로 나타날 수 있다는 건데 반대로 이제 그 더 좀 더 많이 생기는 경우는 positive feedback이 있을 수 있고요. 요건 이제 뭐 사용자 예를 들어 클릭 데이터를 사용자가 바이오스 결과가 바이오스가 있을 때 그게 또 클릭 데이터를 바이오스 된 클릭 데이터를 만들고 그럼 이제 클릭 데이터가 또 피드백 돼 가지고 또 결과가 더 바이오스가 되고 뭐 그런 식으로 이제 계속 패턴이 강화된다는 그런 문제 그 다음에 이제 마지막으로 prediction 이제 outcome 을 가지고 또 데이터 컬렉션을 이걸 사용할 때 예를 들어 뭐 보통 생각하는 액티브 러닝이나 뭐 이런 게 그럼 여기에 해당하는 것 같은데 여기서 재미있는 익스템프를 이 저자들이 약간 그 좀 더 그 사회학이나 이런 쪽 백그라운드가 있어서 그런지 이런 얘기가 많이 나오는데요 뭐 어떤 지역에 범죄율이 높아 가지고 그래서 어 아니면 범죄율이 높다고 예측이 돼서 폴리싱을 많이 할 수 있잖아요 그 지역에 그럼 이제 그 지역에서 범죄가 더 많이 나온다는 거죠 그러면 이제 더 범죄를 높이기 때문에 더 폴리싱 많이 하고 요것도 약간 실제 리얼 월드에서 발생할 수 있는 그런 세컨 오더 이펙트가 계속 강화되는 처음에 어떤 state of the world가 데이터에 반영이 되고 그 바이오스가 이제 계속 들어가서 그 액션에 영향을 끼치고 다시 state of the world를 존재하는 바이오스 강화하고 예 그런 그런 약간 사이클 그래서 좀 무서운 것 같아요 저도 사실은 처음에는 이게 왜 문제야 이게 왜 문제야 약간 아마존 뭐 뭐 그럴 수도 있지 약간 이렇게 생각했는데 요 피드백 사이클을 좀 더 어회하고 나면은 좀 무서울 수 있는 것 같아요 그리고 지금보다 ML 드리븐하게 돌아가는 사회 컴포넌트가 훨씬 많아질 거라고 생각을 하면 뭐 하이어링, 하이어링 얘기도 많이 나오죠. 하이어링에 이제 바이오스를 넣었을 때 어떻게 문제가 되는지 그런 게 이제 계속 앞으로 더 광범위해지고 더 영향도 커지고 어 그러면 이제 사실 좀 무서운 것 같아요. 그래서 저 같은 경우에 조금 더 어 중요, 진짜 이게 중요한 문제구나 인식을 하게 됐고요. 음 혹시 뭐 질문이나 의견 같은 거 있으신가요? 다음에...
하이어링 할 때 ML 안쓰면 안되나요?
아 뭐 사실 모르겠어요 이게 하이어링 할 때 ML 쓴다는 건 보통은 그 단계인 것 같거든요 그 처음에 그 스크린링 할 때 그니까 뭐 10,000 resume 왔을 때 100으로 추리는 과정인 것 같은데 어 뭐 사람 쓰면 되죠 사람 쓰면 되는데 어 근데 이제 사람을 썼을 때 그게 오히려 더 나을 거냐 바이오스 적을 거냐 뭐 당연히 사람 쓰는 것보다는 알고리즘이 더 쌀 수도 있죠.
근데 오히려 알고리즘 쓰는 게 바이오스가 적게 들어가지 않을까요? 원래 사람이 지금 이름에 의해서 흑인인지 백인인지 구분해서 한다든지 오히려 알고리즘이 더 잘 할 수도 있을 것 같아요.
그러니까 알고리즘을 그렇게 빌드하면? 네, 그렇죠. 알고리즘을 그렇게 빌드하면 되는 것 같아요.
빌드하면 그렇죠.
맞아요. 그 사람을 쓰는 비용은 계속 있을 거고요. 알고리즘을 그렇게 페어형에 만들 수 있으면 페어형 결과를 훨씬 싸게 얻을 수 있으니까 그게 아귀멘트인 것 같은데 저 같은 경우에는 굉장히 오로메이션 좋아하는 편이라서 바이오스가 절대 하이어링은 손으로 해야 된다 이런 분 있으신가요? 병황님? 혹시?
그게 아니라 이제 하이어링 할 때 하도 이슈가 많다고 하니까 그럼 안 쓰면 안 되나? 사람들이 되게 하이어링 하는 문제, 로운은 뭐 실제로 그렇게 로운 회사들에서 실제로 로운 어플리케이션을 할 때 이제 근데 그 전에도 크레딧스코나 예전에 썼던 피쳐들이 있는데 조금 더 ML적인 피쳐를 더 넣어서 실제로 어플리케이션을 디나이 하기도 하고 그런 것들을 실제로 많이 하더라고요. 그리고 그게 문제가 실제로 되고 근데 하이어링은 좀 약간 앰비규어리가 많은 것 같아요. 그래서 사실 사람들이 이제 발표나 이럴 때 하이어링을 문제를 많이 가져오는데 사실 하이어링 할 때 어떻게 이슈가 되는지 잘 모르겠어요. 그래서 제가 물어본 거예요.
이슈가 되는지 모르시겠다는 거는 문제가 생기는지를 모르시겠다는 거예요? 아니면 문제가 생겨도 별로 엑스포이즈가 안 될 것 같다는 거예요?
진짜로 있는 문제인지 잘 모르겠어요. 다가오지 않는 것 같기도 하고 뭐 그쵸
저도 그걸 해본 건 아니라서 어 근데 이제 제가 아마존에서 제가 이것도 아마존이 샘플인 것 같은데 뭐 하이링 아마존 충분히 그럴 수 있을 것 같아요 아마존이 그 이따 이런 이런 거 잖아요 뭔가 더 efficient 하게 만드는 걸 좋아하니까 이렇게 일단 모델 돌려서 별생각 없이 디플로이 했더니 뭐 결국에 뭐 레주메 하이어링 익샘프레스 레주메가 다 white male 레주메만 남았다 뭐 그런 그런 뭐 그럴 수 있을 것 같은데 암튼 그거는 뭐 제가 제대로 본건 아니니까 지금 시간이 한 10분 정도 남아서 어 네 그래서 지금까지 이제 약간 어떤 사이클의 이제 그 ml 사이클의 어떤 부분에 이제 뭐 바이오스 들어갈 수 있는지 그런 얘기를 했구요 그 다음에 이제 어 그럼 이제 좀 다른 얘기를 좀 더 하자면은 트랜스페어리시가 사실은 이제 페어리시랑 관계가 있죠. 트랜스페어리시가 있으면 이제 사실은 유저도 그렇고 이제 모델 빌딩 하는 사람들도 그렇고 뭐 fairness issue를 디텍트하고 그 다음에 뭔가 address 할 수 있는 그런 가능성이 높아지기 때문에 transparency가 이제 조금 약간 이제 관련이 있는 그런 부분이고 그 다음에 이제 제가 아까 처음에 처음에 이제 아마존이랑 구글 어 서치 가지고 말씀드렸는데 바이오스가 이제 두 가지 있다는 거죠. 리소스 알로케이션에 그 경향을 주는 바이오스가 있고 그룹에 하이어링을 더 많이 한다 안한다 약간 그런 종류의 함이고 그 다음에 representation harm은 이제 그 스테레타입을 강화하는 종류의 함이고 그 다음에 이제 요게 지금 또 문제가 될 수 있다는 거죠. 사람들이 세상을 이해하고 뭔가 다 이제 검색해서 하고 번역하고 이제 그런 거에 의지를 하니까 문제가 될 수 있다는 거고 네 어쨌든 제 생각이 지금 케이스 스터디 하나 보고 나면 끝날 것 같은데 어 사실은 요걸 이게 제가 사실 요거 처음에 페어리스트 설치할 때 처음에 봤던 비주얼리제이션 구글에서 만든 건데 이거 되게 좋은 것 같아요 사실 이거 가지고 그냥 어 뒤에 되게 제가 뭐 그 책이랑 그 튜토리얼에 나온거 여러가지 많이 봤는데 다 이거 그냥 하나 보는게 저한테 훨씬 더 좀 스트레이트 포드됐던 것 같아요 그래서 이제 얘기하는게 이제 여기서는 론 누구한테 론을 줄 것인가 그 문제 가지고 이제 시각화를 만든건데 아무래도 시각화니까 시각화를 보면서 이 논문 나중에 어느 분이 저 발표해 주시면 좋을 것 같아요. 이 논문도. 사실은 이 논문에서 얘기하는 게 이제 우리가 얘기하는 Fairness Criteria 중에 하나인데 그거를 이 논문 가지고 얘기하면 좋을 것 같습니다. 그래서 이제 여기서 얘기하는 거는 Loan을 누가 갚을지 그걸 이제 예측해서 Loan Approval 하는 그런 문제인데 당연히 이제 론을 갚을 사람, 론을 안 갚을 사람, 이 두 클래스가 있고, 이제 실제로는 이 클래스에 오버랩핑이 있다는 거죠. 여기서 이제 몇 가지 데피니션이 나오는데, 특정한 Threshold를 주고 이제 론 어플버를 그냥 한다면, 이제 4가지 경우를 할 수 있죠. 그 엘리자벌 그니까 갚을 사람인데 우리가 못 받을 경우도 있고 갚을 사람한테 우리가 주는 경우도 있고 못 갚을 사람한테 주는 경우도 있고 못 갚을 사람한테 안 주는 경우도 있고 당연히 이제 우리는 이제 Accuracy 관점에서는 이제 그 갚을 사람한테 최대한 주고 못 갚을 사람한테 최대한 안 줘야죠. 그게 Criteria고 어 그 다음에 여기서 이제 얘기하는 positive rate는 몇 퍼센트한테 론을 줄 건지 요거를 이제 threshold를 옮기면 이제 이게 계속 바뀌죠? 완전 높이면 positive rate 거의 0이 되고 그 다음에 이제 높이면 95%가 되고 그 다음에 true positive rate는 여기서 그 전체 true label을 중에서 몇 퍼센트한테 론을 grant 하는지 갚을 사람 중에서 얼마나 우리가 론을 주는지, 그것은 당연히 Threshold에 따라 바뀌는데 이건 이 그룹에서만 가지고 이제 그 Ratio를 만드는 거죠. 이제 여기까지는 간단한데 여기까지는 이제 Straightforward한 클래시피케이션 문젠데 이걸 이제 그 두 그룹 두 그룹에 이제 그거에 놓고 생각을 하면 아까 좀 정리를 해놨는데 보자 그러니까 이 두 그룹에 일단 보시면 블루랑 오렌지가 있는데 블루 파퓰리션이 일단은 distribution이 달라요. distribution shape이 달라요. 훨씬 더 가운데 모여있어요. 그 variance가 더 작은 그룹이고 오렌지는 더 넓죠 그 variance 크고 그 다음에 이제 오렌지가 좀 더 그 left에 있을까 더 덜 credit worth에요 그냥 ratio를 보면 근데 이제 그럼 이제 우리가 이런 상황에서 이게 사실은 실제 리얼 월드에 많이 발생하는 상황이겠죠 사실 그 아까 뭐 아마존 example 같은 경우에도 이 두 그룹이 지역마다 디지털 표현이 다를 거라는 거죠. 그리고 거기서 사용한 그 얘기는 그만하고. 그래서 만약에 이 예제를 갖고 그럼 일단 가장 단순하게 론 어프로브를 주는게 Threshold 하나 딱 정해가지고 아 우리 공평하게 합시다 해가지고 이 그룹에 관계없이 Threshold 하나 딱 정해가지고 55 여기서 딱 끊어 그러면은 그러면 이제 어떻게 그 결과가 나오느냐 하면은 어 이 오렌지 그룹 같은 경우에는 일단 어프로브를 훨씬 훨씬 덜 받았죠 왜냐면 이제 그 얘네는 이제 사실 훨씬 더 왼쪽에 더 많으니까 블루 같은 경우에 업로드가 훨씬 많이 받았고 그 다음에 이제 그럼 이제 또 다른 크라이테리아가 이제 파스티브 레이트가 일단 다르고요. 그 다음에 트루 파스티브 레이트 같은 경우에도 다르죠. 보시면 이제 트루 파스티브인 이 면적에서만 계산하는 건데 블루 같은 경우엔 true positive rate가 훨씬 높고 오렌지 같은 경우엔 true positive rate가 훨씬 낮죠. 왜냐하면 이만큼의 엘리자벨한 사람들이 실제로 롤을 못 받았기 때문에 그래서 이제 이거를 그냥 별 생각 없이 딱 정해 가지고 그냥 합시다 이렇게 합시다 하면 오히려 역차별이 생긴다는 거죠. 그래서 그 그래서 loan strategy를 봤을 때 지금 이게 max profit, 그러니까 지금 strategy 4개에 따라서 어떤 결과가 나오는지 이제 이 visualization이 나오는데 max profit을 하면 이제 블루 쪽에 훨씬 더 그 threshold이 높아져요. 그러니까 이거는 이제 뭐 그럼 이제 이렇게 얘기할 수 있죠. 너네 이거 블루 그룹 차별하는 거 아니야. 이렇게 얘기할 수 있는데 그럼 이제 그냥 똑같이 합시다. 이러면 이제 이 오렌지 그룹 쪽에 사람들이 들고 일어날 수 있죠. 이거 왜 우리는 되는 사람들, 자격 갖춘 사람도 50%밖에 안하고 얘네는 훨씬 많이 되냐. 그럼 이제 사실 별로 네. 별로 할 말이 없는 거예요. 둘 다.
그..
그.. 그럼 이제 문제가 생기는데. 그러면 이제 결론이 뭐냐. 그러면 이제 결론이 이제 그.. 데모그래픽 여기는 이제 두 가지 크라이텔이 나오는데 첫 번째가 좀 더 그.. 어.. 예전에 약간 이게.. 뭐 사실 뭐 두 가지 다 약간 좀 다른 것 같아요. 이제 첫.. 일단 이것부터 시작을 하면은 이거는 이제 그 Threshold를 Threshold는 다르지만은 이 Positive Rate를 맞추는 거예요. 그래서 이 Demographic Parity는 여기 보시면은 Positive Rate가 둘 다 37% 우리는 여기서 얘기하는 건 이제 세 번째 Demographic Parity에서는 우리는 그룹에 관계없이 한 37% 정도의 사람은 한 40% 정도 사람한테 론을 줄 거야. 그럼 됐지. 이렇게 얘기를 하는 거예요. 음 뭐 네 그게 사실은 처음 두 개보다는 왠지 나아 보이는 느낌도 있는데 어 그럼 이제 근데 여기서 이것도 이제 문제가 될 수 있는 거는 그 실제로 로운 어플을 받은 어플 크레딧 월드 이한 사람들을 중에서 생각을 해보면은 보면은 이제 이번엔 제 옐로우 쪽이 훨씬 더 그 레이트가 높죠 론 어플 가 그 말하자면 true positive rate 가 높죠 왜냐하면 옐로우 쪽은 대부분의 사람들이 그래도 월세한 사람들이 더 많이 블루보다는 받은 것 같으니까 이제 마지막 얘기하는 것은 equal opportunity 이게 말하는 것은 eligible 한 사람들 중에서 실제 롬 받는 사람들 그 비중을 똑같이 하자 그럼 이제 opportunity 를 똑같이 준다는 게 이제 마지막에선 이제 자격 있는 사람들한테 중에서 론이 돌아가는 비율이 두 그룹에 같으면 그게 equal opportunity다. 이렇게 얘기를 하는 거죠. true positive rate를 맞추는 거에요. 그래서 여기서 얘기하는 건 제가 사실 이 페이퍼는 안 읽어봤어요. 그래서 사실은 이 motivation 이나 뭐 그 두 개가 정확히 어떤 여기서 이제 얘기하는 거는 이 비주얼 레이저니즘을 보여주는 건 이 두 개가 profit은 비슷하고 그 다음에 이제 그 제가 봤을 때 뭐 비슷해 보이는데 저게 실제로 어떤 컨시퀀스가 있는지 그거는 좀 더 페이퍼를 읽어 봐야 될 것 같아요 예 저 사실 제가 준비한 거는 뭐 뒤에 더 있지만은 사실 뒷부분은 저도 좀 더 이해해야 될 것 같고 여기까지 아마 끊는게 좋을 것 같은데 이게 사실은 어 그래서 뭐 좀 더 한번만 이걸 요약을 하자면은 max profit은 이제 fairness 전혀 고려 안한거고 같은 threshold로 자르는거는 fairness를 그냥 나이브하게 그냥 우리는 같은 threshold로 어 approve를 한다 그러면 이제 실제로는 그룹별 크레딧 스코어 디스트립션이 다르기 때문에 다른 문제를 낳는다는 거죠. 그럼 이제 이걸 해결하는 방법으로 Demographic Parity Equal Opportunity 두 개 나왔는데 이 두 가지가 사실은 실제로 보니까 Fairness Criteria를 실제로 많이 쓰는 거예요. 이게 Independence Separation 이라고 하는데 그 책에서는, 논문에서는 아마 다른 말을 쓸 수 있지만 이 두 가지는 좀 다음 시간에 좀 더 살펴보면 좋을 것 같습니다. 그래서 제 생각에는 논문으로 다음 시간에 컨티뉴 하는 게 어떨까 싶은데 저는 뭐 이정도 하고