Fairness in Search & Recommender Systems
A talk on fairness in search engines and recommender systems. The video covers how these systems can be designed to treat users and content creators equitably, addressing bias in ranking algorithms and visibility distribution.
Chapters
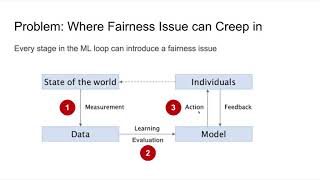
안녕하세요. 저는 김진영이라고 하고요. 우선 한국에서 오신 분들도 많으실 텐데 저도 한국에 있다가 와서 지금 조금 시차 때문에 어질어질 하긴 한데요. 저는 여기서 한 12년 정도 공부하고 그리고 이제 회사에서 일을 했습니다. 지금은 스냅이라는 회사에서 추천 시스템 평가하는 일을 주로 하고 있고요. 그 전에는 이제 마이크로소프트에서 검색 관련 일을 했었고 저는 이제 원래는 이제 논문 쓰고 이제 그런걸 많이 했었는데 요새는 뭐 책이나 아니면 뭐 팟캐스트나 이런식으로 데이터 관련해서 뭔가 그 컨텐츠를 만든다던가 그런거를 조금 하고 있고요 어쨌든 뭐 오늘은 이제 AI에 대해서 조금 말씀을 드릴 텐데 사실은 이제 AI가 굉장히 뭐 핫하지 않습니까 특히 이제 그 여기 제가 얼마나 핫한지 보려고 그 검색 트렌드를 한번 뽑아 봤는데 근데 이제 미국에선 재미있는게 이게 이제 구글 트렌드 결과인데 데이터 사이언스가 아직도 AI보다 더 높아요. 검색 그 볼륨이 어 근데 이제 한국을 보시면은 지금 이게 아시겠지만 이게 처음에 알파고 있었던 때고 이제 그 뒤로 인공지능이 빅데이터를 지금 넘어섰죠. 한국과 미국이 굉장히 다른 트렌드 보이고 있고요. 또 재미있는 건 이제 머신러닝이랑 딥러닝을 검색을 해보면 미국은 머신러닝이 딥러닝보다 아직도 검색 볼륨이 크고요. 한국은 반대에요. 딥러닝이 머신러닝보다 훨씬 볼륨이 커요. 그래서 어쨌든 뭐 우리나라가 굉장히 뭐 그 새로운 기술 트렌드에 민감한 건 좋은 일 같은데 하지만 이제 저는 이제 데이터 사이언스 입장에서 AI를 빌드할 때 너무 이제 보통 AI하면 보통 모델링 생각을 하시는데 데이터 관련의 이슈도 굉장히 생각을 많이 하셔야 된다 뭐 그런 말씀을 좀 드리려고 그 중에 이제 오늘 그 모델 결과의 이제 공정성, 보통 Fairness라고 얘기를 하는데 그 말씀을 좀 드릴 거고요. 예를 몇 가지 일단 보여드리면 Fairness를 생각을 안하고 뭔가 모델을 만들었을 때 여러가지 문제가 생길 수 있어요. 예를 들어서 이게 아마 이건 고쳐진 것 같아요. 지금은 근데 예전에 이제 구글에서 그 트랜슬레이트를 할 때 영어를 터키시로 바꾸고 터키시를 다시 영어로 바꾸면 젠더가 바뀌는 문제가 있었어요. 그게 왜 그러냐면 여러가지 이유가 있겠지만 아무래도 그 직업 디스트리뷰션에서 남자가 닥터인 경우가 더 많으니까 그거를 아마 리플렉트 했을 확률이 크죠. 그래서 그런 상당히 좀 유명한 예제였고 그 다음에 이제 또 다른 예제는 이제 그 미국에서 이제 모델을 만들어 그 범죄 범죄를 저지르는 사람들에 대해서 모델을 만들어서 이 사람이 재범험 확률이 얼마나 될까 그런 모델을 만드는데 여기 보시면 이제 백인 남성과 흑인 여성이 있고 백인 남성의 경우에 훨씬 더 사실 굉장히 많은 뭐 좀 여러가지가 있었어요. 근데 이분이 리스크가 훨씬 낮은 걸로 이제 프레딧트가 됐는데 실제로는 이분이 나중에 범죄를 저질렀고 이분이 범죄를 저지르지 않았다. 그래서 이제 이런 사례도 물론 이거 하나로 이제 일반화 할 수 없지만 어쨌든 요거를 백업하는 굉장히 다양한 사례가 있어요. 그래서 이제 모델을 만들었을 때 이런 뭔가 그 이것도 역시 뭐 흑인들의 범죄률이 그 역사적으로 좀 더 높아질 수도 있죠. 하지만 이제 그렇다고 해서 모델을 이렇게 만들면 사실은 그런 문제가 더 강화될 수 있는 거잖아요. 그래서 이제 그런 고려가 필요하다 이런 거고요. 이제 마지막으로 요 요것도 이제 CEO라고 검색을 해보시면은 대부분이 백인 남성이죠 물론 아닌 경우도 있지만은 근데 이제 요게 그러면은 과연 그럼 어떻게 바꿔야 되나 생각을 해보실 수가 있는데 이거 생각해보면 사실 최근에 제가 그래서 사실 오늘 아침에 다시 해봤는데 지금도 비슷해요 지금도 이제 백인 남성이 거의 나와요 근데 이제 그러면 이게 잘못된 건가 생각을 해보면은 꼭 그렇게 말하기는 어려워요 그쵸? 왜냐하면 그 전체 팝플레이션의 데모그래픽을 따라가야 된다고 생각할 수도 있고 그죠 직업이고 누가 어떤 직업을 해야될지에 대한 특정한 프라이얼이 없다고 생각하면은 그 다음에 이제 그렇지만 뭐 CEO 실제 CEO의 데모그래픽 디스트리뷰션을 따라서 검색 결과가 나와야 된다 이렇게 생각할 수도 있죠 그리고 반대로 또 다른 관점은 이제 사용자들이 클릭을 할 테니까 그 클릭 데이터에 따라서 그냥 결과가 최저가가 돼야 된다 생각할 수도 있고 요게 다 사실은 어느 정도는 뭐 맞는 말이에요 그쵸? 뭐가 틀렸다 맞다 할 수는 없어요 이제 중요한 건 어쨌든 이런 고민을 일단 해야 되고 그 회사들에서 그 다음에 이제 뭔가 펄러시를 정해서 이제 그거를 지켜가야 된다 이런 거죠. 제가 오늘 말씀드리는 거는 뭐 이걸 어떤 퍼펙트 앤서가 있다가 아니라 이런 문제에 대해서 고민을 하는 게 굉장히 필요하다 네 그런 말씀 드리려고 하고요. 그래서 이제 fairness가 ai 중요한 문제인데 그 중에서 이제 저 같은 경우는 주로 검색 추천 시스템의 경험이 많기 때문에 그런 얘기를 좀 더 많이 들으려고 해요. 어쨌든 우선은 바이어스라는 게 이제 페어하지 않은 결과에 대해서 바이어스가 있다고 할 수 있는 건데 바이어스가 이제 문제가 될 수 있는 게 두 가지로 크게 보고 있거든요. 우선은 이제 아까 제가 범죄 저지른 분들에 대해서 재범 확률을 예측하는 걸 말씀을 드렸는데 예측 모델에 따라서 뭔가 그 범죄율이 높을 거라고 해서 그분을 좀 풀어주는 걸 좀 늦춘다든가 아니면 이제 신용대출 같은 거를 값을 확률을 예측해가지고 대출을 해주고 안 해주는 거 이런 경우는 사실은 말하자면 리소스가 어떤 결과에 따라서 불이익을 주는 거죠. 특정한 그룹에 대해서. 그런 거를 이제 어떤 리소스 관점에서 Allocated harm이라는 말을 쓰고요. 그 다음에 이제 다른 거는 이제 예를 들어서 CEO라고 검색을 했을 때 백인 남성이 나오는 거는 그건 이제 어떤 직업군이 특정한 인종이나 아니면 젠더의 연결이 어소시에 되는 거죠. 그런 거 이제 그런 거에 약간 표현의 문제이기 때문에 Representation함이라는 표현을 쓰고 있습니다. 그래서 이 두 가지 주 문제가 바이어스에 따르는 결과로 보통 얘기를 하고요. 사실은 이게 뭐 그러면 어떤 분들은 사람이 해도 어 이런거 문제되는 거 아니냐. 사람이 디지션해도 바이어스가 있고 그런데 왜 우리가 이렇게 문제를 삼아야 되느냐. 근데 사실은 사람이 하는 것도 문제가 있죠. 근데 머신이 하는 거는 사실은 굉장히 이제 뭐 여러가지 문제가 있을 수 있지만 머신을 라지스케일로 할 수 있기 때문에 굉장히 그 문제를 계속 펄펙추에이트 할 수 있다는 거죠. 검색 결과 추천 결과가 사실은 사람들의 이제 인포메이션 컨섬션을 좌우하고 그 컨센션이 또 사실은 계속 그런 결과를 강화시킬 수 있기 때문에 좀 더 큰 문제를 보고 있습니다. 그리고 아까 앞에 발표자분께서 헬스케어에서 주로 백인을 대상으로 실험한 결과가 약물의 부작용이 어떤 데모그래픽에다가 달라지는 결과를 낸다고 하셨는데 사실은 검색 추천에도 비슷한 문제가 있어요. 그건 조금 있다가 말씀드릴 거고 어쨌든 이 자체의 문제도 있지만 이런 모델이 그냥 별 생각 없이 사용이 돼서 10년, 20년이 지났을 때 사회가 어떻게 될 것이냐 그런 관점에서 생각을 하시면 좀 간단한 문제는 그냥 무시할 문제는 아니다. 이렇게 생각하실 수 있고요. 어쨌든 그러면 모델을 만들고 이제 이거를 그 세상에 이제 내놓는데 다양한 관계가 있죠. 거기서 이제 어떤 과정에서 이런 문제가 생길 수 있는지 왜 이런 문제가 왜 생기는지 거기에 대해서 조금 말씀을 드려볼게요. 그래서 이제 머신러닝 아마 여기 모델을 한번 만들어서 만들어보신 분 실제로 몇 분이나 계시나요? 뭐 한 절반쯤 계신다고 생각이 드는데요. 이게 사실은 데이터 컬렉션을 시작을 해서요. 그 다음에 이제 일종의 매저먼트를 할 수 있죠. 뭔가 세상에 이제 그 있는 정보를 이제 뭔가 데이터 형태로 코딩 해가지고 학습 데이터를 만드는 거죠. 그래서 이제 매저먼트를 하고 그 다음에 이제 러닝하고 이벨루이션 해서 모델이 나오고 그게 실제로 사람들한테 쓰여서 피드백을 받고 뭔가 모델이 이토레이션되는 그런 사이클입니다. 그래서 이 각 단계별로 사실은 다 바이어스나 페어리스트 문제가 생길 수 있는 건데요. 우선 첫 번째 단계부터 생각을 해보면 사실은 일단은 데이터, 세상에 있는 대부분의 데이터에는 바이어스가 있어요. 그렇죠? 데이터라는 게 결국에는 세상에 있는 그런 현상을 모은 거고 현상에는 바이어스 있잖아요 그쵸? 그 지금 뭐 직업 선택에서 뭐 남녀 바이어스 있고요 그쵸? 소득에 바이어스 있고 거주지에 바이어스 있고 모든 현상에 바이어스가 있기 때문에 데이터에는 바이어스가 그냥 있다고 봐야 돼요 그쵸? 그리고 이제 또 재밌는 거는 이 바이어스라는 게 계속 변해요 예를 들어서 이제 제가 최근에 안 건데 레이스라는 게 누가 흑인이고 누가 백인이냐 어디서부터 어디 그 라인을 그어야 되냐, 그것 자체도 사실은 그렇게 스테이블하지가 않대요. 시간에 따라서 계속 그 흑인과 백인의 그 데피니션이 바뀌었다. 이런 얘기가 있더라고요. 그런 식으로 세상이 계속 바뀌기 때문에 어떤 카테고리의 정의나 아니면 카테고리의 디스트리뷰션이 계속 바뀐다는 거죠. 그리고 이제 당연히 그 데이터에 보면 피처가 있고 레이블이 있는데 레이블에 바이어스가 있는 경우엔 당연히 이제 모델이 그거 영향을 받죠. 그쵸 만약에 지금까지 어떤 사람의 크레딧 대출을 해줄지 안해줄지는 모델을 만드는데 현재까지 대출해준 데이터를 봤더니 백인워신 대출이 많이 됐어요. 그럼 모델은 그냥 그냥 자연스럽게 백인을 대출을 많이 해줄 거예요. 그렇죠? 그런 식으로 당연히 이제 데이터 자체에 있는 바이어스가 만약에 현실에 그냥 존재하는 데이터를 그대로 썼을 때는 계속 그 모델에 반영이 된다는 거죠. 사실은 데이터 모델 만드시는 분들이 데이터를 굉장히 열심히 봐야 돼요. 아까 또 그 데이터 엔지니어링 하신 그 재현님께서 이제 시각화 중요성 말씀해 주셨는데 그런 데이터를 시각화 다양한 방식으로 시각화 하는게 굉장히 이제 이런 바이어스를 잡는 데 도움이 됩니다. 우선은 데이터가 뭐 어디서 왔는지 또 봐야 되고 그 다음에 이제 그 각 그룹별로 예를 들어 이제 그 바이오스의 이제 여러가지 요인이 있지만은 성별과 예를 들어 나이 이 두가지를 놓고 생각을 한다면은 각 나이랑 성별별로 어떤 데이터 수가 얼마나 되는지 그리고 이제 그 피처 레이블의 디스튜비션이 어떻게 각 그룹별로 다른지 요런거를 다 고려해서 이제 데이터 분석을 했을 때 적어도 이제 이 단계에서 내가 모델을 이걸로 만들면 얼마나 문제가 생길 수 있겠다 뭐 이런 종류의 판단을 하실 수가 있는 거죠 첫번째 단계입니다. 당연히 이제 그 모델을 만드는 모델을 만들고 평가하는 과정에서도 이제 바이어스가 들어갈 수 있죠. 이제 이거는 사실은 근데 모델은 별로 죄가 없어요. 사실 모델이 일부러 내가 남녀차별을 해야지 이렇게 생각하고 동작하진 않아요. 그렇죠? 모델은 죄가 없고 단지 이제 데이터에 있는 이제 그 바이어스를 그대로 반영하는 건데 그럼 이제 어떤 분들은 아 그럼 데이터에서 뭐 성별이랑 그 센세티브한 걸 다 지우면 되잖아요. 그렇죠? 그렇게 생각하실 수가 있는데 사실 그게 그렇게 심플하지가 않아요. 왜냐하면 이제 성별이랑 예를 들어 젠더를 지운다고 해도 다른 attribute이 예를 들어서 이제 다 이제 데이터 변수끼리 다 correlation이 있잖아요. 예를 들어 어떤 특정한 성별의 젠더의 사람들이 그 성별과 이제 레이스의 사람들이 특정한 지역에 모여 산다 그러면 그 사람들의 로케이션이 성별과 지역을 약간 그 젠더를 그러니까 레이스 이미 반영하는 거예요 그래서 그 센시티브한 걸 그냥 지운다고 되는 게 아니에요 그래도 문제가 있어요 이제 그렇게 간단히 뭐 해결되는 문제는 아니라는 말씀을 드리고요 음 그 다음에 이제 말씀드렸듯이 결국에 모델은 데이터 주어진 데이터를 가지고 최적의 결과를 내려고 노력을 하는데 그러다 보면 최적화의 결과는 대부분 항상 다수의 이익을 최대화하는 쪽으로 결론이 나죠. 그래서 말씀을 드린 게 만약에 데이터를 봤을 때 남자가 여자보다 훨씬 데이터의 비중이 크다. 그러면 그 모델은 남자한테 좋은 결과를 내면 이미 한 90%는 맞는 거예요. 그런 의미에서는 그 모델을 만들고 이제 그냥 보통 쓰는 Evaluation을 하면 데이터는 이제 무조건, 모델은 무조건 다수의 이익을 최대화하는 그런 경향을 갖는 결과를 만들거고 그런 의미에서 이제 각 그룹별로 모델의 결과가 어느정도 이제 Accurate한지 보는게 필요하다. 그런 말씀도 드릴 수가 있구요. 그 다음에 이제 모델이 만들어진 다음엔 사실 이거를 배포하고 그 다음에 사용자 피드백을 받는데 이제 모델 여기서는 사실 모델마다 좀 다를 것 같아요. 이제 모델이 예를 들어 검색 추천 모델도 있고 그 다음에 이제 뭐 말씀드렸듯이 신용평가나 이런 다른 유형의 모델도 있는데 대부분은 이제 근데 모델이라는 게 그냥 만들어지고 거기서 끝나는 게 아니라 모델이 만들어져서 배포되면 그 다음에 이제 사용자 피드백이 있고 그 결과가 다시 모델링에 반영이 되죠. 근데 이제 대부분은 그 피드백의 결과가 기존의 모델의 결과를 강화하는 쪽으로 많이 이루어지는 경우가 많아요. 예를 들어서 이제 추천 검색 시스템 같은 경우에는 제일 위에 있는 결과가 뭐 클릭을 많이 받겠죠. 별 생각 없이 만약에 시스템에서 클릭 데이터에 따라서 최적화를 하면은 제일 위에 있는 데이터가 계속 제일 위에 올라가겠죠. 그렇죠? 처음에 이미 피드백을 많이 받았으니까. 그 다음에 이제 다른 그 도메인에서는 이제 어떤 그 이것도 이제 실제 사례인데 범죄 데이터를 지역별로 모아서 범죄 예측하는 모델을 만들었는데 특정 지역에서 범죄가 많이 일어날 거라고 확률을 그 모델에서 확률을 냈대요. 그런데 그 지역에다가 그러면 이 지역이 범죄율이 더 높을 것 같으니까 경찰을 더 투입을 한 거예요. 그럼 그 지역에서 범죄가 더 많이 디텍트가 되겠죠. 경찰이 더 많이 들어갔으니까. 그런 것도 실제 상황에서 그런 경우에는 그 모델에 원래 범죄율이 높았던 지역에 범죄율이 더 높아지겠죠. 그런 식으로 포지티브 피드백 루프가 모델이 실제 세상에 나간 다음에는 생길 수가 있고 그게 계속 모델의 어떤 경향을 강화시키는 쪽으로 일종의 2차 효과가 생기는 경우가 많다고 알려져 있습니다. 그래서 혹시 지금까지 질문 있으신가요? 그러면 이제 그 검색 추천 얘기를 하기 전에 간단히 이제 좀 잘 알려진 론 애플리케이션 이야기를 할 텐데요. 이거는 이제 사람들이 제가 말씀드린 이제 크레딧 어프로벌 시나리오에서 우선은 이제 여기 이제 x축이 이제 그 사람들의 그 크레딧 스코어고 그 다음에 어떤 특정한 모델에서 예측한 스코어죠. 그 다음에 이제 어떤 특정한 그 기준점을 가지고 론을 주는 거예요. 그렇죠? 그리고 이제 거기에는 실제로 론을 받은 다음에 갚은 사람도 있고 안 갚은 사람도 있어요. 이 네 가지 그룹을 이제 이 론 시나리오 가지고 만들 수가 있습니다. 이제 당연히 그러면은 그 비즈니스 측면에서는 그 프로필을 맥시마이즈 하는 쪽으로 결정을 하려고 하겠죠. 근데 이제 그래서 이제 그 보통 이제 이런 여러가지 이제 메트릭을 사용을 하는데 뭐 correctness, accuracy 그 다음에 true positive, false positive, rate 이런 식으로 여러가지 rate가 있는데 근데 그 이제 여기까지는 이제 그런 그 fairness를 고려하지 않은 그런 상황이고 이제 fairness를 고려하게 되면은 만약에 두 population에 대해서 이런 threshold를 정할 때 어떻게 해야 되느냐 이런 고민을 할 수가 있다는 거죠. 여기서 예를 들어서 블루랑 오렌지를 비교해 보면 이제 Threshold가 지금은 같아요. 그쵸? 근데 이제 Blue같은 경우에는 Threshold를 기준으로 해서 왼쪽과 오른쪽 비율이 비슷하고 Orange같은 경우에는 왼쪽이 훨씬 많아요. 그게 의미하는게 Orange Population은 어떤 이유에서든 이제 그 Credit Score가 좀 더 낮다는 거죠. 그쵸? 근데 이제 거기서 우리가 어떤 의사결정을 해야 되느냐. 만약에 이제 어 그룹에 관계없이 다 같은 우리 Threshold를 합시다. 그렇게 할 수도 있죠. 그게 페어하다고 생각하는 사람도 있을 거예요. 근데 이제 그렇게 됐을 때 오렌지 그룹에서 론 어프로브가 안 되는 사람이 훨씬 많겠죠. 왜냐하면 이 사람들은 이 그룹 자체가 굉장히 스코어 디스트리뷰션이 낮기 때문에 그렇게 되겠죠. 그러면 이제 어떤 사람들은 그러면 Threshold를 그룹별로 달리하고 근데 이제 거기서 기준을 이 같은 수의 사람이 론을 받는 걸 기준으로 합시다. 뭐 그렇게 생각할 수도 있어요. 그러면 이제 적어도 어떤 면에서는 이제 결과의 평등이죠. 왜냐하면 이제 같은 수가 론을 어프로브를 받았으니까 그런 것도 어떤 사람들은 이건 잘못됐다 생각할 수 있어요. 왜냐하면 그럼 반대로 블루에 있는 사람들이 더 손해를 본다고 생각할 수 있잖아요. 왜냐하면 이 사람들은 원래 그냥 스코어가 높아서 그런 건데 같은 수를 하려면 이 오렌지 쪽에 더 낮은 기준을 적용을 해야 될 거고 그럼 이제 블루가 오히려 손해다 이렇게 생각할 수도 있어요. 제가 오늘 뭐 그 요거는 이제 제가 아까 그 링크를 보시면 좀 더 자세히 아실 수가 있는데 오늘 말씀드리려는 건 어쨌든 이런 그 론을 만약에 스코어에 따라서 주는 그런 시나리오에서도 굉장히 다양한 시나리오가 있다는 거죠. 그 표현에서 고려하지 않는 경우 어떤 의사결정 기준을 가지고 표현할 경우 그 다음에 결과를 가지고 할 경우 그 다음에 이제 마지막은 그 equal opportunity 라고 해서 론을 마지막으로 갚은 사람 중에서 그 론을 주는 비율을 똑같이 하는 그런 가능성도 있어요. 이제 그건 이제 사실 여기 이 일을 하신 리서치 그룹에서 제안한 방법인데 어쨌든 이 모든 다양한 방법이 있고 이제 거기에서 이제 사실은 뭐 적어도 제 생각에는 뭐가 특별히 다른 거에 비해 훨씬 옳다. 이렇게 생각할 수 있는 거는 찾기 어렵다. 뭐 이런 생각이 들고요. 어쨌든 이제 근데 고려는 해야겠죠. 그렇죠? 이런 디세이션을 아직 하지도 않고 그냥 모델을 만들어 세상에 배포를 했을 때 실제 문제가 생길 수 있다. 그런 생각이 들고요. 혹시 질문 있으신가요? 네. 그래서 이제 지금까지 이제 간단한 이제 클래시피케이션 가지고 말씀을 드렸고 그러면 이제 search and recommendation 시스템에서는 그 바이오스나 fairness 문제가 어떻게 어 일어날 수 있는가. 어 우선은 이제 search recommendation 시스템은 데이터 용량이 일단 훨씬 크죠. 기존의 이제 클래시피케이션이나 이제 그런 문제보다는 어 그 다음에 이제 사실은 보통 이제 서치 레코멘데이션을 좀 통칭해서 인포메이션 액세스를 도와주는 시스템이라고 할 수 있어요. 그쵸? 그러니까 인포메이션을 만드는 사람들이 있고, 인포메이션을 이제 컨슘하는 사람들이 있고, 이 중간에서 약간 매개체 역할을 하는 사람들이에요. 그쵸? 근데 이제 거기에서 사실 바이오스 문제가 굉장히 다양한 형태로 나타날 수가 있는데 우선은 이 프로듀서, 그러니까 만드는 저 문서를 만드는 사람들한테서 바이오스나 페어니스 얘기를 할 수 있죠. 어떤 예를 들어 웹 검색 엔진이 특정한 뉴스 사이트만 굉장히 많이 보여준다 그것도 문제가 될 수 있죠. 그 다음에 이제 어 반면에 이제 컨슈머 입장에서 웹 검색 엔진이 특정한 데모그래픽 한테만 훨씬 좋은 결과를 보여주고 어 그러면 그런 것도 문제가 될 수 있죠. 그리고 이제 마지막으로 이제 토픽이나 아니면 랭기지, 특정한 랭기지, 특정한 주제에 해당하는 검색 결과가 아니면 추천 결과가 더 많이 표시된다 뭐 그런 것도 문제가 될 수 있어요. 그래서 이제 인포메이션 액세스 시스템에서 일반적으로 이제 나타날 수 있는 바이오스 문제가 굉장히 다양하다는 거 이제 그런 거를 일단 말씀드리고 사실은 이제 뭐 어 리걸이나 뭐 법이나 도덕적인 문제가 될 수도 있지만 아까 제가 보여드린 CEO 검색이나 아니면 예전에 어떤 검색인 중에서 흑인 흑인을 검색하면 뭐 고릴라가 나오고 이런 식으로 문제가 된 적도 있었죠. 그런 식으로 이제 검색이나 추천 서비스를 제공하는 사람들한테 이제 레피테이션상 굉장히 큰 문제를 이야기할 수 있어요. 근데 어쨌든 그러면 좀 구체적으로 이런 문제가 어떻게 보이는지 검색 결과를 갖고 좀 얘기를 해보죠. 우선은 이제 여기 오른쪽에 보시는 검색 결과가 남자랑 그니까 이제 리크루터들이 캔디릿을 찾을 때 이런 결과가 나왔다고 가정을 해보죠. 여기서 이제 보시면은 남자 3명이 있고 여자 3명이 있어요. 이제 남자 3명이 여기 보시면은 탑3에 올라가 있죠. 근데 이제 실제 왜 이런 검색 결과가 나왔나 생각을 해보면은 이게 이제 만약에 그 이 사람들이 검색 엔진에서 얻은 스코어라고 생각해 보면은 스코어에는 거의 차이가 없어요. 그쵸? 근데 이제 남자들이 스코어가 조금씩 높아요 그쵸 여자보다 그래서 이제 탑3가 됐고 근데 이게 실제로 사용자들의 이제 사용 패턴을 보면은 위에서 아래로 스캔을 하기 때문에 이 굉장히 스코어 차이는 0.03 인데 그 exposure 즉 얼마나 많은 사람들이 검색 결과를 이제 사용하는지 즉 이제 얼마나 많은 사람들이 리크루터들이 이 캔디디한테 연락을 하는지 그 관점을 생각해 보면은 한 30% 이상 차이가 난다는 거예요 그래서 이게 사실은 이것도 이제 빼아냈으면 문제죠. 그쵸? 실제로 뭔가 30% 이상 그 잡 캔디디사의 포텐셜이 차이가 나는 게 아닌데 리크루터들이 30% 이상 덜 컨택을 한다는 얘기니까 문제가 되는 거죠. 그쵸? 그리고 이제 말씀드렸듯이 요건 이제 첫 검색 결과고 만약에 요 검색 엔진에서 클릭 클릭 데이터를 가지고 또 옵티마이즈 한다 그러면은 차이가 더 벌어지겠죠 그쵸 왜냐하면 첫 검색 결과가 위에 올라간 사람들이 이제 클릭이 더 많이 될 테니까 그렇게 생각하면 이제 간단한 문제가 아니에요 그쵸 어 그래서 실제로 이런 검색 결과가 문제가 있고 그 다음에 이런 문제를 예를 들어 뭐 Top 5에 적어도 몇 프로 이상 여성을 넣는다 이런 식으로 Constraint를 넣는게 한 가지 해결책이 될 수 있는데 그런 식으로 굉장히 다양한 해결책이 실제로 제한이 되고 있습니다. 어 그 다음에 그 다음에 방금은 이제 그 검색 결과에서 어떤 그 결과 이제 이제 분포에 대해서 말씀을 드렸는데 결과 이제 퀄리티 역시 그 데모그래픽 별로 차이가 날 수가 있어요 이제 이게 아까 그 메디컬 시나리오에서 특정한 약이 특정한 데모그래픽에 대해서 부작용이 더 많다 약간 이런 거랑 비슷한 건데 여기 보시면은 이제 이게 검색 age 그룹별로 이 왼쪽 차트는 검색 결과의 차이, 퀄리티의 차이예요. 여기 보시면은 매트릭이 몇 개가 있는데 공통적으로 나타내는 것은 데모그래픽, 그러니까 age가 더 많은 그룹에 대해서 검색 퀄리티가 더 안 좋은 결과를 나타내고 있습니다. 그래서 이게 의미하는 것은 검색 결과가 조금 더 젊은 파퓰리션의 사용 패턴에 따라서 최적화가 되어 있다. 이게 사실은 이것도 문제라는 거죠. 그러면 이제 나이 드신 분들이 검색엔진을 덜 사용하는 결과를 낳을 수도 있고 또 그런 패턴이 더 강화될 수도 있고 그 다음에 이제 다른 연구에서는 추천 시스템 역시 비슷한 결과가 있었어요. 그래서 추천 시스템을 평가를 했더니, 이것도 마찬가지로 Y축은 추천 시스템 퀄리티고, X축은 여기서 Female, Male 이렇게 성별로 나누어지는 데모그래픽 그룹인데, 남자 여자가 이제 좀 차이가 있어요. 그쵸? 여기 보시면은 여기는 이제 메일이 조금 높고 여기는 이제 p메일이 좀 높고 그런 식으로 이제 차이가 있어요. 그게 의미하는 것은 여기서도 이제 남녀 성별에 따라서 추천 시스템을 썼을 때 얼마나 이제 인포메이션 액세스가 되는지 정도가 달랐다는 거죠. 어 그 다음에 이제 마지막으로 아까 제가 ceo 사례를 말씀드렸는데 다른 연구결과를 보면 이것도 이미지 검색에서의 사례인데, 맨을 넣고 검색을 한 다음에 이미지의 성격을 보고 워맨을 넣고 검색을 한 다음에 성격을 보면 남자를 넣고 검색을 했을 때 훨씬 더 좀 더 파워를 서제스트하는 그런 결과가 많이 검색이 된다. 그래서 이제 젠더의 어떤 스테레오 타입 그런 게 이제 이런 다양한 디멘션에서 여기 보시면 이게 다 다양한 이미지의 여러 가지 특성인데 이 모든 디멘션에서 이제 남자가 좀 더 적어도 파워 관점에서는 더 파스티브한 결과를 많이 리턴한다 그쵸? 검색 엔진에서 그런 걸 알 수가 있고 어쨌든 이런 검색 추첨 결과에서 굉장히 다양한 형태로 바이어스가 나타나는 것을 제가 보여드렸고요. 그러면 이 문제를 어떻게 해결할 수 있느냐? 아까 그 검색 AI 시스템의 어떤 개발 단계로 돌아가서 데이터가 만들어지고 모델을 만들고 모델이 실제 적용되고 요 세가지 걸 말씀을 드렸죠. 이 세가지 경험에서 다 이제 해결책이 있어요. 그래서 이제 다 살펴볼 수는 없지만은 몇 가지를 지금 살펴볼 거구요. 우선 이제 데이터 처리 관점에서는 뭐 데이터를 필터링 할 수 있죠 그쵸? 예를 들어 뭐 남자 이미지가 너무 많이 나와 그럼 남자 이미지를 좀 필터 해버리면 되죠 그쵸? 근데 이제 사실은 어 검색 추천 시스템은 데이터가 너무 크고 그 다음에 이제 사용자들이 실제로 보는 이미지가 몇 개 결과는 몇 개 안되기 때문에 러 데이터를 필터링 하는 건 사실 별로 효과가 없을 거에요 음 그래서 이제 어 이렇게는 별로 안하고 그 다음에 이제 레이블 이제 이런 검색 추첨 결과 보통은 이제 레이블을 가지고 이제 트레이닝이 되는데 어떤 결과가 이제 좋은 결과인지에 대한 레이블이죠. 근데 이제 이 레이블 자체에 이제 바이어스가 있다는 이제 그런 파인딩이 있다면은 뭐 당연히 모델에도 바이어스 있겠죠. 그래서 이제 레이블 같은 경우엔 굉장히 좀 자세히 봐야 될 거고 그 다음에 이제 랭킹 피처 같은 경우에도 이제 요새는 사실은 뭐 그냥 그 raw word count를 쓰는 게 아니라 인베딩 같은 걸 많이 만들어서 이제 랭킹 피처를 사용을 하죠. 이제 그런 경우에도 바이어스가 있을 수 있고 그 다음에 그거를 이제 없애는 결과가 좀 있어요. 그래서 그걸 하나 소개를 해드리면은 이제 워드 인베딩을 만들었더니 She랑 he 이 두 단어에 어소세이드 되는 단어들이 이렇게 차이가 난다. 그렇죠? 여성 같은 경우에 홈메이커, 널스, 남성 같은 경우에 필라서퍼, 파이낸스, 이런 식으로 어소세이드는 굉장히 다르다는 거죠. 그 이런 단어의 뉘앙스를 이렇게 파악하고 검색 추천을 만들면 당연히 그런 바이어스된 결과가 나오겠죠. 그렇죠? 그래서 실제로는 이런 그 문제 해결하는 방법 여러가지가 있겠지만은 우선은 좀 컨셉추얼리만 말씀을 드리면은 모든 단어를 she랑 he의 축에 놓고 볼 수 있겠죠. 예를 들어 she에 해당하는 것은 이제 actresses, feminist, 여기 homemaker가 있네요. 그렇죠? 이런 식으로 단어를 다 이 디멘션에 놓고 볼 수가 있는데 우리가 원하는 것은 이런 홈메이커 같은 직업 관련된 단어가 이 디멘션을 이쪽에 치우친 게 아니라 이게 가운데로 가면 되죠. 그렇죠? 그게 의미하는 것은 적어도 성별 관점에서는 이 단어의 바이오스가 제거됐다 이렇게 생각할 수 있기 때문에 그런 걸 이제 말하자면 뉴트럴라이즈 하는 거죠 단어를. 그래서 이런 그 디멘, 그러니까 어떤 워드 임베딩의 그 원래 결과가 있으면은 여기서 이제 좀 직업 관련된 단어를 예를 들어서 이제 가운데로 뉴트럴라이즈 하는 그런 기법이 제시가 됐어요. 그래서 이제 그 제가 이 논문에서 이제 가져온 그런 플랫인데 이제 한 가지 방법인 거죠. 그 인베링에서 바이오스가 발견됐다. 그러니까 우리가 그걸 없애버리자. 그런 식으로 이제 그런 바이오스 해결하는 방법은 제가 말씀드렸듯이 데이터 모델을 만들기 전에 데이터 프리 프로세싱 단계에서 바이오스를 없애는 과정이고요. 그 다음에 이제 프리 프로세싱을 넘어서 모델을 만드는 과정에서 바이오스 없앨 수도 있죠. 예를 들어서 이제 모델이 여러가지 고려사항을 가지고 최적화가 되는데 최적화의 그 Constraint 중에 그 fairness를 거기에 넣을 수가 있겠죠. 그래서 모델을 만들 때 보통은 이제 어떤 특정한 loss나 어떤 그 accuracy metric을 최적화하는 그런 식으로 트레이닝을 하겠지만 거기다가 하나 더 넣는 거예요. 그래서 이제 이런 거를 보통은 Constraint Optimization이라고 옵티메이징을 하는데 기준이 여러가지가 있는거죠. 정확한 결과가 나와야되고, 빼앗은 결과가 나와야되고 이런걸 다 넣어가지고 최적화를 하는 방법이 있고 그 다음에 다른 어프로치는 모델은 일단 Accuracy 가지고 만들고 그 다음에 이제 그거를 다시 Calibrate 하는 그런 방법이 있어요. 그건 이제 모델링이랑 그 다음에 Fairness 이 두 가지를 분리하는 과정이죠. 그 두 가지가 다 가능한데요. 첫 번째는 이제 뭐 전체 파이프레이는 단순해지지만은 모델 자체는 더 복잡해지죠. 여러가지를 다 고려해서 만들어야 되니까 그리고 이제 어떤 모델을 쓸 수 있는지가 좀 제한이 될 수 있고 두 번째는 좀 더 그 모델 자체는 더 단순해지는데 전체 그 파이프라인도 복잡해지고 그런 이제 트레이드 오프가 있어요. 그래서 이거는 뭐 둘 중에 뭐가 더 낫다 말하기는 좀 어려운 부분이고요. 어쨌든 그 캘리브레이트 하는 그런 어프로치를 하나만 소개를 해드리면 아 예. 이거는 사실은 그 fairness 보다는 약간 더 그 도메인 도메인 그 top pick 도메인에 따라 따라서 이제 constraint를 주는 건데 만약에 내가 그 두 가지 예를 들어서 카테고리에 대해서 60대 40 이런 식으로 만약에 constraint를 주고 싶다 그러면 이제 모델에다가 이제 constraint를 주고 결과를 이제 봤더니 뭐 여기서 이제 빨간 라인은 컨스트레이트를 안 준 거고, 그 다음에 녹색 라인은 컨스트레이트를 준 거고, 이제 블랙 라인이 실제 유저의 프레퍼런스인 거죠. 보시면 이제 컨스트레이트를 준 경우에는 유저의 프레퍼런스가 훨씬 더 얼라인되는 결과를 볼 수 있다. 지금 시간 관계상 자세한 설명을 생략하고요. 어쨌든 그냥 만약에 모델 결과 문제가 있으면 그걸 후처리 해가지고 해결할 수가 있어요. 그런 교훈이고, 마지막으로 이제 그 모델을 그냥 만들어서 배포하진 않거든요. 보통은 Evaluation을 하는데 Evaluation, 이제 Fairness에 대해서 Evaluation을 할 수가 있죠. 이제 그런 것도 사실은 내가 그럼 만약에 그 앞 두 단계에서 Fair하게 모델을 만들었다. 그러면 이제 얼마나 Fair한지 봐야겠죠. 그 중에 이제 한 가지 모델, 이제 이벨레이션 메트릭은 그러니까 말하자면은 뭐 탑 10에 예를 들어서 뭐 남성, 여자, 여성이 있는데 그게 이제 얼마나 내가 아이디어라고 생각하는 디스튜비션과 매치하는지 이제 그런거를 이제 이벨레이션하는 여러가지 크라이테리가 있어요. 거기에 이제 그냥 좀 유메리칸 메소드를 쓸 수도 있고, 프로볼리스틱한 메소드를 쓸 수도 있고, 이제 그런 variation이 있지만 결국에 하고자 하는 것은 내가 어떤 특정한 그 attribute 즉 젠더에 대해서 결과의 fairness를 보장받고 싶으면 이 metric을 사용하면 얼마나 fair한지에 대한 결과를 알 수 있다. 그런 거죠. 네 그래서 제가 이게 마지막 슬라이드인데 그 머신러닝 특히 이제 제가 search recommendation 말씀을 드렸는데 결과가 이제 굉장히 다양한 어 fairness 이슈가 있을 수 있다. 그 다음에 이제 뭐 the allocated and representational harm 이 두 가지를 주로 말씀드렸고요. 그 다음에 이제 이게 그냥 그냥 그 액면가로 그냥 끝나는 게 아니라 굉장히 좀 장기적인 문제가 있다는 거죠. 어떤 특정한 그 바이오스에 계속 강화되는 그런 효과가 있다는 거죠. 그 다음에 이걸 해결하는 방법은 뭐 데이터 선처리, 그 다음에 모델링, 그리고 데이터 후처리, 그 다음에 이베이루에이션 이 전 단계에 걸쳐서 다양한 솔루션이 있기 때문에 이 문제를 인지를 하고 그 다음에 이제 뭐 특정한 제가 오늘 여러가지 말씀 드렸지만 그 중에 뭐 어떤 방법을 써야 된다 이렇게 말씀드리진 않았죠. 단지 문제를 인지하고 이제 뭐 회사라면 회사 아니면 어떤 정부라면 정부 뭔가 펄리티를 만들고 그거를 이제 임펠스하는 그런 아웨어리니스가.