온라인 서비스 개선을 데이터 활용법 - 김진영 (How We Use Data)
Kim Jin-young explains how to collect data for improving online services: user logs, panel surveys, and direct feedback. He covers tradeoffs like signal quality and cost, uses examples from Bing, Facebook, and Netflix, and shows how to pick the right combination of methods for your service.
Chapters
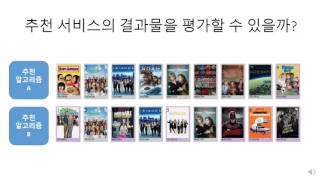
안녕하세요. How We Use Data 두 번째 발표를 맡은 김진영입니다. 데이터를 그냥 바라보는 게 아니라 실제로 해보는 것에 초점을 맞춘 행사라는 측면에서 굉장히 뜻깊은 자리라는 생각이 들고요. 그리고 제가 미국에 있는 관계로 제 발표를 비디오로 대신하게 되었는데 이 점 양해 부탁드립니다. 네, 그럼 발표 시작하겠습니다. 네. 이번 행사 제목이 우리가 데이터를 쓰는 법인데요. 전 사실 오늘 데이터 수집에 초점을 맞춰 볼까 합니다. 데이터를 가지고 일을 해보신 분들은 공감을 하시겠지만 제대로 된 데이터가 있으면 사실 일을 가공하는 것도 사용하는 것도 상대적으로 쉽습니다. 그래서 저는 그 데이터 활용에 있어서 가장 큰 장벽이 된다고 생각하는 수집을 다뤄볼까 합니다. 본격적인 논의에 들어가기 전에 온라인 서비스 개발의 단계별 이슈를 한번 생각해 봅시다. 우선 서비스 개발이라면 계획, 구현, 평가의 3단계를 생각해 볼 수 있는데요. 각 단계별로 다양한 이슈가 있을 겁니다. 우선 계획 단계에서는 비즈니스 목표를 설정하고 그리고 목표 달성에 의한 방법을 정확하게 설정을 해야겠죠. 그리고 이제 구현 단계에서는 보통 온라인 서비스라면 데이터 기반의 검색 및 추천 기능이 들어가기 마련인데요. 이런 기능을 어떻게 구현할 수 있을까? 그리고 이런 기능의 구현은 보통 학습 및 평가 데이터가 필요한데요. 이런 데이터를 어떻게 모을 수 있을까? 그리고 이제 구현된 데이터를, 구현된 기능이 사용자에게 보여지기 전에 어떤 결함이 없을까? 그런 부분을 고려해야 될 거고요. 그리고 마지막으로 기능을 넣었을 때 이 기능에 과연 사용자가 만족하는지 원하는 반응이 나오는지 그리고 이제 궁극적으로 비즈니스 목표가 얼마나 달성되는지 이런 것들이 모두 서비스 개발의 이슈라고 할 수 있습니다. 그런데 이런 문제들은 까지 보면 다 데이터 문제예요. 즉 이런 문제를 해결하기 위해서는 데이터가 필요하다는 거죠. 여기서 말한 데이터는 서비스의 불만족, 만족에 대한 데이터 그리고 학습 모델을 만든다면 이를 만들고 평가하기 위한 데이터 그리고 서비스의 장애나 결함 혹은 새로운 기능의 효과를 측정하기 위한 데이터 등이 모두 포함됩니다. 이렇게 다양한 데이터가 서비스 개선에 사용될 수 있는데요. 여기서 사실 핵심은 우리 서비스에 대한 고객의 반응이 무엇인가 과연 고객이 만족하는가 그런 부분이 사실 가장 어렵고 핵심적인 부분이라고 할 수 있습니다. 그래서 이런 데이터를 어떻게 수집할 수 있을 것인가 그것이 저희 발표를 통해 알아보고자 하는 부분입니다. 우선 이해를 돕기 위해서 식당을 한번 예를 들어 볼게요. 식당 서비스 개선을 위해서 어떻게 데이터를 수집해야 될까요? 우선은 고객의 행동을 관찰하는 것을 생각해 볼 수 있겠죠. 고객이 어떤 표정이고 어디를 보고 있는지 그리고 남기는 잔반의 양과 종류가 어떻게 되는지 그리고 식사의 속도가 어떤지 그런게 사실은 다 고객의 만족도를 유추할 수 있는 어떤 근거가 됩니다. 하지만은 이렇게 얻을 수 있는 행동에서 얻을 수 있는 데이터의 종류에는 굉장히 제한적이고요. 그리고 노이즈가 많겠죠. 사람마다 식사 속도도 다를 거고 잔반의 어떤 그런 것도 다를 테니까요. 데이터를 행동 데이터를 모아서 의미 있는 결론을 내리려면 굉장히 데이터가 많이 필요합니다. 그리고 행동을 기반으로 만족도를 유추한다는 거에는 항상 문제가 있습니다. 굉장히 만족했는데도 그날 배가 부르면 남길 수 있는 거고요. 이런 식으로 행동 데이터가 굉장히 좋은 점이 있지만 이런 한계가 있습니다. 그래서 이런 문제를 해결할 수 있는 방법이 실제로 사람들한테 물어보는 겁니다. 여기에 사용되는 방법을 보통 패널 서베이라고 하는데요. 패널 서베는 고객의 의견을 대표하는 패널을 고용하여 그들의 의견을 청취하는 겁니다. 고객에게 직접 물어보기가 사실 쉽지 않은 경우가 많기 때문에 패널을 보통 사용하는 건데요. 예를 들어 음식점의 경우에는 여기 패널설베이에 사용한 자료에 얘가 나와있는데 음식에 대한 만족도 그리고 청결 혹은 시설에 대한 만족도를 이런식으로 다 문학을 만들어서 평가를 받는 겁니다. 이런 설베를 사용하면 당연히 굉장히 상세한 데이터를 얻을 수 있을텐데요. 하지만 이런 패널설베이는 직접 고객에게 얻는 데이터가 아니기 때문에 데이터가 어떤 품질면에서 고객에게 얻는 데이터와는 좀 다를 수 있습니다. 그래서 이 두가지 지금까지 데이터 수집 방법을 알아봤는데요. 사실 이 방법들은 온라인 서비스에도 상당 부분 적용할 수가 있습니다. 우선은 사용자 로그 분석은 이제 다들 아실 텐데요. 사용자 로그에서 이제 온라인 서비스의 경우에도 다양한 시그널을 추출할 수가 있죠. 그리고 이제 이런 행동기반의 데이터는 말씀드린대로 수집에 비용은 없지만 사실 범위나 품질에 제약이 많습니다. 그리고 이제 사용자층이 어느정도 두터워야지 사용할 수 있는 방법이겠죠. 반면에 패널설베이는 패널설베이 회사를 이용하거나 아니면 패널을 직접 고용해야 되는데요. 사실 패널을 사용하면 서비스의 모든 품질에 대해서 자세한 피드백을 받을 수 있죠. 하지만 이제 말씀드린 대로 패널 고객 대신에 패널을 사용하는 것이기 때문에 어떤 데이터 품질의 문제나 아니면 비용이 발생할 수 있다는 점. 이 두가지 어떤 약간 보완적인 서로 다른 장단점을 가지는 방법들입니다. 여기서 이제 이런 궁금증을 가질 수 있는데 사용자에게 직접 물어보면 안되나? 이것도 가능합니다. 사용자 피드백이라고 하죠. 사용자에게 실시간으로 피드백을 요청하는 겁니다. 예를 들어 검색 결과를 보여주고 이게 맘에 드니? 맘에 들지 않니? 하지만 이렇게 했을 때 보통 응답률이 낮은 경우가 많고요. 온라인으로 서베이 요청하면 보통 많이들 이제 그냥 무시하시잖아요. 너무 많이 하면 사용자를 귀찮게 할 수도 있죠. 그래서 일반적으로 많이 쓰이진 않구요. 단 예외가 어떤 서비스의 내용 및 품질이 계속 개인화되어야 되는 추천 서비스의 경우에는 사용자들이 실제로 피드백을 많이 줘요. 왜냐하면 피드백을 줘야지 자신이 더 좋은 서비스를 받을 수 있으니까요. 영화 추천 사이트 같은 데 보면 넷플릭스 같은 사이트 보시면 별점을 실제로 사용자들이 많이 합니다. 그리고 이거를 서비스 계산을 사용하고 있고요. 그래서 이제 사용자 피드백은 아래 그림 보시는 것처럼 패널 서베이와 사용자 로그의 어떤 장점을 결합하는 하지만 이제 모든 경우에 사용 가능하진 않은 그런 방법이라고 할 수 있습니다. 지금까지 서비스 개선을 위한 데이터 수집 방법을 살펴봤는데요. 이제 실제 온라인 서비스 기업에서 어떻게 이런 방법을 결합해서 데이터를 수집하는지 한번 살펴봅시다. 우선은 검색 서비스 사례를 한번 살펴보겠습니다. 제가 마이크로소프트 빙에서 일하고 있기 때문에 저의 업무 영역이기도 한데요. 아시는 대로 검색 서비스 개선을 위해서는 다양한 실험 기법이 사용되는데 개발 초기에는 패널을 통해 수집한 레이블을 사용합니다. 이런 레이블은 재사용 가능하다는 측면이 있어서 굉장히 많은 알고리즘을 비용을 많이 들이지 않고 평가할 수 있는 장점이 있는데요. 어느정도 이렇게 초기 실험을 해서 좋은 어떤 알고리즘이 발견된 경우에는 이제 사용자 데이터를 사용해서 실제 실험을 합니다. 지금 여기 보시는 그림이 구글에서 공개한 실험에 대한 통계 데이터인데요. 약 12만건의 알고리즘 개선 아이디어가 있었고 그중에 만건, 칠천건 이런 식으로 다양한 실험을 거쳐서 마지막에 600건을 실제로 서비스에 반영했다는 그런 사례를 보여줍니다. 검색만큼이나 요새 많이 사용되는 서비스가 소셜네트워크인데요. 페이스북에서도 어떤 식으로 데이터를 활용하는지에 대한 자료를 최근에 공개를 했습니다. 우선은 페이스북의 서비스 초기에는 사용자의 로그만 사용했다고 해요. 사용자들이 어떤 포스트에 머물고 어떤 포스트에 클릭을 하고 그런 부분에만 사용했었는데 최근에는 로그의 패널 그리고 피드백 등의 모든 방법을 사용한다고 합니다. 여기 지금 페이스북의 어떤 프로덕트 디자인 부사장이 Quora라는 웹사이트에 올린 답변인데요. 보시면 페이스북 피드랭킹에 로그와 함께 서비와 피드백을 추가로 사용함으로써 원래 클릭을 유도하는 어떤 콘텐츠 예를 들어 뭐 세상을 바꾸는 10가지 방법 이런 거죠. 이런 컨텐츠가 굉장히 사회에 노출됐었는데 이런 것보다 실제로 사람들이 만족하는 컨텐츠를 설베이나 피드백을 통해서 찾을 수 있었다는 거죠. 그리고 마지막으로 이제 추천 서비스의 사례로 넷플릭스가 이제 대표적인데요. 넷플릭스는 사실 검색도 하고 추천도 하지 않습니까? 그래서 검색을 하는 경우에는 아까 말씀드린 패널 데이터 사용하고요. 그리고 사용자 노브 데이터를 같이 사용하고요. 그런데 이제 흥미롭게도 추천 서비스에 대해서는 패널을 사용하지 않고 실제 사용자 피드백과 로그에 의지한다고 합니다. 이게 최근에 넷플릭스에서 공개한 논문에 나오는 내용인데요. 여기 이제 그림은 넷플릭스에서 어떤 추천 모델을 만들고 평가하는 과정에 대한 그림입니다. 자세한 것은 논문 참조하시고요. 그런데 그 추천 서비스의 결과물을 패널이 아닌 사용자를 통해서 평가를 해야 하는가. 그건 사실 추천 서비스가 굉장히 개인화된 그런 서비스의 특성에서 기인하는 건데요. 여기 보시면 두 가지 추천 알고리즘에서 나온 결과가 있습니다. 위의 결과를 보시면 알고리즘 A, 아래의 결과는 알고리즘 B에서 나온 건데요. 이게 사실은 그 논문에 나온 사례인데 저자의 자신의 어떤 추천 결과라고 해요. 그런데 이제 이 사람이 자기 자신의 그 영화 성향에 대한 추천 결과도 스스로 판단하기 어렵다는 거죠. 위가 나은지 아래가 나은지. 그래서 이제 결국에는 이런 거를 패널을 통해 평가를 하기보다는 실제 사용자 행동을 보든지 아니면 실제 사용자에게 영화 각각을 여기 이제 영화 전체를 목록으로 물어보는 게 아니라 영화 각각을 평가하게 해서 그 알고리즘을 이제 합첩시키고 평가한다는 겁니다 그래서 여기서 지금까지 이제 다양한 데이터 수집 방법을 살펴보았는데요 어떤 수집 방법을 사용할 것인가에는 여러가지 선택 기준이 있을 겁니다. 우선은 서비스의 특성이 있을 건데요. 아까 보여드린 대로 서비스마다 다 특성이 달라요. 어떤 서비스에서는 클릭을 사용자가 많이 하고 어떤 서비스에서는 클릭이 없는 대신에 스크롤이나 브라우징 같은 게 많을 수도 있고요. 이런 행동 패턴에 따라서 관찰 가능한 정보가 달라진다는 겁니다 그래서 이제 그거를 고려해서 로그 데이터에서 어떤 시그널을 추출할 수 있을 것인가 그런게 나올 거구요 그리고 만약에 사용자에게 피드백을 얻고자 한다면 사용자가 피드백을 줬을 때 얻을 수 있는 인센티브가 무엇인가 사용자에게 좋아지는 게 있어야 어떤 피드백이 오겠죠 그런 고려사항 그리고 이제 수집의 가능성 측면이 있는데요. 수집이 과연 가능한가? 예를 들어서 사용자의 로그 데이터는 액티브 유저가 어느 정도 규모가 있지 않으면 수집 자체가 불가능합니다. 그리고 이제 패널 같은 경우에는 사용자의 경험을 패널이 대신해 줄 수 있는 경우가 있고 없는 경우가 있죠. 방금 말씀드린 추천 서비스 같은 경우에는 패널을 사용하기 어려운 경우입니다. 그리고 이제 마지막으로 수집 비용이란 측면에서 충분한 사용자 확보를 위한 마케팅 예산이 있는가. 만약에 사용자의 로그 데이터를 사용하고 싶다면. 그리고 이제 패널 서베를 위한 예산이 있는가. 이제 그런 예산 측면을 생각해 볼 수 있어요. 이런 고려 사항이 모두 이제 고려가 돼서 이제 적절한 데이터 수집 방법을 선택하고 조합하는 겁니다. 그래서 지금까지 데이터 수집을 위한 다양한 방법을 살펴봤는데요. 그렇다면 이제 제가 일하는 분야인 검색 엔진의 품질을 어떻게 평가해야 될까 이 부분을 좀 더 자세히 살펴보도록 하겠습니다. 좀 구체적으로 살펴보면 우선 사용자 행동 혹은 로그 데이터를 가지고 평가하는 것을 생각해 볼 수가 있습니다. 그런데 사실은 여기 각각의 한계가 있어요. 예를 들어서 어떤 결과에 클릭했는가 그런 걸 본다고 하면은 사실 클릭하지 않은 결과가 무조건 나쁜 건 아니거든요. 오른쪽에 보시면은 그 클라우스소싱 이라고 어떤 정보가 나와있죠. 이런 정보는 그냥 읽고 넘어가잖아요. 그리고 이제 클릭한 결과 얼마나 머물렀는가 이제 그런 것도 볼 수가 있는데 사실 오래 머물렀다고 반드시 좋은 말 아니거든요 문서가 읽기가 어려워서 오래 머물 수도 있으니까요 그리고 이제 마지막으로 이제 좀 길게는 사용자가 재방문했는지를 볼 수가 있는데 재방문과 만족도가 꼭 상관관계에 있으리라는 부분은 없습니다. 그래서 이제 여기서 말씀드릴 수 있는 것은 사용자 행동이 중요한 단서이긴 하지만 결과의 품질을 모두 말해주지는 않는다는 겁니다. 그래서 이제 같은 결과를 패널 서비스로 평가해 볼 수도 있을 텐데요. 지리오가 여기서는 클라우스 솔싱이라는 단어인데 이 결과에 대한 오른쪽 결과를 평가한다면 이런 식으로 이제 패널을 고용을 해서 물어볼 수가 있겠죠. 그리고 이제 선택지를 4개를 주고 이유를 물어볼 수 있겠습니다. 여기는 어떤 문제가 있을까요? 우선은 지리어 자체를 평가자가 이해를 못할 수도 있죠. 그리고 이제 지리어가 크라우소싱 이었는데 크라우소싱 이란 단어를 가지고 사용자가 어떤 정보를 찾고 있는지 이걸 상상을 해야 되는데 상상하기가 쉽지 않을 수가 있습니다. 그리고 이제 앞에 보셨지만 검색 결과가 굉장히 여러가지 부분이 있는데 이 중에 일부는 맘에 들고 일부는 맘에 안 들 수도 있죠. 그런 경우에 전체를 어떻게 평가해야 될지가 명확하지 않습니다. 이제 그런 문제점을 해결하는 방법이 여러가지가 있을텐데 우선은 그 검색 결과 전체를 보여주는 대신에 문서 하나만 보여주는 방법이 있겠죠. 그래서 오른쪽은 지금 위키피디아 페이지 하나만 검색 결과에 들어있던 이 페이지 하나만 가지고 이게 얼만큼 좋은지 이렇게 하면 조금 더 그 명확한 어떤 평가가 가능할 거고요. 다른 방법은 그 검색 결과 전체 페이지 전체를 만약에 비교를 하고 싶다면 두 검색 결과를 왼쪽 오른쪽으로 보여주고 이걸 저희가 Side-by-Side 디자인이라고 하는데 왼쪽이 좋은지 오른쪽이 좋은지 그걸 평가를 받는 겁니다. 이렇게 되면 좋은 것은 사용자가 절대적으로 어떤 검색 결과가 좋은지 나쁜지는 기준은 세우기가 쉽지 않지만 왼쪽과 오른쪽의 우열은 좀 더 명확하게 비교할 수 있다는 거죠. 그래서 이런 여러가지 데이터 수집 방법을 살펴 보았는데요. 사실 고품질의 패널 설베이 결과를 얻기 위해서는 굉장히 고려사항이 많습니다. 우선은 패널이 고객을 대표해야 되는데 그러려면 고객군과 유사한 특성을 가진 패널을 고용해야 될 거고요. 패널 구성원이 정확히 어떤 질문을 이해하는지 그런 것을 알아야 될 겁니다. 여기에는 이제 답변의 정직성 및 품질을 평가해야 되는 필요가 있는데요. 그리고 이제 마지막으로는 패널 구성원들이 작업을 하는 데 있어서 적절한 인센티브, 좋은 결과를 예를 들어 내는 사람들에게 더 좋은 보상을 준다든지 하는 여러가지 인센티브를 생각해 볼 수가 있습니다. 그래서 여기까지 저는 이번 발표를 통해서 데이터 사용을 하기 전에 제대로 된 데이터 수집 방법을 좀 고민해보자 이런 메시지를 좀 드리고 싶었고요. 여기서는 패널 서베이, 사용자 로그, 그리고 사용자 피드백 등 여러가지 제가 말씀을 드렸는데 이런 방법들은 서비스 특성 및 개발 단계에 따라서 적절히 조합해서 사용을 해야 된다. 그리고 패널 서베이는 좀 익숙하지 않은 분들도 있을텐데 사실 굉장히 그 사용자 그 행동 기반의 방법을 단점을 보완한다는 측면이 굉장히 좋은 방법인데요. 여기서도 이제 다양한 고려사항, 즉 서베 디자인, 패널 선발 및 교육, 결과 평가 및 보상 등의 고려사항이 제대로 이루어져야 된다는 겁니다. 네 뭐 제 발표는 여기까지 좀 더 상세한 이야기를 원하시면 제가 홈페이지에 공개한 다양한 글을 참조하실 수 있구요. 그리고 검색 관련해서는 제가 작년에 SIGIR 학회에서 발표했던 튜토리얼의 슬라이드를 또 여기 링크해 놓았습니다. 그리고 이제 데이터 과학 입문에 대한 좀 더 상세한 전반적인 소개는 제가 최근에 쓴 책인 헬로 데이터 과학을 참고하시면 됩니다. 네 저는 여기까지구요. 감사합니다.