SM-Pair Conference Keynote: 인공지능 시대의 빛과 그늘, 그리고 데이터 리터러시
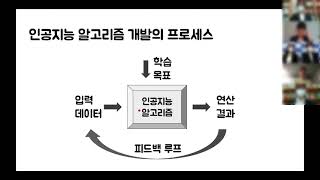
Kim Jin-young examines AI's benefits and dangers, showing how personalization algorithms deepen political polarization and how human bias transfers into hiring systems. She traces the problem through data input, training goals, algorithms, and feedback loops, then proposes data literacy education and explainable AI as safeguards.
Chapters
안녕하세요, 참가자 여러분. 지금부터 키노트 스피치를 시작하도록 하겠습니다. 우선 저희는 이번 키노트 스피치의 사회를 맡은 김진아, 김지은입니다. 연사님의 강연에 앞서 먼저 키노트 스피치의 취지와 내용을 간략히 브리핑하고 연사님을 소개하는 시간을 갖도록 하겠습니다. 짧게 진행할 예정이니 부담없이 들어주세요. 키노트 스피치란 대주제에 대한 전반적인 지식과 참가자 여러분들께서 이후 강연을 들을 때 염두에 두시면 좋을만한 내용들을 전달하는 세션보다는 조금 짧은 강연입니다. 제15회 SM 페어 컨퍼런스 정보, 사회를 바꾸는 파동의 포문을 여는 강연인 키노트 스피치의 주제는 지금 화면에 보이시는 것과 같이 인공지능 시대의 빛과 그늘 그리고 데이터 리터러시입니다. 이번 강연에서는 김진영 연사님께서 강연해 주시겠습니다. 김진영 연사님께서는 현재 스냅 본사의 데이터 과학자로 재직 중이시며 마이크로소프트 본사의 빙 검색 엔진 부문 연구자로 근무하시며 데이터 과학과 관련한 다양한 업무를 맡으시기도 했습니다. 자세한 양력은 TFT 화면을 참고해주시기 바랍니다.
안녕하세요. SM 페어 컨퍼런스 참석자 여러분. 저는 키노트 스피커를 맡은 김진영입니다. 소개를 잘 해주셔서 제가 더 할 건 없을 것 같고 저는 컴퓨터 사이언스 공부를 하고 데이터 사이언스 그리고 인공지능 검색 관련된 일을 했고 그다음에 이런 식으로 조금 제가 배운 내용 공유한다든가 하는 걸 좋아합니다. 그래서 오늘은 인공지능 딥러닝 얘기를 좀 해볼 텐데요. 사실은 굉장히 많은 관심을 가지신 주제고 그래서 사실은 보통은 이제 인공지능이 굉장히 좋다 뭐 우리나라가 굉장히 IT 강국이 되어 가고 있다 이런 식의 말씀을 들으셨을 텐데 사실 한국이 굉장히 인공지능에 대한 관심이 거의 세계적인 수준입니다 제가 이제 데이터를 다룬 사람이다 보니까 데이터로 말씀을 드리자면 여기가 이제 한국 검색 트렌드를 구글에서 꼽아본 건데요 알파고와 이세돌의 격돌이 이때 있었죠. 그 이후로 이제 원래는 인공지능보다 빅데이터가 훨씬 더 관심을 갖는 검색어였는데 이때를 이후로 인공지능이 완전히 초월을 했죠. 그래서 이제 우리나라가 이런 상황이고 데이터 사이언스라는 단어는 사실 거의 관심이 없으신 것 같아요. 근데 이제 검색어를 전 세계적으로 보면 사실은 트렌드가 굉장히 다르거든요. 빅데이터가 아직도 굉장히 위에 있고 그 다음에 여기 아티피셜 인텔리전스가 올라가고는 있지만 최근에 오히려 데이터 사이언스가 인공지능, AI보다 더 많이 검색을 받고 있죠. 그게 사실은 저는 이 트렌드를 알려주는 것은 우리나라 굉장히 인공지능에 관심이 많다. 특히 이제 그 중에 딥러닝에 관심이 많으세요. 그래서 딥러닝이 머신러닝보다 우리나라의 경우에는 검색어가 순위가 높고요. 전 세계적으로는 그게 반대거든요. 그래서 그게 어찌 보면 우리나라가 굉장히 트렌드를 앞서가고 새로운 기술을 빨리 받아들이고 그런 건 참 좋아요. 그렇죠? 근데 그게 꼭 좋은 점만 있느냐. 저는 인공지능의 일탈이다 이렇게 표현을 할 수 있는 것 같은데 사실은 저 같은 경우에 기술 쪽으로 일을 하다 보니까 인공지능의 어떤 부작용이나 위험성에 대해서도 굉장히 생각을 하는 편이거든요. 최근까지는 아마 인공지능이 좋다, 좋은 점만 많이 보셨을 텐데 그래도 이제는 좀 더 인공지능 위험성에 대해서 생각해 보실 때가 된 것 같아요. 예를 들어서 소셜미디어로 뉴스를 접하시는 분들 같은 경우에는 본인의 견해와 맞는 기사만 접하게 되시는 그런 현상이 있죠. 그게 말하자면 좋은 의미에서 개인화 시키는 작업인데 콘텐츠를. 근데 사실은 개인화라는 게 사용자들이 콘텐츠를 더 많이 즐기는 데는 도움이 될 수 있을지 모르겠지만 본인의 성향에 맞는 특히 정치적인 관점에서는 본인의 정치 성향에 맞는 기사만 보게 되는 그런 결과를 낳게 되고 그게 이제 사회적으로는 극단화되는 거죠. 좌파 우파가 이제 서로 극단화되면서 서로를 정말 심지어는 이제 서로의 존재를 막 존재 자체를 굉장히 싫어하는 그런 결과를 낳지 않나 그런 연구 결과도 있었고 실제로 미국에서 제가 보여드린 이 차트는 미국의 민주당과 공화당, 양대 정당이죠. 지지자들이 서로 얼마나 현향되어 가는지 그거를 보여주는 차트인데 94년과 2014년은 별로 변화가 없죠. 둘이 성향이 많이 겹칩니다. 근데 2014년을 보시면 굉장히 많이 분리가 됐죠. 그게 이제 2014년 같은 경우에 사실은 소셜미디어가 아주 지금처럼 위사를 떨치는 시기는 아니었는데 그래도 굉장히 많이 양극화가 이루어진 걸 볼 수 있습니다. 그리고 이게 심각한 이유는 단순히 그냥 서로 견해가 다른 게 아니라 서로 싫어해요. 그래서 민주당 지지자들이 공화당을 얼마나 싫어하는지 공화당 지지자들이 민주당을 얼마나 싫어하는지 보시면 계속 올라가고 있습니다. 서로 싫어하고 아주 싫어하는 그런 사람들의 비율이 물론 이게 단순히 소셜미디아가 이걸 만들었다 이렇게 단순화할 수는 없지만은 이런 트렌드와 소셜미디아의 등장이 굉장히 시기적으로 겹치다 그런 의미에서 조금 어느 정도 이제 소셜미디아를 그리고 이제 개인화된 알고리즘을 이런 현상의 원인으로 생각해 볼 수 있다 이런 말씀을 좀 드리고요 그다음에 최근에 인공지능 하면 이루다죠, 이루다. 이루다 얘기를 안 할 수가 없는데 저도 미국에 있다 보니까 정확하게 제가 한번 써보긴 했어요. 그렇지만 정확히 어떤 문제가 있는지는 여러분들이 아마 더 잘 아실 것 같은데 동성애를 혐오한다. 그리고 개인정보를 막 갖다 썼다. 이런 식으로 문제가 됐었죠. 그래서 왜 이런 일이 일어났냐 인공지능에서 그런 그런 아마 의구심 가질 수 있을 것 같고요 마지막으로 아무래도 이제 지금 다 대학생이시면은 그 취업에 대한 관심이 높으실 텐데 그럼 이제 ai 면접에 대해서 아마 고민을 하시는 분들도 있으실 것 같아요 이제 그게 기업의 입장에서는 이제 비용을 줄일 수 있다 뭐 그런 식으로 이제 광고가 되는 것 같은데 과연 이게 그 결과가 공정한가 AI 면접에서 우리가 잘 알리면 어떻게 해야 되느냐 이런 부분에 대해서 스터디도 하시고 과외도 하시고 한다는 얘기를 들었는데 이런 게 사실은 어떤 잠재적인 문제가 있을 수 있느냐 그런 고민 아마 좀 더 와닿으실 것 같아요 이런 종류의 문제는 그래서 오늘은 사실은 인공지능이 그렇다고 저는 나쁜 기술이다 이렇게 말씀드리려는 건 아니에요. 하지만 기술의 어떤 가늠성과 함께 잠재적인 불작용을 명확히 이해해야 되는데 특히 인공지능 같은 경우에는 굉장히 큰 잠재적인 위협이 있어요. 그래서 그걸 알아볼 건데 우선 인공지능의 본질에서 시작을 해보려고 합니다. 제가 생각하는 인공지능의 본질은 우선은 입력 데이터가 있고요. 그 다음에 거기에서 또 학습 목표가 있어요. 인공지능이라는 게 그냥 데이터에서 무작정 패턴을 찾는 게 아니라 이런 패턴을 찾고 싶어요. 이런 식으로 개발자들이 목표를 보통 지정을 해요. 그래서 이 목표가 있고 마지막으로 이제 목표를 가지고 학습된 알고리즘이 보통 새로운 데이터에 적용이 되죠. 예를 들어서 조금 제 사례를 좀 이따 살펴볼 텐데 이 인공지능 개발의 프로세스 관점을 살펴보면 같은 얘기인데 입력 데이터가 그리고 학습 목표와 함께 알고리즘을 만드는 데 사용이 되고 그 다음에 이 학습 알고리즘이 어떤 새로운 데이터를 적용된 연상 결과가 보통 마지막에 피드백 루프가 있어요. 연상 결과가 평가가 되고 그것이 바로 다시 입력 데이터 혹은 학습 목표를 설정하는데 반영이 됩니다 그래서 이런 그 순환 구조가 인공지능 개발의 프로세스라고 할 수 있고요 그러면은 이 사례를 다시 한번 살펴볼게요 이 프로세스 관점에서 우선은 소셜미디아의 뉴스비드는 입력 데이터의 경우에는 사용자 클릭 데이터라고 볼 수 있고 그 다음에 학습 목표는 보통은 대부분 소셜미디어 회사는 광고 회사에요 그래서 이제 여러가지 광고가 컨텐츠와 함께 뜨죠 그래서 광고 클릭 혹은 재방문율을 높이는 학습 목표를 보통은 세우고요 여기서 이제 그 문제가 되는 거는 중독성이 높은 컨텐츠 그러니까 그 사용자들이 좀 더 반응하는 오래 머무는 컨텐츠를 보여주다 보면은 개개인의 편향이 강화된다 양극화가 일어난다 정치적으로 예를 들어서 그 다음에 이제 또 중독을 일으킬 수 있죠. 재방문율을 극대화했을 경우에 사용자가 입장에서 그게 중독이 되는 거죠. 그런 부작용이 나오는 것이고 그 다음에 AI Chatbot 같은 경우에는 대화 기록 입력 데이터고 확산 목표는 여러 가지가 있을 수 있겠지만 흥미있는 답변, 그리고 최대한 인간 같은 답변을 생성해야겠다. 그런 식의 목표를 세울 수가 있는데 그런 경우에 사실은 입력 데이터 자체가 대화 기록이고 제가 알기로는 카카오톡 대화를 썼다고 해요. 그러면 이제 카카오톡 대화에 들어간 어떤 종류의 편견이 학습이 되는 거죠. 그게 이제 동성애에 대한 편견 이런 식의 결과로 나타날 수 있는 겁니다. 그리고 이제 마지막으로 AI 면접 같은 경우에는 과거 면접 결과가 입력 데이터가 될 수 있을 것이고 보통은 AI 면접을 최종 합격 단계에서 쓰지는 않는 것 같죠? 그래서 1차 선발을 AI 면접을 통해서 하고 그 다음에 최종 면접을 사람이 한다고 치면 최종 합격 결과가 가능성이 높은 사람들을 선발하는 것이 효율성 면에서는 좋겠죠. 그래서 그게 학습 목표라고 하면 이 상황에서도 입력 데이터가 기존 체험 담당자들의 판단 결과이기 때문에 기존 사람들의 편향이 그대로 들어간다는 거죠. 특정한 지역, 성 혹은 출신 학교가 될 수도 있고 사람들의 편향이 그대로 알고리즘에 들어간다는 겁니다. 그래서 어찌 보면 제가 방금 말씀드렸던 그런 부작용들은 예상이 되는 거예요. 이런 입력 데이터, 학습 목표를 가지고는 그런 부작용이 일어날 수밖에 없는 겁니다. 어쨌든 이게 그러면 왜 문제인가 생각을 해볼 수 있죠. 우선 인공지능이 당연히 이제 아마 귀가 아프게 들으실 텐데 인공지능이 미래다. 모든 인간을 대체한다. 이런 식으로 얘기를 하는 사람들이 요새 많죠. 그래서 저는 꼭 동의하지, 인간을 대체한다 이런 말은 동의하지 않지만 그 사회적 영향력과 그 분야가 그 적용 분야가 확대 일로 있는 건 맞습니다. 그래서 중요한 문제고요. 그 다음에 이제 또 인공지능의 편향 이런 얘기를 들으면 아니 사람이, 사람도 편향이 돼 있는데 왜 알고리즘이 편향되는 게 문제냐 이렇게 보통 생각, 이렇게 말씀하시는 분들이 계세요. 이번에 이루다의 경우에도 아니 뭐 사람들이 저기 그렇게 얘기한 거 그냥 듣고 얘기하는 건데 왜 우리가 문제를 삼냐. 근데 이제 사실 저는 그 사람이 그 어떤 몇몇 사람들이 편향된 거랑 인공지능이 편향은 좀 다른 차원인 것 같아요. 왜냐하면 사람들의 편향 같은 경우에는 그 영향이 굉장히 제한적이죠. 그 편향된 사람이 예를 들어 5%라면 그 5%를 아는 사람만 영향을 받겠죠. 하지만 그 챗밭이 예를 들면 편향된 답변을 하고 그 챗밭과 100만 명이 대화를 한다. 그 100만 명이 영향을 받는 거예요. 그렇죠? 그런 의미에서는 인공지능의 편향은 훨씬 더 특정 개인의 편향보다는 중요한 훨씬 더 중요하게 심각하게 생각을 해야 된다. 이런 말씀을 드리고 싶고요. 그 다음에 이제 이런 문제 해결이 어려운 이유는 인공지능이 사실은 내가 이렇게 동작해요 이렇게 알려주는 게 아니죠 예를 들어 뭐 예를 들어 페이스북 가보시면 뭔가 추천 결과가 쭉쭉 뜨는데 그게 어 왜 내가 이걸 추천했냐 추천 받는지 알기가 어렵죠 그리고 AI 면접의 경우에도 왜 당신은 뭐 떨어졌습니다 이런 식으로 제가 써보진 않았지만 상세히 설명해 줄 것 같진 않아요. 그게 여러 가지 이유가 있는데 영업기밀일 수도 있고요. 그 다음에 이제 인공지능의 메커니즘을 정확하게 얘기를 했을 때 인공지능을 사용하는 사람들이 그거를 악용할 수 있거든요. 예를 들어 AI 면접 같은 경우에 내가 이렇게 하면 떨어진다 이런 종류의 사례가 계속 보도가 되다 보면 사람들이 이제 지원자들이 그거를 이제 활용해서 이제 면접 준비를 굉장히 잘해갈 수 있죠. 그런 경우에 이제 면접 변별력이 떨어지는 문제가 있을 수 있죠. 그래서 간단한 문제는 아닙니다. 이게 보통 인공지능이 그래서 블랙박스다 이런 얘기를 하는데 인공지능의 그런 불투명한 걸 투명하게 하는 노력도 필요하지만 투명하게 되게 어려운 부분도 있고 해서 좀 어려운 부분이 있습니다. 네, 어쨌든 어렵다고 포기할 수 없는 중요한 문제라고 제가 말씀을 드렸고요. 그럼 이제 해법에 대해서 조금 생각을 해볼 텐데 우선은 편향이나 공정성 이런 얘기를 제가 이미 드렸는데 사실 이걸 정의하는 것 자체가 그렇게 간단한 문제는 아닙니다. 그 정의에 대해서 조금 생각을 해보고 그럼 이제 그 다음에 기술적인 해법 기술적인 해법, 마지막에 조금 차원을 넓혀서 미래를 어떻게 준비해야 되냐 이런 얘기까지 해보려고 합니다. 그래서 지금 공정성에 대해서 조금 더 말씀을 드려볼게요. 공정성, 그쵸? 이 반대말로 편향이 없는 상태로 공정하다고 할 수도 있는데 사실은 그게 굉장히 다양한 관점에서 적용, 정의될 수 있는 문제가 같습니다. 예를 들어 어떤 집단 간의 공정성이냐, 집단의 공정성, 예를 들어 남녀, 그리고 지역,
아니면
미국 같은 경우에 인종이 될 수도 있고요. 각 그 중고 집단에 따라서 공정성의 어떤 관점이 달라질 수 있고 그리고 당연히 개인 간의 공정성도 정의할 수 있겠죠. 그 다음에 이제 공정성의 어떤 구현 방식의 관점에서는 공정한 기회를 주면 된다. 아니면 모든 개인이나 집단이 같은 결과를 갖는 게 공정성이다. 이렇게 생각할 수도 있고. 마지막으로 이제 공정성이라는 게 보통 의사결정을 할 때 사회적 의사결정에서 한 가지 고려사항이지 그게 유일한 고려사항은 아니죠. 효율이나 아니면 어떤 기업의 경우에 영리추구나 다른 목표랑 충돌하는 경우에 균형점을 어떻게 잡아야 되냐 이런 문제가 있습니다. 그래서 결론적으로는 사실은 뭐가 올바른 일이냐 사회적 공감을 이끌어내기 자체가 쉽지가 않아요. 다른 말로 하면 굳이 알고리즘을 안 따지고 사람들끼리 공정한 해결책을 찾아 봅시다 하는 것도 쉽지 않다는 거예요. 그런 의미에서는 알고리즘의 공정성을 얘기할 때 기술자들만 모여서 알고리즘의 공정성을 높였다 이렇게 얘기할 수 없다는 겁니다. 예를 들어서 기술자들이 어떤 종이의 공정성을 사용하느냐 그런 부분이 사회적인 합의가 없이는 사실은 공정성을 이야기한다는 게 사실은 어불성설이 되는 거죠. 그래서 그러면 이게 공정성이라는 게 정의의 어려움에 대해서 조금 더 설명을 드리기 위해서 제가 대출 심사하는 사례를 조금 가져왔어요. 이거는 사실은 구글에서 발표한 논문과 그다음에 시각화의 일부인데 제가 링크가 여기 있으니까 나중에 발표 자료를 한번 살펴보시고요. 여기서 이제 각 대상이 되는 거는 X축이 여기서 이 그래프 X축이 신용 점수가 됩니다. 그리고 이제 여기서 동그라미가 신용 점수를 가진 각 개인이고 그다음에 여기서 두 가지 컬러가 있죠? 어두운 색이 이제 실제로 대출을 갚을 사람들 그리고 밝은색이 대출을 못 갚을 사람들 여기서는 이제 그 저희가 이제 이 사람 각 개인이 이제 대출을 갚을지 못 갚을지에 대한 그 정보는 저희가 갖고 있다고 생각을 하고 이 개인들에 대한 대출 심사 결과를 저희가 그리고 그 공정성을 생각을 해보는 겁니다 그래서 여기서 보통 생각을 할 때 그러면 이제 공정하다는 게 뭔가 생각을 해볼 수가 있죠 가장 쉽게는 이제 그러면 공정한 결과는 모든 사람한테 같은 기준을 적용한 공정한 게 아니냐 생각을 할 수가 있죠 여기서 이제 그 50 이렇게 딱 해가지고 이 오른쪽은 신용점수가 50점 이상이면은 대출 승인 이하면 대출 안해주고 이렇게 하면 될 것 같죠 그죠? 이게 그 결과가 이제 여기 제가 설명을 여기다 해놨는데 이거는 이제 사실 좋은 출발점이죠. 같은 기준으로 적어도 이제 어떤 특정한 집단을 차별하지 않는 것 같은데 그런데 이제 사실은 이거를 이제 데이터를 조금 나눠서 생각을 해봅시다. 두 가지 그룹이 있다고 생각을 하고 예를 들어 오렌지가 조금 더 사회적 약자예요. 미국의 경우에 흑인이 될 수도 있고 그런데 오렌지를 보시면 오렌지 집단의 신용점수 분포를 보시면 조금 더 왼쪽으로 치우쳐 있어요. 블루의 경우에는 신용대출 기준이 되는 55점이에요, 여기서는. 55점의 왼쪽 오른쪽에 비슷한 비교적 이제 같은 수의 사람들이 분포되어 있고 오렌지의 경우엔 왼쪽에 더 많아요 그쵸? 여기서 의미하는 거는 저희가 이제 같은 기준을 55점이랑 같은 기준을 이제 블루와 오렌지 공통적으로 적용을 했을 때 오렌지 집단의 사람들이 론을 받을 확률이 줄어들어요 왜냐하면 이 사람들의 전반적으로 시중 점수가 낮기 때문에 그러면 이제 그런 상황에서 이제 어떤 분들은 아니 그래도 우리가 같은 조건으로 했는데 왜 그게 문제가 되냐 그렇게 생각을 하실 수가 있죠. 하지만 이제 그 기회의 균등에 보면은 여기서 이제 중요한 거는 이제 같은 기준을 적용을 했을 때 블루의 경우에는 여기 아까 말씀드렸듯이 그 짙은 색깔에 있는 사람들이 대출을 갚을 사람들이에요. 갚을 사람들 중에서 대출을 실제로 허가받은 사람이 비율이 블루의 경우에 예를 들어 한 80%가 되죠. 대부분의 사람들은 블루 파퓰리에이션에서 대출을 받았어요. 실제로 롤을 페이한 사람들이. 근데 오렌지 그룹에서는 실제로 나중에 롤을 페이한 사람들 중에 절반 정도 많이 대출을 받았어요. 여기서 의미하는 거는 내가 예를 들어 오렌지 그룹이야. 그러면 내가 능력이 있는데도 내가 대출을 받을 수 있는 확률이 절반밖에 안 된다는 거예요. 뭔가 이상한 것 같죠. 그게 이제 어떤 의미에서는 기회의 균등을 보장하지 않는 거예요. 같은 그룹별로 그룹의 관계 없이 같은 기준을 적용하는 게 왜냐하면 이제 특정한 사회적 집단마다 어떤 이런 신용 결과, 얼핏 공정해 보이는 신용 점수마저도 공정하지 않을 수가 있는 거예요. 따라서 그 공정하지 않은 점수를 가지고 같은 잣대를 들이대면 이렇게 공정하지 않은 결과가 적어도 기획윤등 관점에서는 나올 수 있다는 겁니다. 그래서 기획윤등을 보장하고자 하면 블루 집단에 좀 더 높은 기준을 적용을 해야 돼요. 이렇게 하면 두 집단이 여기 보시는 것처럼 적어도 돈을 갚은 사람들 기준에서는 같은 비율의 사람들이 대출 심자를 허가를 받는 걸 보실 수가 있습니다. 여기까지 제가 드리고 싶은 말씀은 동일한 기준이 공정한 기준이 아니다. 그런 거죠. 이 그림에서 사실은 아마 이해가 빠를 텐데 왼쪽을 보시면 키가 서로 다르죠. 사람들 키가 다른데 같은 높이에 받침대를 주고 오른쪽은 키에 따라서 다른 높이에 받침대를 준 거죠. 영어로는 사실은 왼쪽처럼 모든 사람을 똑같이 기계적으로 대하는 거를 equality라고 하고 보통 많이 자신을 단어고 오른쪽처럼 각 개인의 상황을 고려해서 결과적으로 좀 더 공정한 예를 들어서 야구를 모두가 볼 수 있는 그런 상황을 만들어주는 거를 엑크리라고 해요. 그래서 이 두 가지가 다른 개념이고 실제로 알고리즘의 공정성을 얘기할 때는 엑크리 관점에서 얘기를 해야겠죠. 왜냐면 이 왼쪽의 경우에 사실은 말하자면 사회적으로 좀 더 약자에 속하는 그룹이 이 그룹일 텐데 이 그룹의 사람들은 자기가 잘못해서건 아니건 간에 불평등의 어떤 불평등한 대접을 받아왔는데 그게 이제 이런 이런 식의 상황이 계속되면 불평등이 계속 계속 강화되는 거예요. 그렇죠? 그런 의미에서 사회적 불평등을 왼쪽의 경우에는 사회적 불평등이 강화되는 결과를 압고 오른쪽의 경우가 돼야지 액퀴리 혹은 액퀴러블이라고 해요. 이런 오른쪽의 상황을 그런 상황을 만들어줘야지 이제 그런 사회적으로 불평등이 해소가 되는 결과가 장기적으로 나오겠죠. 그래서 그 퀄리티랑 액퀴디의 차이를 조금 생각해보시는 것을 조금 말씀을 드리고 그 다음에 이제 다른 논점은 제가 아까 처음에 이 그림을 보여드렸을 때 여기서는 전혀 문제가 안 보이죠. 그러니까 이 전체적인 분포를 봤을 때는 괜찮은 특정한 Threshold를 정해서 대출 심사를 해주는 게 괜찮은 솔루션 같은데 이제 이게 그룹별로 이걸 봤을 때 이제 문제가 나오는 거죠. 그래서 데이터를 만약에 나중에 혹시나 이제 이런 비슷한 일을 하실 때 항상 이제 데이터를 전체적으로 보는 것뿐만이 아니라 이제 그 그룹별로 예를 들어 그 본인의 회사에서 만드는 알고리즘이 이런 계층별 어떤 그 차이를, 불평등을 이제 고착시킨 결과를 안 되면 좋지 않은 일이겠죠. 그런 의미에서 데이터를 이제 전체적으로 뿐만이 아니라 이런 집단별로 보는 게 굉장히 중요하다. 문제 해결의 출발점이다. 이런 말씀 좀 드리고 싶고요. 네, 그 다음에 그 다음에 조금 더 기술적인 해결책을 제가 말씀을 드리려고 해요. 시간이 30분인데 당연히 저는 기술적인 일을 하는 사람이다 보니까 인공지능 기술 자체에서 이런 편향의 문제를 해결할 수 있는 방법을 많이 고민하는데 우선은 제가 말씀드린 인공지능의 본질로 돌아가서 살펴보면 주어진 입력 데이터에서 그걸 정제함으로써 해결할 수 있는 방법이 있고요. 그 다음에 두 번째로 학습 목표 관점에서 학습 목표에다가 공정성, 투명성 이런 다른 가치를 추가하는 방법을 생각해 볼 수 있고 마지막으로 알고리즘의 결과물을 평가하고 문제를 그 단계에서 해결할 수도 있겠죠. 그래서 첫 번째 해결 방법, 즉 입력 데이터를 정제하는 해결 방법을 생각을 해볼게요. 우선 챗봇 사례에서 가장 쉬운 해결책은 비속어나 편견이 담긴 대화를 보고 대화를 다 데이터에서 없애는 방법을 생각해 볼 수가 있을 겁니다. 가능해요. 가능하지만 문제는 모든 대화를 다 일일이 사람이 봐야 된다는 비용의 문제가 있고요. 따라서 아주 현실적인 해결책은 아니고요. 그다음에 전처리 과정에서 머신러닝 모델이 그냥 동작하는 게 아니라 어떤 언어에 대한 이해를 머신러닝 모델에서 그러니까 형상을 한 다음에 그 언어에 대한 이해를 바탕으로 추천을 하거나 말을 생성하거나 그런 일이 이루어지는데 그 모델에서 입력 데이터를 전처리한 이후에 그 모델에서 언어적 편견을 제거하는 기법이 소개가 돼서 제가 지금 그거는 발표 슬라이드에서는 뺐는데 나중에 제가 슬라이드를 공개할 때 거기서 그 논문을 한번 참고하실 수 있도록 제가 넣어놓았고요 그 다음에 AR 면접 사례에서는 당연히 학습 데이터의 편견 몇 가지 문제가 있을 수 있는데 학습 데이터가 특정한 성별이나 지역, 출신 학교에 너무 집중되어 있을 수가 있고요. 그 다음에 학습 데이터에서 성별, 지역, 출신 학교에 대한 결과의 편향이 보일 수도 있고 그런 편향을 다 제거할 수 있어요. 그래서 이런 부분은 사실은 데이터 전처리를 잘 했을 때 보통 표본 추출이라고 하죠. 데이터를 전체를 그냥 다 쓰는 게 아니라 데이터가 예를 들어서 데이터에서 남자 지원자, 여자 지원자가 50%씩 나오도록 그런 표본 추출을 해서 사용을 한다면 적어도 데이터 양에 대한 어떤 불균형점은 해소를 할 수 있을 거고요. 그래서 실제로 입력 데이터의 유형과 애플리케이션에 따라서 데이터 정제가 가능할 수도 있고 가능하지 않을 수도 있어요 하지만 우선 데이터를 살펴봐야 됩니다 그래서 데이터를 살펴보고 데이터에 어떤 편향이 있을 수 있는지 그런 걸 살펴봐야지 문제를 이 방법이나 아니면 제가 말씀드린 다른 방법을 사용해서 해결을 할 수가 있습니다 보통 머신러닝 공부를 하신다면 데이터를 안 보고 그냥 모델만 예를 들어 텐서플로우를 실행해서 모델만 트레이닝해보고 결과가 나왔다 좋아하시고 그럴 수 있는데 데이터를 잘 보지 않으면 이런 공정성이나 다른 종류의 문제를 강구하고 넘어갈 수 있다 말씀을 다시 드리고요. 그리고 제가 아까 말씀드렸듯이 대부분의 머신러닝 기법은 특정한 목표를, 사용자가 설정한 목표를 최적화하는 방향으로 작동을 합니다. 따라서 학습 목표 자체에 공정성 혹은 다양성, 다른 기준을 추가할 수가 있고요. News Feed의 경우에 당연히 콘텐츠의 공정성을 알고리즘에서 제약 조건으로 추가할 수 있을 것 같고요. 그 다음에 AI 면접의 경우에도 성별, 지역, 출신 학교에 대한 차별이 일어나지 않도록 알고리즘을 수정을 할 수가 있을 겁니다 여기서 이제 그 당연히 이런 그 학습 목표 수정이 어 여기다 공정성을 그 뉴스피드 알고리즘의 공정성이라는 어떤 제약 조건을 넣었을 때 수익이라는 목표가 어 3충이 될 수가 있죠 가장 수익이 높은 알고리즘과 공정성이 높은 알고리즘이 다를 수 다르겠죠 보통은 그런 의미에서는 어 기업에서 내가 꼭 공정한 결과를 내야 된다. 수익을 좀 줄이더라도 이런 종류의 결의가 꼭 필요하고요. 교제기관에서도 이제 이런 각 기업들이 이런 종류의 사회에 대한 약속을 지키는지 뭐 그런 얘기를 그런 감사를 할 수 있겠죠. 그리고 이제 마지막으로 대부분 알고리즘의 결과가 평가가 되고 평가의 결과에 따라서 알고리즘이 새로 개선되기도 하고 문제가 수정되기도 하는데 보통은 평가에서 주요 지표가 있고 보조 지표가 있어요 주요 지표라는 것은 기업이나 기관의 미션에 관련된 예를 들어 뉴스 피드 같은 경우에는 사용자들의 체류 시간이나 재방문율이 굉장히 중요한 지표가 될 거고 사실 이런 지표는 무시할 수 없죠. 하지만 이제 제가 말씀드린 거는 보조 지표로서 이제 공정성에 관련된 지표를 사용을 해야 된다. 예를 들어 내가 특정한 사용자 그룹한테 예를 들어 보수 쪽 그룹한테 정말 100% 보수적인 청향의 뉴스 사이트만 추천을 했다. 그러면 사실 공정성 측면에서는 조금 문제가 있는 거죠. 굉장히 그 보수 정치적인 어떤 양극화를 초래할 수 있는 그런 결과이기 때문에 그런 문제를 적어도 인지할 수 있는 보조지표를 설정을 해야 될 거고요. 체포제 경우에도 대화기이나 재방문기 이런 것만 볼 게 아니라 얼마나 불건전한 답변이 있었는지 편향된 답변이 있었는지 이런 부분에 대해서 사용자 신고를 받을 수 있고 아니면 이제 표본 추출을 해서 그 데이터 표본에 대해서 이제 검증을 할 수도 있고요. 그런 다양한 방법이 있어요. 이런 보조지표가 없이는 사용자들이 더 올지는 모르겠지만 굉장히 이번에 이루다와 같이 많은 부작용을 초래할 수 있는 그런 서비스를 만들게 된다. 그런 말씀드리고요. 마지막으로 AR 면접의 경우에도 선별한 사람들이 얼마나 최종 사람들한테 합격을 하는지 당연히 중요하죠. 하지만 이제 실제 응시자들의 피드백 공정하게 대한다고 느꼈는지 예를 들어서 그 다음에 이제 성별, 지역, 집단별, 합격률 이런 종류의 지표를 같이 보지 않으면 굉장히 편향된 그런 알고리즘이 될 수 있다 이런 말씀드리고요 그래서 여기서 조금 더 구체적으로 검색 결과에 대해서 공정성에 대해서 말씀을 드리면 이것도 이제 논문화된 그런 연구인데요. 여기서 이제 다루는 상황은 구직자를 랭킹하는 검색 사이트에요. 그래서 뭐 내가 기업의 채용 담당자인데 구직자들이 내가 올린 포지션에 대한 구직자들이 얼마나 누가 있을까 이렇게 보는 검색 엔지니어라고 했을 때 그 여기서 이제 나온 사례는 3명의 지원자는 남성이고 3명의 지원자는 여성인데 남성과 여성의 직무 적합도에 관점에서는 거의 차이가 없어요 여기가 그게 파란색 바로 표시가 되어있는데 약간 높아요 남성이 근데 이 사례에서는 근데 사실 거의 차이가 없어요 하지만 만약에 이런 미미한 차이로 남성들이 만약에 남성 지원자가 여성 지원자보다 위에 올라갔다 그런 경우에 검색 결과의 노출 확률 관점에서는 굉장히 많은 차이가 나타나요. 그게 여기서 노란색 반대 보통 사람들이 검색 결과를 위에서 아래로 스캔하면서 사용을 하죠. 그래서 만약에 한 명을 뽑는데 제일 위에 있는 사람이 좋다 그러면 그 사람이 그냥 인터뷰를 받겠죠. 그런 의미에서 공정성을 고려하지 않은 검색 랭킹의 경우에는 굉장히 그 이 사례에서는 적어도 이제 남성 지원자들한테 훨씬 인터뷰 결과가 많이 가는 그런 결과가 나온다는 겁니다 따라서 이런 문제를 해결을 하려는 시도가 조금 있었는데요 크게는 알고리즘 면에서 해결할 수 있고 그 다음에 지표면을 해결할 수 있는데 첫 번째는 이제 검색 알고리즘을 개발을 할 때 그냥 검색 품질을 검색 품질을 평가는 조건 그러니까 검색 품질의 제약 조건으로 공정성을 추가를 하는 거죠 그래서 내가 꼭 사용자들이 더 많이 클릭할 결과만 찾는 게 아니라 검색 결과의 공정성을 고려를 하겠다 예를 들어 뭐 탑 6에 이 경우에는 아니면 탑 4에 적어도 남녀를 2명씩 넣겠다 이런 종류의 제약 조건을 추가를 함으로써 그 공정성을 고려를 할 수가 있다는 거죠. 그 다음에 이제 다른 측면은 이제 알고리즘은 일단 나왔고 검색 결과에 이제 지표를 품질을 평가하는 지표 관점에서 내가 공정하게 하고 있는지 그런 걸 얼마나 공정하게 하고 있는지를 지표할 수 있는데 예를 들어 이제 전체 그 구직자의 성비가 50%가 남성이고 50%가 여성이다? 그러면 이제 우리가 뭐 탑 뭐 4에서 여기 전체 3의 4명에서 남녀가 50%가 들어갔는지 아니면 남성만 들어갔는지 여성만 들어갔는지를 지표화할 수 있다는 겁니다. 그래서 그런 지표가 제가 여기 소개한 논문에 소개가 되어 있고요. 그래서 이제 요약을 하자면 인공지능 알고리즘이라는 게 입력 데이터가 들어가서 학습 목표가 최적화되는 방향으로 영상 결과가 나온다는 거죠. 따라서 이제 그 입력 데이터, 학습 목표, 알고리즘의 결과물 관점에서 다 이제 그 공정성이라는 품질의 기준을 높일 수 있도록 개선될 수 있다는 겁니다. 기술적인 면에서는 할 수 있는 일이 꽤 있어요. 그래서 이제 저 같은 사람들은 이제 그런 예를 들어 저희 스냅에도 이제 추천 시스템이 콘텐츠 추천 시스템인데 항상 정치적인 공정성이나 그런 부분에 대해서 고민을 하고 있고요 그 다음에 이제 비기술적인 해결책에 대해서 조금 생각을 해볼 텐데 비기술적인 해결책이 중요한 이유는 말씀드렸듯이 이제 일상에 이미 많은 인공지능이 들어와 있고 앞으로 더 많은 기업이나 정부 기관에서 더 많은 경우에 인공지능을 활용할 것 같아요. 그런데 말씀드렸지만 공정성이라는 게 칼로 무배듯이 쉽게 정의할 수 있는 게 아니에요. 그래서 항상 누가 공정성을 고려를 했는지를 어떤 관점의 공정성을 고려하는지 모든 사람이 사용자 관점에서 고민을 해야 된다는 얘기고 이거를 한번 조직과 개인 관점에서 알아보도록 할게요. 우선은 조직 관점에서는 인공지능의 윤리 기준 그런 이야기가 요새 많이 들리는데 예를 들어 제가 근무했던 MS에서는 최근에 인공지능의 윤리 기준이다 하고 이렇게 여러 가지를 내놨어요. 거기에 이제 뭐 Fairness, Safety, Privacy, Accountability, Transparency, Inclusiveness 이런 식으로 여러 가지 기준이 있고 우리가 이런 여러 가지 기준 척도에서 윤리적인 인공지능을 만들겠다 이렇게 얘기를 하고 있죠. 각 기업에서는 이런 식의 윤리 기준을 공표하고 실제로 지키고 정부에서는 이런 기준이 지켜지고 있는지 그런 부분을 확인할 수 있을 것 같고요. 개인 입장에서도 사실 할 수 있는 일이 굉장히 많아요. 여기서 데이터 리트러스라는 말이 중요한데 사실 저는 소비자라는 개념이 좀 좁은 의미에서 제품을 사는 사람이 소비자지만 인공지능, 예를 들어 어떤 앱을 사용하는 사람도 소비자잖아요. 그런 의미에서 내가 사용하는 제품이나 서비스에 인공지능이 어떻게 사용되고 있는지 소셜미디어 피드에 어떤 나오는 결과들은 다 인공지능이에요 뉴스 추천 서비스에 사용되는 결과 그 결과 다 인공지능이고 그런 서비스에 인공지능이 어떻게 사용되고 있고 인공지능이 사실은 개인이 관심을 가져야 되는 이유는 인공지능이라는 게 대부분 컨텐츠를 개인화하는데 사용이 되거든요. 그래서 전체적으로 잘 드러나지 않아요. 내가 말하자면 내가 나한테 주어진 결과가 얼마나 편향되어 있는지는 내가 가장 잘 알 수 있다는 겁니다. 그런 의미에서 내가 예를 들어 특정한 사이트를 봤는데 그 사이트에 나오는 컨텐츠가 나한테 굉장히 편향된 어떤 사고방식 가져온다 이런 종류의 인식도 굉장히 도움이 되는 서비스 개발하는 입장에서는 도움이 되는 피드백이 될 수 있고요. 당연히 사회적으로 이런 피드백이 모였을 때 그런 서비스의 어떤 공정성이 조금 더 제거될 수 있는 가능성이 생긴다고 말을 할 수 있을 것 같습니다. 예를 들어서 예전에 이거는 몇 년 된 차례이긴 한데 여기 이 학생이 이제 그 학부생일 때 얼굴 인식 알고리즘에다가 자기 얼굴을 넣어봤을 때 자기 얼굴이 안 되는 거예요. 근데 이제 본인이 하얀색 가면을 쓰니까 얼굴이 인식이 되는 거예요. 그게 이 학생이 굉장히 당연히 붕괴를 했죠. 그 다음에 이제 이거를 이제 뭐 그때 제가 알기로는 구글 얼굴 인식이었는데 구글한테 리포팅을 하고 그 다음에 나중에 이 학생이 실제로 그 알고리즘의 이제 공정성을 미국에는 흑백이 굉장히 큰 문제이기 때문에 확보하는 어떤 연구자 얘기를 걸어요 네 그래서 굉장히 많은 걸 바꿔놨어요 그래서 나중에 회사들이 다 사과를 하고 이제 흑인 백인한테 모두 작용 작동이 되는 그런 얼굴 인식을 내놓았죠 그래서 개인의 노력이 상당히 많은 걸 바꿀 수 있다. 이런 생각을 저는 하고요. 마지막으로 공정성 얘기는 제가 많이 드렸고 우리는 어떤 인공지능 시대라고 하는데 어떻게 준비를 할 수 있을까. 인공지능은 우선은 계속 좋아질 거예요. 인공지능 기술 자체도 발전하고 있고 인공지능이 필요로 하는 데이터도 양이 계속 많아지고 있고 품질도 좋아지고 있고 따라서 이제 사회의 그 더 많은 영역에서 데이터 인공지능 기술이 보편화 될 거고 근데 이제 제가 또 드리고 싶은 말씀은 그럼 모든 사람들이 인공지능 전문가가 돼야 되냐 모든 사람들이 다 전공을 바꿔서 컴퓨터 사이언스를 해야 되느냐 이렇게 물어보신 수도 있는데 오히려 기술이 발전하기 때문에 그런 인공지능 전공자가 덜 필요할 수 있다. 저는 그런 말씀을 드리고 싶거든요. 예를 들어서 최근에 사람들이 굉장히 연구자들이 많이 연구를 하는 게 오토 ML이라는 기술이 있어요. 이게 말하자면 인공지능 알고리즘을 완전 자동으로 개발을 해주는 거예요. 물론 여기에 여러 가지 제약 조건이 아직은 있는데 예를 들어 굉장히 많은 데이터가 필요하고 컴퓨팅 파워가 필요하고 하지만 기존에 인풋 데이터가 있고 아웃풋 데이터가 있고 이 사이에 들어간 여러 가지 프로세스가 있는데 이 가운데를 다 자동화를 해줘요. 그게 의미하는 거는 데이터 사이언티스트, 인공지능 엔지니어 이런 사람들이 할 일이 별로 없는 거예요. 적어도 이제 데이터 굉장히 많고 굉장히 많은 컴퓨팅 파워를 쓸 수 있다면 이런 식으로 자동화된 알고리즘을 가질 수 있다는 거예요. 그리고 이런 알고리즘 성능이 나쁘지가 않아요. 그게 의미하는 게 뭐냐. 저는 이제 항상 대한민국의 인공지능 딥러닝 붐을 당연히 저 같은 경우에 그쪽 전공을 그쪽 일을 하고 있으니까 굉장히 긍정적으로 보지만 항상 한편으로는 조금 걱정되는 게 모든 대학생들이 텐서플로우를 공부해야 될 것 같고 백프로포케이션의 증명을 알아야 될 것 같고 이런 종류의 강박관념 우리나라가 좀 그런 게 있잖아요 남들이 하면 나도 해야 될 것 같고 그런 생각을 하시지 않나 저는 생각을 하는데 제가 감히 인공지능 관련된 직업이 어떻게 바뀔지 예측을 한다면 지금 현재 그 2020년에 연구자, 데이터 엔지니어 과학자, 이 사람들이 합쳐가지고 다 전공자라고 할 수 있죠. 그 다음에 이제 기타, 기획자나 아니면 뭐 디자이너가 될 수도 있고 아니면 이제 뭐 데이터를 레이블 같은 걸 하는 사람들이 될 수도 있고 이런 사람들의 비율이 만약 이런 그러니까 전공자의 비율이 지금은 더 필요한 전공자의 비율이 비전공자보다 지금은 높다고 생각을 해요. 근데 이제 저 같은 경우에는 예를 들어 5년에서 10년 사이에 이 위에 전공자보다 비전공자들이 훨씬 더 많이 필요한 시대가 되지 않을까 저는 생각을 합니다. 물론 이렇게 정확한 수치를 들을 수는 없지만 제 느낌에는 왜냐하면 이 연구자들과 엔지니어들이 하는 일이 굉장히 예전보다 편해졌고 10명이 할 수 있는 일을 한 명이 할 수 있게 됐고 그런 의미에서는 모든 기업이 굉장히 큰 팀의 어떤 머신러닝 엔지니어를 가지고 있어야 되고 그런 건 아니라는 거죠. 그런 의미에서는 기술 자체를 개발하고 이런 사람들만큼이나 기술을 어떻게 잘, 그냥 인터널을 모르더라도 잘 쓸 수 있는 그런 사람들이 훨씬 중요해진다 저는 그렇게 생각을 하고 있습니다 그런 의미에서는 저는 이제 공부를 어떻게 해야 되냐 이런 생각을 하실 수 있는데 기술의 세부상보다는 내가 이 기술이 뭘 할 수 있고 이 기술이 왜 유용한지 이런 고민을 더 하시라고 생각을 말씀드리고 싶어요 그래서 그런 의미에서 예를 들어 뭐 한국의 예를 들어 텐서플로우 커뮤니티가 전 세계적으로 제일 커요, 거의. 참 좋은 일이에요. 근데 이제 그러면 이제 이 수많은 학생들이 딥러닝 기술을 공부를 텐서플로우라면 사실은 아주 저수준의 딥러닝 라이브러리인데 저수준이라는 건 이제 사용자가 해야 되는 게 굉장히 많아요. 그러니까 자동으로 해주는 게 아니라 다 일일이 이제 만져야지 결과가 나오는 수준의 라이브러리인데 그거를 공부한 노력이 일단 되게 많이 들고 중요한 거는 그게 계속 바뀌어요. 텐서플로우라는 게 1.0이 있고 1.2가 있고 2.0이 있고 계속 바뀌는데 1.0과 2.0이 완전 달라요. 그리고 텐서플로우가 처음에는 거의 독보적이었는데 요새는 파이톨치 이런 다른 딥러닝 알고리즘이 많이 그러니까 툴킷이 많이 등장을 했죠. 그런 게 계속 바뀌는데 이런 하우에 너무 천착을 하다 보면은 시간은 굉장히 많이 들죠. 왜냐면 내가 바뀌는 걸 다 따라잡아야 되니까 내가 실제로 나중에 뭔가 필요한 이걸 가지고 이제 뭔가 일을 해야 될 상황이 됐을 때는 그때 정말 정작 다시 배워야 될 확률이 되게 많아요. 제가 봤을 때는. 근데 이제 조금 더 하이레벨로 내가 이걸 왜 공부해야 돼? 이걸 뭘 할 수 있지? 이런 종류의 고민을 하던 분들은 조금 더 실제로 뭔가 인공지능 알고리즘 사용할 일이 생겼을 때 저는 좀 드리는 시간을 좀 줄일 수 있지 않을까 그리고 이제 필요할 때 필요한 만큼 공부할 수 있지 않을까 뭐 이런 생각을 합니다. 그리고 뭐 이거 다른 이건 조금 더 이제 뭐 구체적으로 뭐 요새는 뭐 논문도 있지만은 책도 있고 뭐 영상도 있으니까 같이 보시고 그 다음에 뭐 논문이랑 코드가 있는 걸 보시라 이건 조금 더 이제 좀 세부적인 얘기고 어쨌든 제가 드리고 싶은 말씀은 전공자면 당연히 좋고요. 인공지능 관련된 전공하시는 분은 그게 아니라도 굉장히 관련된 일을 할 수 있는 방법이 많아지고 장벽은 계속 줄어든다고 생각을 해요. 그래서 그런 의미에서 전혀 걱정하실 건 없고 하지만 관심을 갖고 계셔야겠죠. 계속 뭔가 인공지능 시대에서 뭔가 일을 하시려면 그런 메시지를 전하면서 마무리할까 합니다. 제가 사실 오늘은 시간 관계상 좀 더 하이레벨로 말씀을 드렸는데 제가 유튜브 채널에 좀 더 테크니컬한 발표 영상이 있고요. 그 다음에 제가 하는 팟캐스트에서도 굉장히 공정성 얘기를 많이 하고 있고 그 다음에 제가 말씀드린 관련 서적이나 아니면 넷플릭스에 있는 다큐멘털인데 한번 보시면 좀 더 세부사항을 아실 수 있지 않을까 생각을 합니다. 발표는 여기까지 하고