Presentation by Thibault Hussok (CAA Research Institute) describing a reproducible methodology to generate simulated 4D datasets for fault detection in district heating (DHC/AES-18) components. The workflow: identify candidate Modelica models from libraries, characterize features and fault-modelling ability, select or adapt models, then run randomized fault-injection simulations (example: boiler model from EXLIB). Dataset example: reference plus ~3×100 simulations across 13 operating series (~4,000 total) sampled at 5-minute intervals. Early ML tests (focused on a boiler HNC signal) show K-Nearest Neighbors achieving 0.99 accuracy for certain fault types; multi-fault detection (efficiency+heat loss) is less reliable.
Questions this video answers
Thibault Hussok, research engineer at CAA Research Institute.
CAA Research Institute, Institut Fraunhofer, project AIDHE (IEA-DHC).
13 boiler models in 9 Modelica libraries.
Approximately 3×100 simulations per condition across 13 series (nearly 4,000 simulations) with a 5-minute sampling interval.
K-Nearest Neighbors (KNN) with reported accuracy of 0.99.
Chapters
Bonjour à tous et bienvenue à cette présentation. Je m'appelle Thibault Hussok, je suis ingénieur de recherche au CAA Research Institute et je vais présenter mon travail sur la génération de simulation 4D data sets pour détection de réseaux AES-18 en utilisant l'apprentissage de machines. Cette étude est connectée avec Nicolas Lamaison et Mathieu Vallée au CAA et avec l'Institut Fraunhofer en tant que partenaire du projet IEA-DHC. Tout d'abord, les réseaux déstructeurs, comme tous les systèmes techniques, sont subjectifs à des dysfonctions durant leur espace de vie. Leurs erreurs sont souvent inattentives, en particulier dans les réseaux et dans les substations, comme déclaré par Werner et Hall. Pour améliorer leur efficacité, il est important de développer des méthodes de détection et de diagnostic de erreurs robustes. L'intelligence artificielle et l'algorithme de l'apprentissage machines peuvent offrir de significants bénéfices dans la détection, mais seulement si l'information est disponible dans suffisamment de diversité et de créativité. Ici, dans le projet AIDHE, fondé par IEADHE, nous souhaitons offrir à la communauté un dataset de référence pour l'étude de détection et de diagnose dans les systèmes DH. Nous allons considérer les données générées par la simulation des modèles Modeleka comme une base propre pour l'entraînement des modèles machine learning. La performance des modèles machine learning sera également assistée ainsi que transférée aux systèmes réels dans deux étapes. Pour cela, dans la présentation, je vous présenterai la méthodologie de génération données. Ensuite, je vous présenterai quelques détails sur le modèle et la génération de données pour un exemple. Ensuite, je vous fournirai des résultats rapides sur les modèles machine learning et pour la détection.
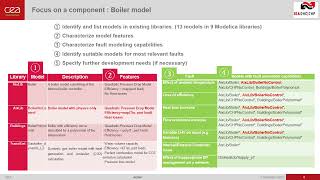
L'objectif de la méthodologie pour la génération d'enregistrements de erreurs est de sélectionner des modèles adéquats pour les simulations d'erreurs, et nous assumons ici que chaque composant DHE a un storage ou un boiler considéré indépendamment. Cela signifie que les erreurs seront simulées sur chaque composant. La méthodologie est composée de 5 étapes. D'abord, nous identifions et relâchions le modèle dans les librairies existantes, qui sont les librairies modéliques. Ensuite, nous identifions les features de chaque modèle. Ensuite, nous correctivions la capacité de modélisation erreur du modèle. Nous identifions les modèles adéquats pour les erreurs les plus relevantes et nous identifions les besoins de développement dans le modèle, si nécessaire. Donc ici, sur cette table, vous pouvez trouver toutes les librairies existantes utilisées pour identifier et lister chaque modèle de composant DHC.
Je vais vous décrire la méthodologie sur un exemple, qui est le modèle Boiler. La première étape est la liste des modèles existants pour le Boiler. Nous avons trouvé 13 modèles dans 9 librairies Modeca.
Comme vous pouvez le voir et extraire ici sur cette table. Ensuite, nous caractérisons chaque modèle par ses features, par exemple, comment l'efficacité est calculée, le modèle de dépression ou si ses pertes sont considérées ou non. Ensuite, pour chaque erreur identifiée et potentielle, par exemple, l'effet de température ambiante ou la perte d'efficacité, qui sont listés ici. Nous caractérisons pour chaque modèle la capacité de modélisation de faute. Basé sur ces éléments, nous identifions le modèle adéquat et pour notre cas, nous avons choisi le modèle boiler non contrôlé de l'ensemble Xlib.
Nous avons appliqué le même processus sur chaque composant DHE, le boileur comme nous l'avons vu auparavant, l'hélicoptère et le réfrigérateur, la plante thermique solaire, le réseau qui est composé de tuyaux, valves et pumps, la substation et le modèle de stockage d'eau chaude. Et pour chaque modèle, nous avons identifié deux ou trois plis à être simulés et une petite liste de modèles. Les modèles viennent de ExLib pour les boîtiers et les pompiers, et d'Ipsa pour les réservoirs d'eau chaude. Pour les plantes thermiques solaires, les réseaux et les substations, les modèles viennent de notre libraire privé pour des raisons d'efficacité. Mais ces modèles seront révélés comme modèles d'open source dans le futur.
Voici une autre vue sur le component Boiler et le framework d'assimilation des fautes. Nous trouvons ici le Boiler de la bibliothèque EXFIG, le modèle Boiler non contrôlé, qui est modifié pour assimiler les fautes dynamiques sur l'efficacité, qui est basé sur le chargement de pièces et la température d'entrée, et pour assimiler les fautes sur les déchets de chaleur. Nous avons également ajouté un bruit random sur le niveau de chaleur basse du gaz afin d'introduire de la viabilité dans le résultat. et le composant est subject à des conditions bondaires qui sont l'épaisseur de masse d'entrée et la température d'entrée et aussi la température d'application et le boileur est régulé par la température d'application avec un contrôleur. Le boileur peut être lié à des erreurs sur la conduite thermique et à des erreurs sur l'efficacité nominale. Les erreurs sont simulées grâce à une base Python pour générateur. Nous définissons le type de profil de l'erreur, qui est soit une étape, soit une rampe. Nous définissons son temps d'entrée, donc quand l'erreur apparaît, et son intensité, qui dépend du modèle et du type d'erreur. L'intensité est entre 0 et 1. 0 signifie qu'il n'y a pas de erreur et 1 signifie la maximum d'intensité disponible. Ici, nous utilisons des paramétres random pour générer les erreurs afin d'éviter trop régulièrement en utilisant l'algorithme de machine learning. Pour chaque condition de liens, ici nous avons 13 séries de temps, nous avons une simulation de référence sans erreur, et nous avons 3 fois 100 simulations, nous avons voté sur l'efficacité, les dégâts de chaleur et les deux, et nous avons presque 4000 simulations avec un sampling de 5 minutes.
Ici, vous pouvez voir des résultats sur les composants Boiler pour deux simulations différentes.
Cette figure compare un boulevard sans erreur en bleu et le même boulevard où deux erreurs apparaissent successivement. D'abord, un inclusif de ses pertes sur ce graphique, puis une efficacité d'erreur abrupte d'environ 10% sur ce graphique. et le graphique top-bottom montre l'impact sur le pouvoir d'énergie et sur la consommation d'énergie. Nous pouvons voir que seulement la forte déficience d'électricité est remarquable en observant l'impact sur le pouvoir d'énergie, et nous pouvons aussi voir l'impact des noeuds random sur le niveau de chaleur basse de l'énergie et la consommation de gaz. Nous espérons que l'algorithme de machine learning sera capable de détecter et de distinguer ces défauts, en particulier les défauts et les dégâts de chaleur.
Enfin, voici quelques résultats très tôt sur l'application de l'algorithme de machine learning pour la détection des erreurs. Nous avons testé différents algorithmes de machine learning, principalement sur le boiler HNC, pendant une heure. Si vous vous concentrez sur le boiler, les résultats sont bons pour la détection des erreurs sur HNC. L'algorithme le meilleur est KNN, K-Nearest Neighbors, avec une précision de 0.99. Vous pouvez voir des résultats plus détaillés à droite de la table pour 4 différentes erreurs sur le HNC. 1 rampe et 3 pas. La courbe bleue correspond à la valeur actuelle du boileur HNC et la courbe grise correspond à la courbe du boileur N, 1 si il y a une erreur et 0 si non. En vert est la détection correcte détectée par l'algorithme et en rouge est la détection incorrecte. Comme vous pouvez le voir, la plupart des points sont correctement détectés parce qu'ils sont et les points rouges sont concentrés au début du flambeau, en particulier quand c'est une rampe. On attendait ce résultat parce que le flambeau est encore mineur à ce moment. Et on peut aussi voir un point à cause de l'impact de la hausse du prix de gaz. Nous travaillons encore sur les autres défauts et les autres components, mais nous avons déjà vu que la détection de déchets et d'éfficacité en même temps n'est pas aussi bonne que la détection de l'éfficacité seule. Pour conclure, nous avons développé ici une approche reconductible pour 4 générations de composants DHE de base de données, et les simulations relient un modèle open source des libraires Modelica.
Nous avons fourni un dataset de référence pour 4 databases de plusieurs dizaines de millions d'instances et nous avons appliqué l'algorithme machine learning pour la détection de erreurs d'efficacité Bollier. Dans le futur, nous publierons les scripts Python pour la simulation d'erreurs et le dataset dans un repositoire public, comme Kaggle ou GitHub, et nous voulons améliorer la détection d'erreurs avec la machine learning et extendre les résultats aux autres components DHC que nous avons dans notre réseau. Merci pour votre attention.